본문으로 건너뛰기
ToolPotion
AI 어드바이저
제출 (무료)

Throttle

AI 앱MLOps 및 모델 배포#193프리미엄 · OpenAI 호환

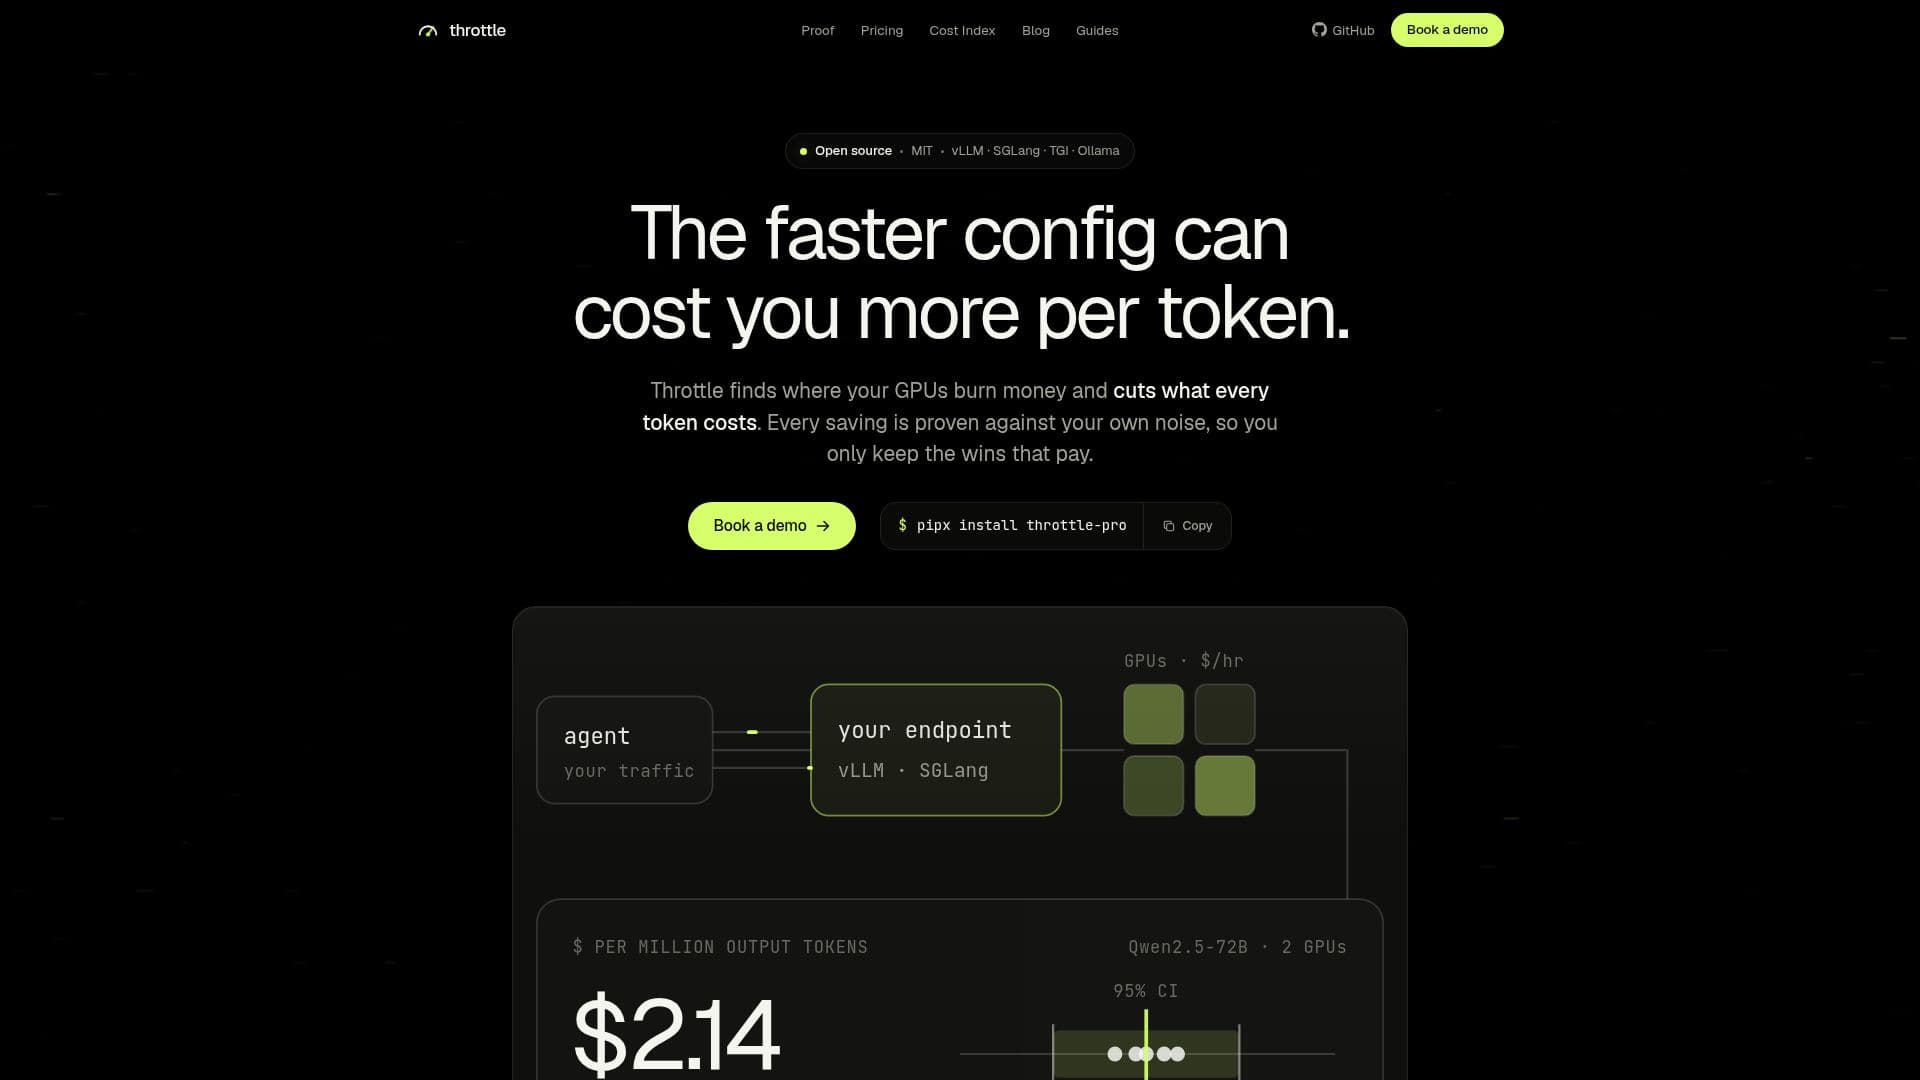
Throttle는 비효율적인 서비스 구성을 식별하여 GPU에서 AI 추론 비용을 최적화합니다. 이는 백만 토큰당 달러로 절감 효과를 제공하여 비용 효율적인 AI 운영을 보장합니다. 다양한 AI 서버와 호환되며, 오픈 소스 CLI와 무료 2개월 파일럿을 제공합니다.

URL 방문
공유
Throttle 스크린샷
Throttle 스크린샷

Throttle은 소유하거나 임대하는 GPU에서 AI 추론과 관련된 비용을 줄이기 위해 설계된 도구입니다. 이는 비효율적인 서비스 구성을 식별하고 백만 토큰당 달러로 절감 효과를 입증함으로써 달성됩니다. 이를 통해 사용자는 실제 비용 이점을 제공하는 구성만 유지할 수 있습니다. Throttle은 vLLM, SGLang, TGI, Ollama, LMDeploy, llama.cpp, TensorRT-LLM, NIM 등 다양한 AI 서버와 호환됩니다.

더 읽기

이 도구는 오픈 소스이며 MIT 라이선스 하에 제공되어 사용자가 필요에 따라 코드를 검사하고 수정할 수 있습니다. 로컬에서 작동하므로 모든 프롬프트, 응답 및 키는 사용자의 환경 내에 유지되어 데이터 프라이버시와 보안을 보장합니다. Throttle은 무료로 사용할 수 있는 명령줄 인터페이스(CLI)를 제공하며, 기업 사용자를 위한 무료 2개월 파일럿도 제공합니다.

Throttle의 가격 모델은 유연하며, 신용 카드 없이 시작할 수 있는 $10의 무료 크레딧으로 시작합니다. 스타터 플랜은 월 $30, 프로 플랜은 월 $50, 팀 플랜은 월 $100로 가격이 책정되며, 각 플랜에는 동등한 사용 크레딧이 포함됩니다. 기업 플랜은 맞춤형 가격으로 제공되며, 사용자가 검증된 절감액에서만 비용을 지불하는 실습 파일럿이 포함됩니다.

이 도구의 핵심 기능은 백만 토큰당 비용을 결정하기 위한 검사를 실행하며, 노이즈를 고려하여 95% 신뢰 구간을 제공합니다. 출력 길이나 토큰 한도 초과 시 변경 사항을 플래그하여 실제 절감 효과만 고려되도록 합니다. Throttle은 절감 효과와 비용을 시각화할 수 있는 사용자 인터페이스(UI)를 제공하며, 사용자의 기기에서 로컬로 접근할 수 있습니다.

  • 카테고리MLOps 및 모델 배포
  • 요금제프리미엄
  • 배포로컬
  • 플랫폼OpenAI 호환

  • 오픈 소스 CLI

  • AI 추론 비용 최적화

  • 다양한 AI 서버와의 호환성

  • 로컬 데이터 처리

  • 무료 2개월 기업 파일럿

  • 95% 신뢰 구간을 통한 절감 효과

  • 노이즈 보정된 판별

  • 사용 크레딧이 포함된 Throttle Cloud

  1. 설치: pipx install throttle-pro

  2. 실행: 설정에서 throttle check 실행

  3. 분석: 비용 절감 및 구성 검토

  4. 최적화: 비용 효율적인 구성 구현

  • 비용 절감
  • 구성 분석
  • 데이터 프라이버시
  • 기업 절감
  • 오픈 소스 개발

Throttle 리뷰

로딩 중...

Throttle와(과) 비슷한 인기 AI 도구

Hopscotch

AI 앱

Hopscotch는 Anthropic, OpenAI 및 Google과 같은 제공업체의 500개 이상의 AI 모델에 단일 API를 통해 접근할 수 있도록 합니다. 사용자는 각 API 키, 팀원 및 작업 공간에 대한 지출 한도를 설정하여 비용을 관리하고 효율적인 모델 사용을 보장할 수 있습니다.

MLOps 및 모델 배포

AI 모델 미세 조정 72위

도구 보기

AI 앱

Anthropic, OpenAI 및 Google과 같은 제공업체의 500개 이상의 AI 모델에 단일 API를 통해 접근할 수 있도록 합니다. 사용자는 각 API 키, 팀원 및 작업 공간에 대한 지출 한도를 설정하여 비용을 관리하고 효율적인 모델 사용을 보장할 수 있습니다.Hopscotch는 Anthropic, OpenAI 및 Google과 같은 제공업체의 500개 이상의 AI 모델에 단일 API를 통해 접근할 수 있도록 합니다. 사용자는 각 API 키, 팀원 및 작업 공간에 대한 지출 한도를 설정하여 비용을 관리하고 효율적인 모델 사용을 보장할 수 있습니다.

MLOps 및 모델 배포
AI 모델 미세 조정 72위

목적에 맞게 설계된 ASIC 인프라를 통해 모델을 제공하는 고속 AI 추론 제공업체로, OpenAI 호환 API를 통해 지연에 민감한 작업 부하인 코딩 에이전트 및 실시간 음성에 대해 낮은 첫 번째 토큰 시간과 높은 처리량을 제공합니다.

MLOps 및 모델 배포
도구 보기

목적에 맞게 설계된 ASIC 인프라를 통해 모델을 제공하는 고속 AI 추론 제공업체로, OpenAI 호환 API를 통해 지연에 민감한 작업 부하인 코딩 에이전트 및 실시간 음성에 대해 낮은 첫 번째 토큰 시간과 높은 처리량을 제공합니다.

MLOps 및 모델 배포
AI 앱 TOP 250 보기

ZETIC Melange는 모든 기기에서 어떤 모델이든 온디바이스 AI 배포를 자동화합니다. 전직 Qualcomm 엔지니어들이 개발했으며, NPU 가속을 최적화하고 200개 이상의 기기에서 벤치마킹하며, 단 세 줄의 코드로 몇 시간 내에 배포를 가능하게 하여 비용과 지연 시간을 줄입니다.

MLOps 및 모델 배포

MLOps 및 모델 배포 149위

도구 보기

모든 기기에서 어떤 모델이든 온디바이스 AI 배포를 자동화합니다. 전직 Qualcomm 엔지니어들이 개발했으며, NPU 가속을 최적화하고 200개 이상의 기기에서 벤치마킹하며, 단 세 줄의 코드로 몇 시간 내에 배포를 가능하게 하여 비용과 지연 시간을 줄입니다.ZETIC Melange는 모든 기기에서 어떤 모델이든 온디바이스 AI 배포를 자동화합니다. 전직 Qualcomm 엔지니어들이 개발했으며, NPU 가속을 최적화하고 200개 이상의 기기에서 벤치마킹하며, 단 세 줄의 코드로 몇 시간 내에 배포를 가능하게 하여 비용과 지연 시간을 줄입니다.

MLOps 및 모델 배포
MLOps 및 모델 배포 149위

Navige

AI 앱

Navige는 호출을 적절한 모델로 라우팅하고 불필요한 호출을 차단하며 완료된 작업을 재사용하여 AI 에이전트 비용을 최적화합니다. 이를 통해 비용을 줄이면서 동일한 출력을 보장하여 AI 운영을 보다 효율적이고 비용 효과적으로 만듭니다.

MLOps 및 모델 배포

MLOps 및 모델 배포 174위

도구 보기

AI 앱

호출을 적절한 모델로 라우팅하고 불필요한 호출을 차단하며 완료된 작업을 재사용하여 AI 에이전트 비용을 최적화합니다. 이를 통해 비용을 줄이면서 동일한 출력을 보장하여 AI 운영을 보다 효율적이고 비용 효과적으로 만듭니다.Navige는 호출을 적절한 모델로 라우팅하고 불필요한 호출을 차단하며 완료된 작업을 재사용하여 AI 에이전트 비용을 최적화합니다. 이를 통해 비용을 줄이면서 동일한 출력을 보장하여 AI 운영을 보다 효율적이고 비용 효과적으로 만듭니다.

MLOps 및 모델 배포
MLOps 및 모델 배포 174위

Inference.net은 AI 네이티브 팀이 AI 작업을 실행, 모니터링 및 최적화할 수 있도록 인프라를 제공합니다. 오픈 소스, 맞춤형 및 미세 조정된 모델에 대해 빠른 추론을 제공하며, 대규모로 저렴한 비용과 빠른 대기 시간을 보장합니다.

MLOps 및 모델 배포

AI 모델 미세 조정 78위

도구 보기

AI 네이티브 팀이 AI 작업을 실행, 모니터링 및 최적화할 수 있도록 인프라를 제공합니다. 오픈 소스, 맞춤형 및 미세 조정된 모델에 대해 빠른 추론을 제공하며, 대규모로 저렴한 비용과 빠른 대기 시간을 보장합니다.Inference.net은 AI 네이티브 팀이 AI 작업을 실행, 모니터링 및 최적화할 수 있도록 인프라를 제공합니다. 오픈 소스, 맞춤형 및 미세 조정된 모델에 대해 빠른 추론을 제공하며, 대규모로 저렴한 비용과 빠른 대기 시간을 보장합니다.

MLOps 및 모델 배포
AI 모델 미세 조정 78위

GPUX

AI 앱

GPUX는 AI 모델을 위한 서버리스 GPU 추론 기능을 제공하여 머신러닝 워크로드의 빠른 배포 및 실행을 가능하게 합니다. 빠른 콜드 스타트, Stable Diffusion XL 및 Whisper와 같은 다양한 AI 모델 지원, 개인 모델에 대한 추론 실행 또는 요청 판매 기능을 제공하여 AI를 더욱 접근 가능하고…

MLOps 및 모델 배포
도구 보기

AI 앱

AI 모델을 위한 서버리스 GPU 추론 기능을 제공하여 머신러닝 워크로드의 빠른 배포 및 실행을 가능하게 합니다. 빠른 콜드 스타트, Stable Diffusion XL 및 Whisper와 같은 다양한 AI 모델 지원, 개인 모델에 대한 추론 실행 또는 요청 판매 기능을 제공하여 AI를 더욱 접근 가능하고…GPUX는 AI 모델을 위한 서버리스 GPU 추론 기능을 제공하여 머신러닝 워크로드의 빠른 배포 및 실행을 가능하게 합니다. 빠른 콜드 스타트, Stable Diffusion XL 및 Whisper와 같은 다양한 AI 모델 지원, 개인 모델에 대한 추론 실행 또는 요청 판매 기능을 제공하여 AI를 더욱 접근 가능하고…

MLOps 및 모델 배포
AI 앱 TOP 250 보기

Chutes는 사용자가 몇 초 만에 모든 AI 모델을 배포, 실행 및 확장할 수 있는 서버리스 AI 컴퓨트 플랫폼입니다. 오픈 소스 모델에 중점을 두어 AI 개발자와 기업 모두에게 유연하고 효율적인 환경을 제공합니다.

MLOps 및 모델 배포
도구 보기

사용자가 몇 초 만에 모든 AI 모델을 배포, 실행 및 확장할 수 있는 서버리스 AI 컴퓨트 플랫폼입니다. 오픈 소스 모델에 중점을 두어 AI 개발자와 기업 모두에게 유연하고 효율적인 환경을 제공합니다.Chutes는 사용자가 몇 초 만에 모든 AI 모델을 배포, 실행 및 확장할 수 있는 서버리스 AI 컴퓨트 플랫폼입니다. 오픈 소스 모델에 중점을 두어 AI 개발자와 기업 모두에게 유연하고 효율적인 환경을 제공합니다.

MLOps 및 모델 배포
AI 앱 TOP 250 보기

GMI Cloud

AI 앱

GMI Cloud는 AI 작업 부하를 위한 고성능 GPU 클라우드 인프라를 제공합니다. 서버리스 추론, 전용 GPU 클러스터 및 베어 메탈 AI 인프라를 지원하여 AI 모델 배포 및 머신 러닝 작업을 위한 확장 가능한 솔루션을 제공합니다.

MLOps 및 모델 배포

AI DevOps 및 클라우드 도구 76위

도구 보기

AI 앱

AI 작업 부하를 위한 고성능 GPU 클라우드 인프라를 제공합니다. 서버리스 추론, 전용 GPU 클러스터 및 베어 메탈 AI 인프라를 지원하여 AI 모델 배포 및 머신 러닝 작업을 위한 확장 가능한 솔루션을 제공합니다.GMI Cloud는 AI 작업 부하를 위한 고성능 GPU 클라우드 인프라를 제공합니다. 서버리스 추론, 전용 GPU 클러스터 및 베어 메탈 AI 인프라를 지원하여 AI 모델 배포 및 머신 러닝 작업을 위한 확장 가능한 솔루션을 제공합니다.

MLOps 및 모델 배포
AI DevOps 및 클라우드 도구 76위
1/8