본문으로 건너뛰기
ToolPotion
AI 어드바이저
제출 (무료)

GPUX

GPUX는 AI 모델을 위한 서버리스 GPU 추론 기능을 제공하여 머신러닝 워크로드의 빠른 배포 및 실행을 가능하게 합니다. 빠른 콜드 스타트, Stable Diffusion XL 및 Whisper와 같은 다양한 AI 모델 지원, 개인 모델에 대한 추론 실행 또는 요청 판매 기능을 제공하여 AI를 더욱 접근 가능하고 효율적으로 만듭니다.

URL 방문
공유
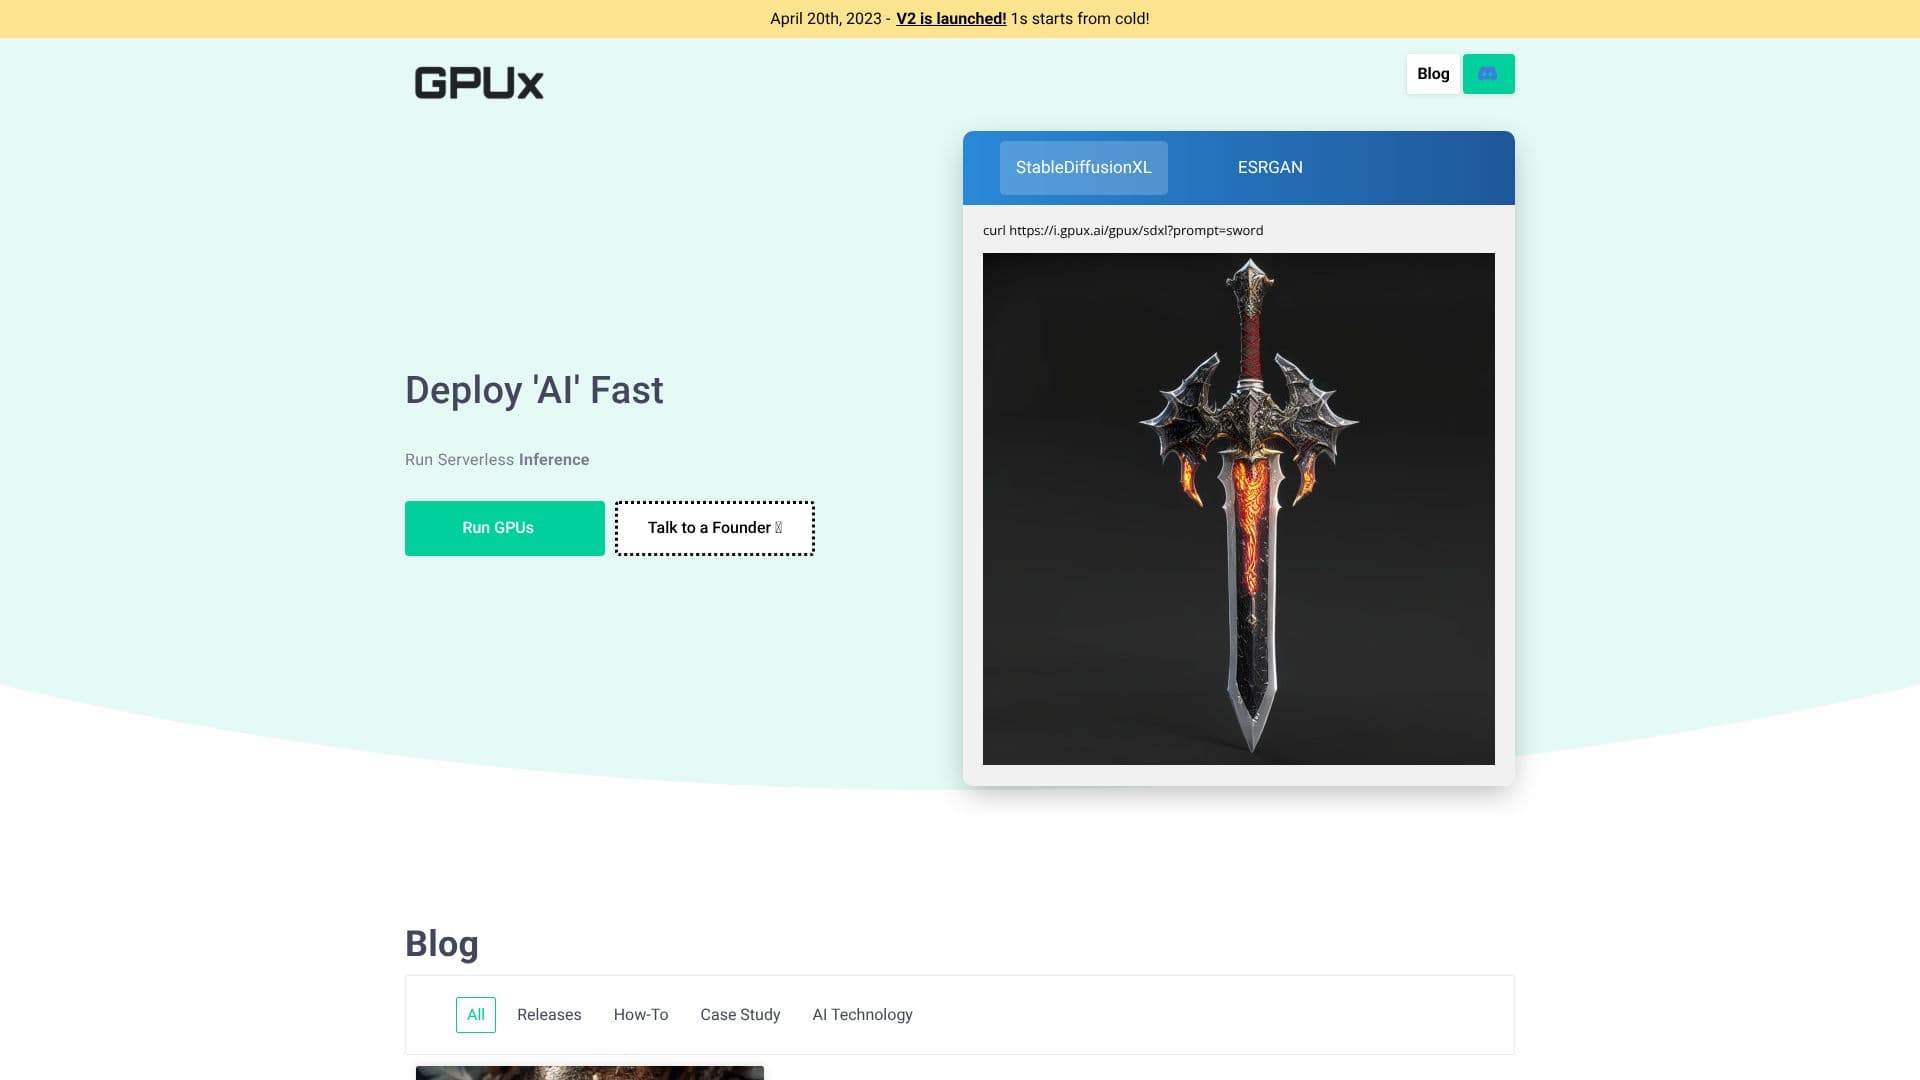
GPUX 스크린샷
GPUX 스크린샷

GPUX는 AI 및 머신러닝 모델의 배포 및 실행을 가속화하도록 설계된 서버리스 추론 플랫폼입니다. 2023년 4월 20일 V2와 함께 출시된 GPUX는 인스턴스가 단 1초부터 시작되는 빠른 콜드 스타트 제공에 중점을 둡니다. 이 기능은 즉각적인 응답성이 필요한 애플리케이션에 매우 중요합니다.

더 읽기

이 플랫폼은 Stable Diffusion XL (SDXL), ESRGAN, WHISPER를 포함한 다양한 인기 AI 모델을 지원하여 이미지 생성, 업스케일링, 음성-텍스트 변환과 같은 다양한 AI 작업에 다용도로 활용될 수 있습니다. GPUX를 통해 사용자는 AI 모델을 배포하고 서버리스 추론을 실행하여 인프라 관리의 복잡성을 추상화할 수 있습니다.

추론 실행 외에도 GPUX는 AI 모델 수익화를 위한 고유한 기능을 제공합니다. 사용자는 자신의 개인 모델에 대한 추론 요청을 다른 조직에 판매하여 AI 기능에 대한 마켓플레이스를 만들 수 있습니다. 이 P2P(Peer-to-Peer) 모델은 모델 소유자에게 수익을 창출하는 동시에 다른 비즈니스에 전문 AI에 대한 액세스를 제공할 수 있습니다.

GPUX는 나이키가 전문 여성용 클리트를 제작하는 방식과 유사하게 머신러닝 워크로드에 "적합한" 중요성을 강조합니다. 이는 인프라와 배포를 AI 작업의 특정 요구 사항에 맞게 조정하는 것을 의미합니다. 이 플랫폼은 추론 중 데이터 처리를 위한 유연성을 향상시키는 ReadWrite Volumes와 같은 기능을 지원합니다.

GPUX의 대상 고객에는 기본 하드웨어를 관리하지 않고도 AI 모델을 효율적으로 배포하고 확장하려는 개발자, 데이터 과학자 및 조직이 포함됩니다. 이 플랫폼은 AI 추론을 위한 GPU 컴퓨팅에 대한 액세스를 민주화하여 더 빠르고 비용 효율적으로 만드는 것을 목표로 합니다. GPUX 팀에는 마케팅의 Annie, 기술의 Ivan, 운영의 Henry가 포함되며, 참여를 위한 연락처 정보와 LinkedIn 프로필이 제공됩니다.

GPUX는 또한 AI 기술에 대한 기사, 사용 방법 가이드 및 사례 연구가 포함된 블로그와 같은 리소스를 제공합니다. 최근 블로그 게시물은 RTX 4090에서 Stable Diffusion XL을 50% 더 빠르게 만드는 것과 같은 성능 개선을 강조하며 최적화 및 사용자 교육에 대한 노력을 보여줍니다. 이 플랫폼은 사용 편의성과 성능에 중점을 두고 구축되어 사용자가 "AI를 빠르게 배포"할 수 있도록 합니다.

  • 카테고리MLOps 및 모델 배포
  • 배포서버리스
  • 플랫폼웹

  • 서버리스 GPU 추론

  • 1초 콜드 스타트

  • Stable Diffusion XL 지원

  • WHISPER 지원

  • ESRGAN 지원

  • 배포된 모델에서 추론 실행

  • 개인 모델에서 추론 요청 판매

  • ReadWrite Volumes 지원

  • 추론 요청을 위한 P2P 모델

  • AI 모델의 빠른 배포

  • 확장 가능한 추론 인프라

  1. 모델 배포: 훈련된 AI 모델을 GPUX 플랫폼에 업로드합니다.

  2. 추론 구성: 모델에서 추론을 실행하기 위한 매개변수를 설정합니다.

  3. 추론 실행: 서버리스 GPU를 활용하여 주문형 추론 작업을 실행합니다.

  4. 성능 최적화: 모델 속도와 효율성을 향상시키는 기능을 활용합니다.

  5. 모델 수익화 (선택 사항): 다른 사용자에게 개인 모델에 대한 추론 서비스를 제공합니다.

  • AI 모델 배포
  • 서버리스 추론
  • 이미지 생성
  • 음성-텍스트 변환
  • 모델 수익화
  • AI 성능 최적화
  • GPU 컴퓨팅 액세스

GPUX 리뷰

로딩 중...

GPUX와(과) 비슷한 인기 AI 도구

오픈, 독점 및 맞춤형 모델을 하나의 OpenAI 호환 API 뒤에 호스팅하는 전문 AI 추론 및 통합 제공업체로, 사용량 기반 요금제, 더 높은 속도 제한 및 코드 없는 대시보드를 제공합니다.

머신러닝 플랫폼
도구 보기

오픈, 독점 및 맞춤형 모델을 하나의 OpenAI 호환 API 뒤에 호스팅하는 전문 AI 추론 및 통합 제공업체로, 사용량 기반 요금제, 더 높은 속도 제한 및 코드 없는 대시보드를 제공합니다.

머신러닝 플랫폼
AI 앱 TOP 250 보기

Cloudflare Workers AI는 단일 API 호출로 전 세계에서 AI 추론을 실행할 수 있는 엣지 AI 추론 플랫폼입니다. 50개 이상의 모델과 서버리스 가격 책정을 제공하여 인프라 관리를 하지 않고도 AI 작업 부하를 쉽게 확장할 수 있습니다.

MLOps 및 모델 배포
도구 보기

단일 API 호출로 전 세계에서 AI 추론을 실행할 수 있는 엣지 AI 추론 플랫폼입니다. 50개 이상의 모델과 서버리스 가격 책정을 제공하여 인프라 관리를 하지 않고도 AI 작업 부하를 쉽게 확장할 수 있습니다.Cloudflare Workers AI는 단일 API 호출로 전 세계에서 AI 추론을 실행할 수 있는 엣지 AI 추론 플랫폼입니다. 50개 이상의 모델과 서버리스 가격 책정을 제공하여 인프라 관리를 하지 않고도 AI 작업 부하를 쉽게 확장할 수 있습니다.

추천MLOps 및 모델 배포
AI 플랫폼 TOP 150 보기

RunInfra

AI 앱

RunInfra는 오픈 소스 AI 모델을 위한 호스팅된 API 게이트웨이로, 개발자에게 OpenAI 및 Anthropic SDK와 호환되는 하나의 API 키를 제공합니다. 이는 Nemotron, Qwen 및 Ornith와 같은 모델을 제공하며, 세션 인식 캐싱을 통해 AI 에이전트의 지연 시간과 비용을 절감합니다.

MLOps 및 모델 배포

MLOps 및 모델 배포 93위

도구 보기

AI 앱

오픈 소스 AI 모델을 위한 호스팅된 API 게이트웨이로, 개발자에게 OpenAI 및 Anthropic SDK와 호환되는 하나의 API 키를 제공합니다. 이는 Nemotron, Qwen 및 Ornith와 같은 모델을 제공하며, 세션 인식 캐싱을 통해 AI 에이전트의 지연 시간과 비용을 절감합니다.RunInfra는 오픈 소스 AI 모델을 위한 호스팅된 API 게이트웨이로, 개발자에게 OpenAI 및 Anthropic SDK와 호환되는 하나의 API 키를 제공합니다. 이는 Nemotron, Qwen 및 Ornith와 같은 모델을 제공하며, 세션 인식 캐싱을 통해 AI 에이전트의 지연 시간과 비용을 절감합니다.

MLOps 및 모델 배포
MLOps 및 모델 배포 93위

ZETIC Melange는 모든 기기에서 어떤 모델이든 온디바이스 AI 배포를 자동화합니다. 전직 Qualcomm 엔지니어들이 개발했으며, NPU 가속을 최적화하고 200개 이상의 기기에서 벤치마킹하며, 단 세 줄의 코드로 몇 시간 내에 배포를 가능하게 하여 비용과 지연 시간을 줄입니다.

MLOps 및 모델 배포

MLOps 및 모델 배포 139위

도구 보기

모든 기기에서 어떤 모델이든 온디바이스 AI 배포를 자동화합니다. 전직 Qualcomm 엔지니어들이 개발했으며, NPU 가속을 최적화하고 200개 이상의 기기에서 벤치마킹하며, 단 세 줄의 코드로 몇 시간 내에 배포를 가능하게 하여 비용과 지연 시간을 줄입니다.ZETIC Melange는 모든 기기에서 어떤 모델이든 온디바이스 AI 배포를 자동화합니다. 전직 Qualcomm 엔지니어들이 개발했으며, NPU 가속을 최적화하고 200개 이상의 기기에서 벤치마킹하며, 단 세 줄의 코드로 몇 시간 내에 배포를 가능하게 하여 비용과 지연 시간을 줄입니다.

MLOps 및 모델 배포
MLOps 및 모델 배포 139위

Runware

AI 앱

Runware는 이미지, 비디오, 오디오, 3D, LLM 및 비전 모델을 위한 통합 API를 제공하는 생성 AI 추론 플랫폼입니다. 400K 이상의 모델, 관리되는 인프라 및 맞춤형 추론 엔진을 기반으로 한 사용량 기반 가격 책정을 제공합니다.

MLOps 및 모델 배포
도구 보기

AI 앱

이미지, 비디오, 오디오, 3D, LLM 및 비전 모델을 위한 통합 API를 제공하는 생성 AI 추론 플랫폼입니다. 400K 이상의 모델, 관리되는 인프라 및 맞춤형 추론 엔진을 기반으로 한 사용량 기반 가격 책정을 제공합니다.Runware는 이미지, 비디오, 오디오, 3D, LLM 및 비전 모델을 위한 통합 API를 제공하는 생성 AI 추론 플랫폼입니다. 400K 이상의 모델, 관리되는 인프라 및 맞춤형 추론 엔진을 기반으로 한 사용량 기반 가격 책정을 제공합니다.

MLOps 및 모델 배포
AI 앱 TOP 250 보기

SiliconFlow

AI 플랫폼

개발자가 200개 이상의 최적화된 LLM 및 다중 모달 모델을 배포, 미세 조정 및 실행할 수 있는 AI 인프라 플랫폼으로, 하나의 OpenAI 호환 API를 통해 사용한 만큼만 지불하는 가격 모델을 제공합니다.

MLOps 및 모델 배포
도구 보기

AI 플랫폼

개발자가 200개 이상의 최적화된 LLM 및 다중 모달 모델을 배포, 미세 조정 및 실행할 수 있는 AI 인프라 플랫폼으로, 하나의 OpenAI 호환 API를 통해 사용한 만큼만 지불하는 가격 모델을 제공합니다.

추천MLOps 및 모델 배포
AI 플랫폼 TOP 150 보기

목적에 맞게 설계된 ASIC 인프라를 통해 모델을 제공하는 고속 AI 추론 제공업체로, OpenAI 호환 API를 통해 지연에 민감한 작업 부하인 코딩 에이전트 및 실시간 음성에 대해 낮은 첫 번째 토큰 시간과 높은 처리량을 제공합니다.

MLOps 및 모델 배포
도구 보기

목적에 맞게 설계된 ASIC 인프라를 통해 모델을 제공하는 고속 AI 추론 제공업체로, OpenAI 호환 API를 통해 지연에 민감한 작업 부하인 코딩 에이전트 및 실시간 음성에 대해 낮은 첫 번째 토큰 시간과 높은 처리량을 제공합니다.

MLOps 및 모델 배포
AI 앱 TOP 250 보기

Cerebrium

AI 플랫폼

Cerebrium은 실시간 AI를 위한 서버리스 GPU 인프라를 제공하여 음성 에이전트, 비디오 모델 및 LLM에 대한 1초 미만의 콜드 스타트를 가능하게 합니다. 즉각적인 자동 확장을 지원하고 초당 지불 요금제를 제공하며 Kubernetes의 필요성을 없애 복잡한 인프라 관리 없이 프로덕션 속도의 AI를 사용할 수…

MLOps 및 모델 배포
도구 보기

AI 플랫폼

실시간 AI를 위한 서버리스 GPU 인프라를 제공하여 음성 에이전트, 비디오 모델 및 LLM에 대한 1초 미만의 콜드 스타트를 가능하게 합니다. 즉각적인 자동 확장을 지원하고 초당 지불 요금제를 제공하며 Kubernetes의 필요성을 없애 복잡한 인프라 관리 없이 프로덕션 속도의 AI를 사용할 수…Cerebrium은 실시간 AI를 위한 서버리스 GPU 인프라를 제공하여 음성 에이전트, 비디오 모델 및 LLM에 대한 1초 미만의 콜드 스타트를 가능하게 합니다. 즉각적인 자동 확장을 지원하고 초당 지불 요금제를 제공하며 Kubernetes의 필요성을 없애 복잡한 인프라 관리 없이 프로덕션 속도의 AI를 사용할 수…

추천MLOps 및 모델 배포
AI 플랫폼 TOP 150 보기
1/8