설명
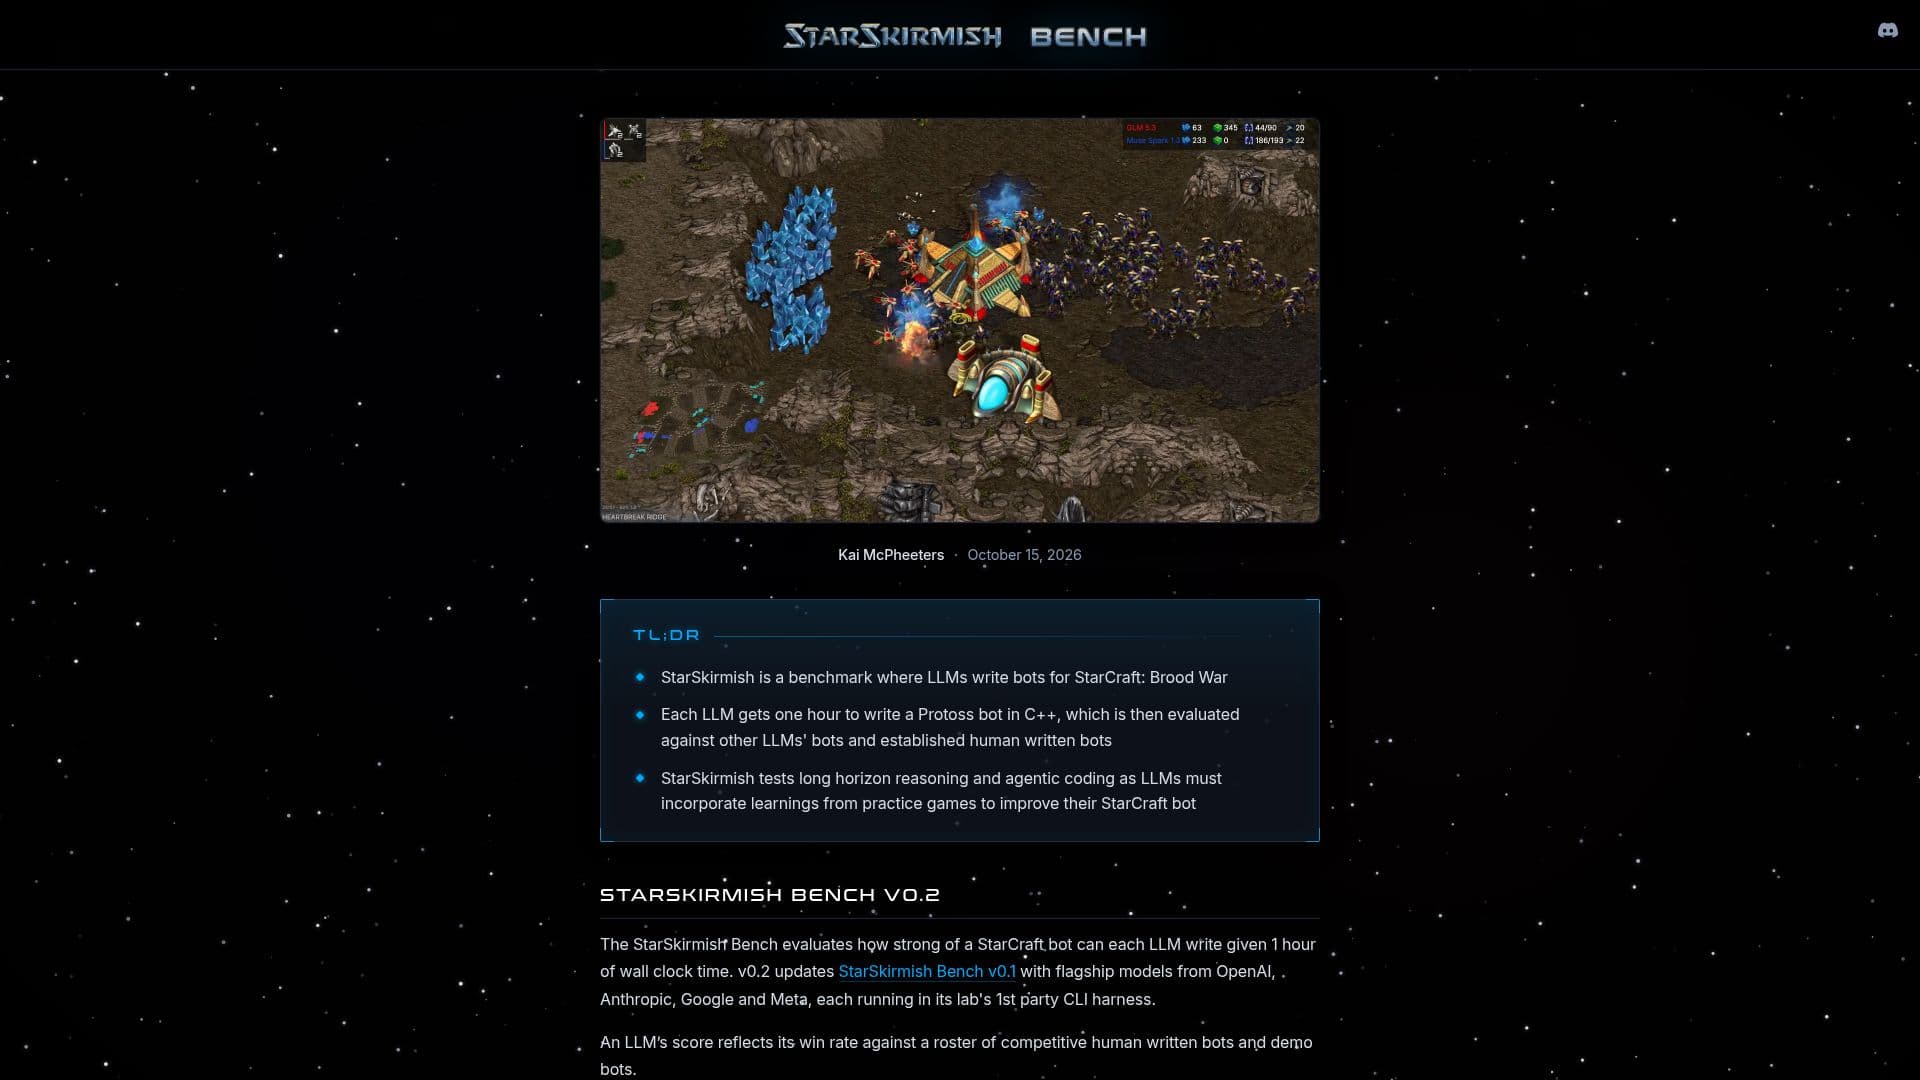
StarSkirmish Bench v0.2는 대형 언어 모델(LLM)의 Protoss 봇 작성 및 최적화 능력을 평가하기 위해 설계된 독특한 벤치마크 플랫폼입니다. 이 플랫폼은 각 LLM이 C++로 봇을 작성하는 데 한 시간의 제한을 두고 도전합니다. 이러한 봇은 경쟁력 있는 인간 작성 봇 및 다른 LLM 생성 봇의 목록과 대결하여 성능을 평가받습니다.
더 읽기
평가는 장기적 추론 및 에이전트 코딩에 중점을 두며, LLM은 연습 게임을 통해 봇을 개선해야 합니다. 이 플랫폼은 OpenAI, Anthropic, Google, Meta와 같은 주요 AI 연구소의 대표 모델을 포함하고 있으며, 각 모델은 해당 연구소의 1차 CLI 하네스에서 실행됩니다. 각 LLM의 성능은 고정된 봇 목록에 대해 다섯 번의 실행에서 평균 승률로 측정됩니다.
StarSkirmish Bench v0.2는 Gemini 4 Argon 및 Muse Wonder Full과 같은 새로운 모델을 포함하여 이전 버전에서 여러 가지 업데이트를 도입했습니다. 최고의 성능을 보이는 모델인 GPT-6 Astra는 다른 모델들에 비해 상당한 우위를 보여주지만, 인간이 작성한 봇은 여전히 가장 어려운 경기에서 모든 LLM을 초월합니다.
이 플랫폼은 또한 각 모델의 비용 효율성에 대한 통찰력을 제공하며, GPT-6.1 Sol은 성능과 비용의 균형이 뛰어난 모델로 평가됩니다. 이러한 발전에도 불구하고, 가장 강력한 인간 작성 봇은 여전히 앞서 있으며, 복잡한 전략 게임에서 인간의 창의성과 맞먹는 AI 개발의 지속적인 도전을 강조합니다.
- 카테고리AI 게임 개발 도구
- 요금제명시되지 않음
- 배포CLI
- 플랫폼OpenBW
StarSkirmish Bench v0.2의 핵심 기능
LLM을 위한 벤치마킹 플랫폼
C++로 Protoss 봇 개발
인간 작성 봇과의 평가
한 시간 개발 시간
승률로 측정되는 성능
최고 연구소의 대표 모델 포함
비용 효율성 분석
장기적 추론에 중점
StarSkirmish Bench v0.2 사용 방법은?
구성: CLI 하네스 설정
개발: C++로 Protoss 봇 작성
테스트: 봇과의 연습 게임 실행
평가: 승률로 성능 측정
StarSkirmish Bench v0.2의 사용 사례
- AI 모델 평가
- 봇 개발
- 비용 효율성 분석
- 장기적 추론
- 에이전트 코딩