설명
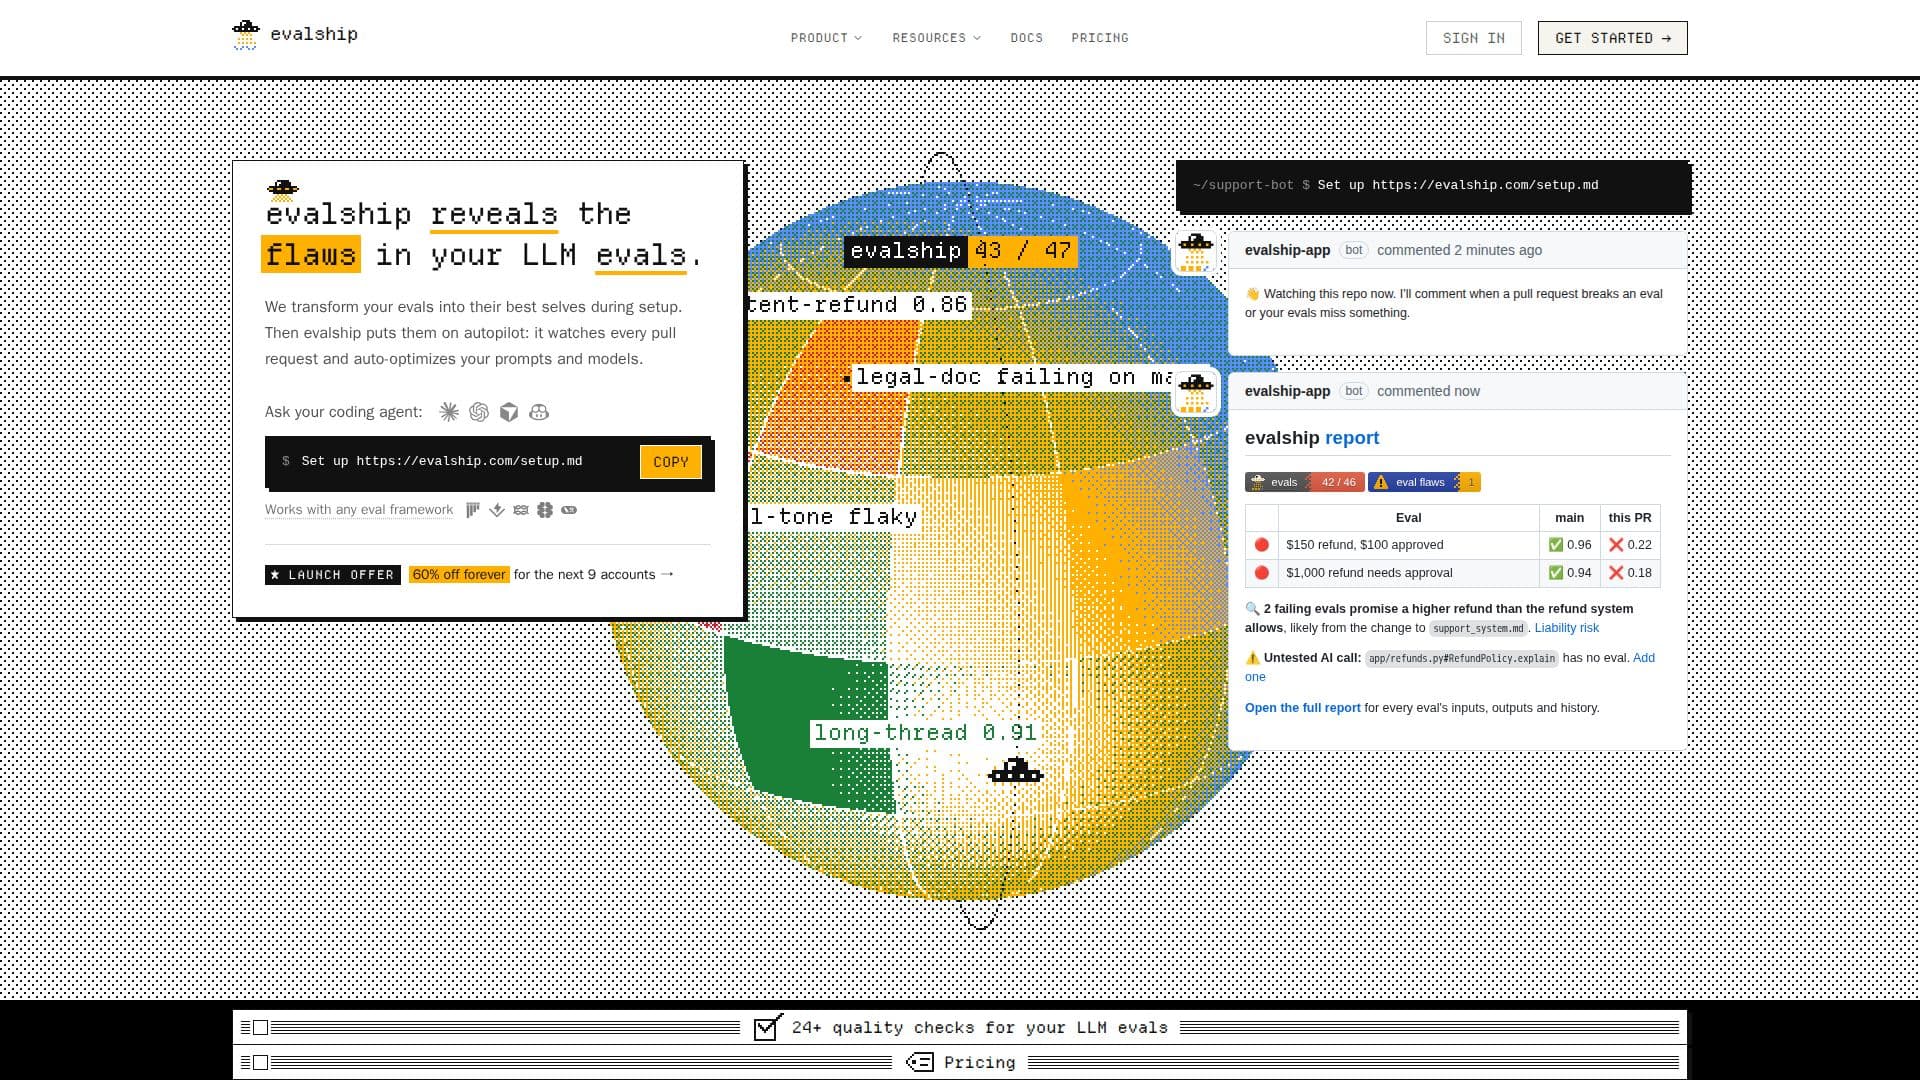
evalship은 대형 언어 모델(LLM) 평가를 위해 특별히 설계된 포괄적인 품질 관리 솔루션을 제공합니다. GitHub 워크플로우에 직접 통합되어 LLM 개발 프로세스의 경계자로 작용합니다. evalship의 핵심 목적은 평가 설정의 결함을 식별하고 해결하여 LLM이 예상대로 작동하고 회귀를 일으키지 않도록 하는 것입니다.
더 읽기
설정 후, evalship은 기존 평가자, 판별자 및 프롬프트를 철저히 검토하여 잘못 통과하는 평가나 적절한 테스트 범위가 부족한 규칙과 같은 약점을 파악합니다. 그런 다음 모든 풀 리퀘스트를 모니터링하여 무엇이 잘못되었는지, 왜 잘못되었는지, 그리고 그 원인을 즉시 피드백합니다. 여기에는 테스트되지 않은 AI 호출을 플래그하고, 기본 브랜치에서의 과거 성능을 분석하여 진짜 회귀와 불안정한 평가 결과를 구분하는 것이 포함됩니다.
이 플랫폼은 pytest, Vitest, Jest, RSpec, Go, Java, PHPUnit, Rust, Langfuse, Braintrust, LangSmith와 같은 JUnit XML, promptfoo JSON 또는 evalship JSON을 생성하는 다양한 평가 프레임워크와 원활하게 작동합니다. evalship은 평가를 직접 실행하지 않으며, 대신 GitHub Actions 워크플로우나 코딩 에이전트가 API 키를 사용하여 이를 실행하고 evalship이 결과를 처리합니다.
문제를 식별하는 것 외에도, evalship은 프롬프트와 모델을 최적화하는 데 도움을 줍니다. 코딩 에이전트를 통해, 더 저렴한 모델이나 더 명확한 규칙과 같은 다양한 변경 사항을 테스트하고, 어떤 변경이 통계적으로 유의미한 개선을 가져오는지 보고합니다. 이를 통해 팀은 모델 성능과 비용 효율성을 향상시키기 위한 데이터 기반 결정을 내릴 수 있습니다. evalship은 또한 평가 성능을 요약하고 생산에 도달하기 전에 포착된 중요한 문제를 강조하는 주간 보고서를 제공합니다.
가격은 공개 저장소에 대한 무료 계층과 한 명의 사용자가 있는 하나의 개인 저장소를 포함하며, 100개의 PR 분석과 30일의 평가 기록을 제공합니다. 유료 플랜(팀, 프로, 비즈니스)은 사용자 수, 개인 저장소, PR 분석 및 더 긴 평가 기록을 제공하며, 월별 또는 연간 청구 옵션이 있습니다. 출시 제안은 초기 사용자에게 상당한 할인을 제공합니다. evalship은 소스 코드를 저장하지 않으며 API 키를 저장하지 않고, 차이와 평가 결과만 처리하여 보안을 보장합니다.
- 카테고리AI 코드 리뷰 및 테스트
- 요금제프리미엄
- 배포클라우드
- 플랫폼웹
evalship의 핵심 기능
설정 중 LLM 평가의 결함을 식별합니다.
평가 실패에 대한 상세한 분석과 함께 모든 풀 리퀘스트에 댓글을 달습니다.
성능 데이터를 기반으로 프롬프트와 모델을 자동으로 최적화합니다.
기존의 모든 평가 프레임워크(JUnit XML, promptfoo, evalship JSON)와 함께 작동합니다.
LLM 평가를 위한 24개 이상의 품질 검사를 제공합니다.
과거 데이터를 사용하여 불안정한 평가에서 회귀를 구분합니다.
풀 리퀘스트에서 테스트되지 않은 AI 호출을 감지합니다.
평가 규칙을 깨는 병합을 차단합니다(구성 가능).
문제가 수정되면 풀 리퀘스트의 차단을 해제합니다.
성능 및 문제를 요약한 주간 평가 보고서를 이메일로 보냅니다.
모노레포 및 여러 평가 워크플로우를 지원합니다.
Langfuse, Braintrust, LangSmith와 통합되며 전환이 필요하지 않습니다.
설정 시 평가에 대한 무료 리뷰를 제공합니다.
코딩 에이전트가 풀 리퀘스트를 열기 전에 변경 사항을 확인할 수 있습니다.
소스 코드나 API 키를 저장하지 않아 보안을 보장합니다.
evalship 사용 방법은?
설정: GitHub 저장소를 연결하고 코딩 에이전트에게 evalship을 설정하도록 요청하여 평가를 검토하고 설정 풀 리퀘스트를 생성합니다.
풀 리퀘스트 모니터링: evalship은 모든 풀 리퀘스트를 자동으로 감시하며, 평가를 깨뜨리거나 테스트되지 않은 AI 호출을 도입하는 변경 사항에 댓글을 달습니다.
보고서 검토: 각 평가의 입력, 출력 및 기록에 대한 상세 보고서에 접근하여 무엇이 잘못되었는지 이해합니다.
최적화: evalship의 최적화 기능을 사용하여 코딩 에이전트와 함께 프롬프트 및 모델 변경 사항을 테스트하여 우연 이상의 개선을 식별합니다.
보고서 수신: 병합 전에 포착된 중요한 문제를 강조하는 평가 성능을 요약한 주간 이메일 보고서를 받습니다.
evalship의 사용 사례
- LLM 평가 품질 관리
- 자동화된 풀 리퀘스트 검토
- 프롬프트 및 모델 최적화
- 회귀 방지
- 테스트되지 않은 AI 호출 감지
- 불안정한 평가 관리
- 규정 준수 및 책임 위험 완화
- 개발자 워크플로우 향상