설명
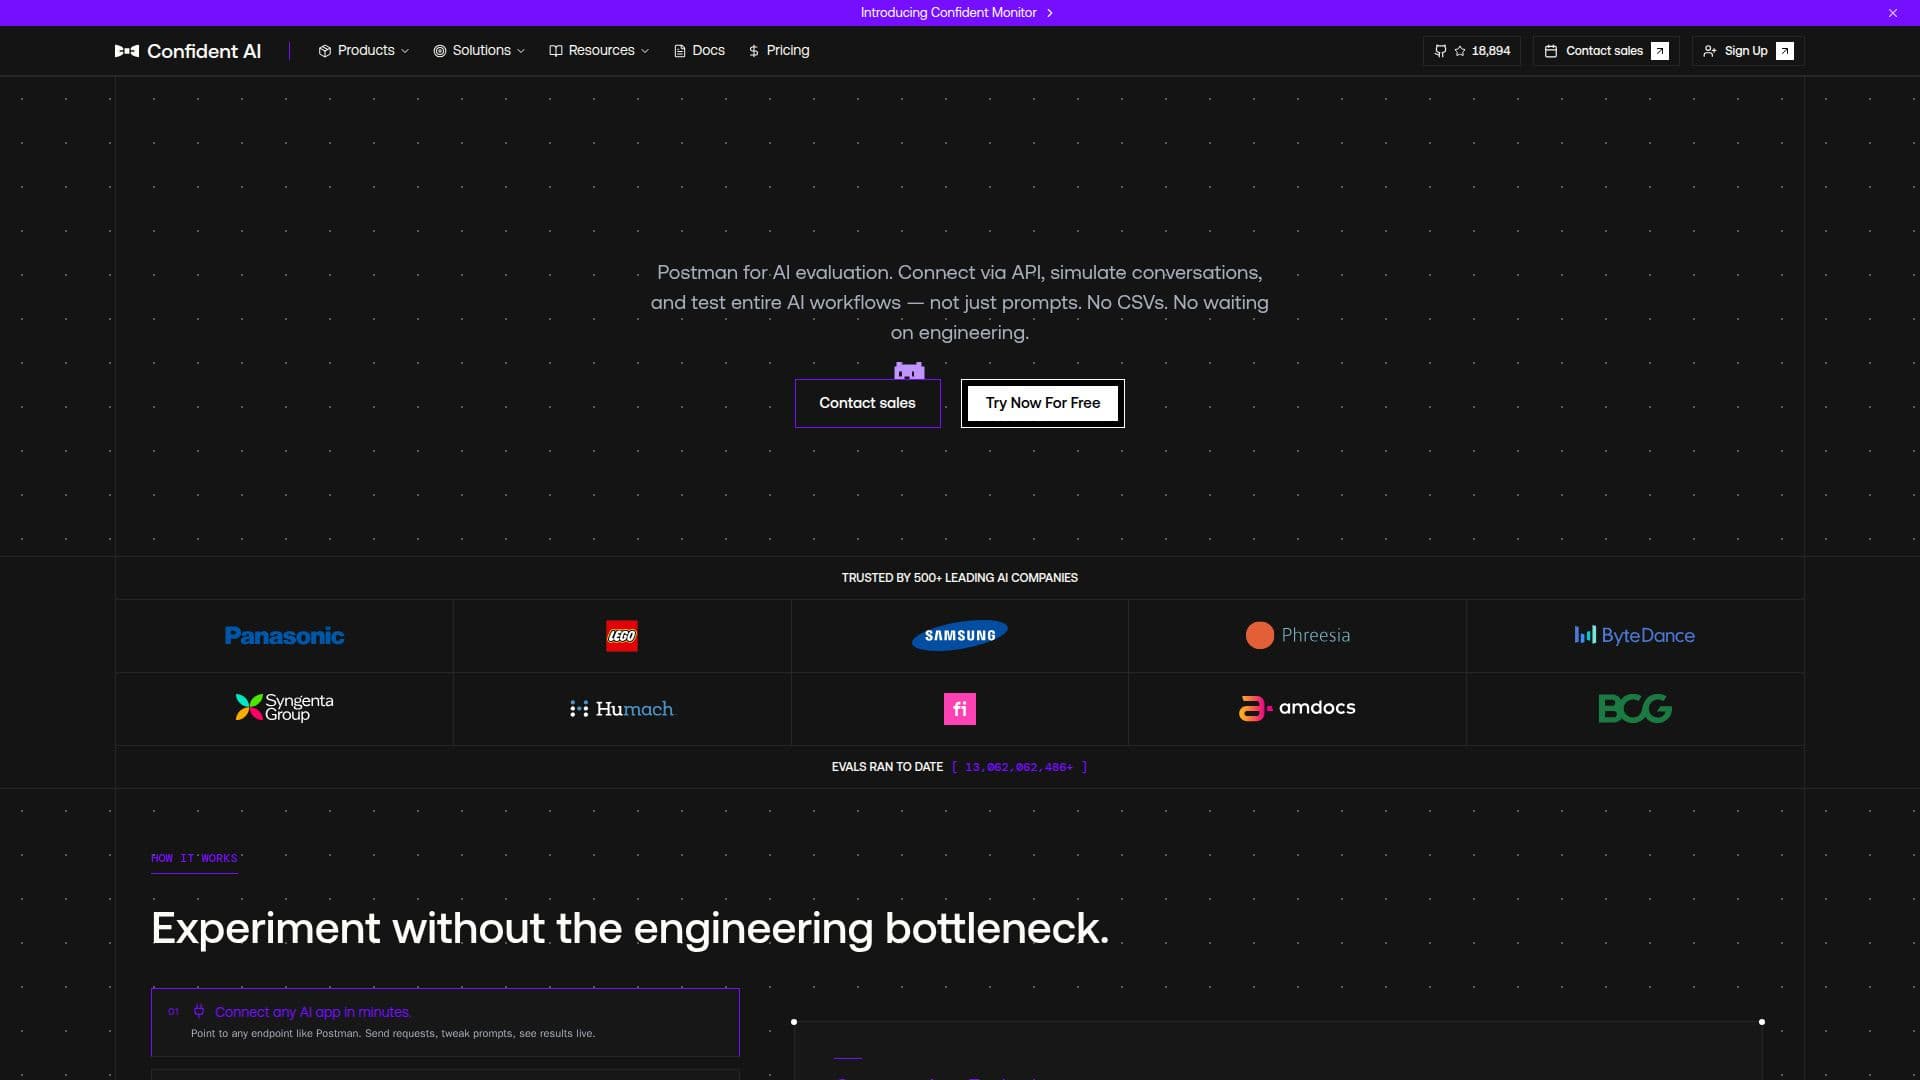
Confident AI는 대규모 언어 모델(LLM)을 평가하기 위한 강력한 플랫폼을 제공합니다. DeepEval의 제작자들이 만든 이 플랫폼은 사용자가 AI 시스템을 벤치마킹하고, 프롬프트와 모델을 비교하며, 50개 이상의 연구 기반 메트릭스를 사용하여 회귀를 포착할 수 있도록 합니다. 이러한 메트릭스는 품질, 톤, 안전성 등을 평가하며, LLM을 평가자로 활용합니다.
더 읽기
이 플랫폼은 다중 턴 대화 테스트를 지원하여 사용자가 전체 대화를 시뮬레이션하고 여러 교환에서만 드러날 수 있는 실패를 식별할 수 있도록 합니다. 사용자는 모델, 프롬프트 및 시스템 논리와 같은 변수를 변경하고, 모든 메트릭 및 파이프라인 단계에서 결과를 나란히 비교하기 위해 실험을 실행할 수 있습니다.
Confident AI는 사용자 친화적으로 설계되어 제품 관리자와 도메인 전문가가 프롬프트를 조정하고, 실험을 실행하며, 엔지니어링 지원 없이 결과를 평가할 수 있도록 합니다. OpenAI, Anthropic 및 Google과 같은 주요 LLM 제공업체를 지원하며, 클라우드 제공업체 및 게이트웨이와 통합됩니다.
Confident AI의 가격은 개인 개발자에게는 $0부터 시작하며, 비즈니스에 중요한 AI를 운영하는 팀을 위해 월 $2,000까지 확장되는 요금제가 있습니다. 기업 가격은 조직의 필요에 따라 맞춤화됩니다. 이 플랫폼은 관대한 한도가 있는 무료 티어를 제공하며, 사용자는 언제든지 요금제를 업그레이드하거나 다운그레이드할 수 있습니다.
Confident AI는 AI 품질을 우선시하는 기업들이 신뢰하며, 생산 실패를 데이터셋으로 전환하고, 메트릭스를 정렬하며, 맞춤형 엔지니어링 작업 없이 회귀를 방지하는 도구를 제공합니다. 이는 AI 평가에서 상당한 시간을 절약하고, 팀 간의 품질 결정을 지원하는 데이터를 제공합니다.
- 카테고리머신러닝 플랫폼
- 요금제프리미엄
- 배포클라우드
- 플랫폼웹
Confident AI의 핵심 기능
LLM 평가 스위트
50개 이상의 연구 기반 메트릭스
다중 턴 대화 테스트
엔지니어링 의존성 없음
주요 LLM 제공업체 지원
나란히 실험 비교
사용자 정의 가능한 평가 모델
CI/CD 파이프라인과의 통합
Confident AI 사용 방법은?
연결: 모든 AI 앱 엔드포인트를 지정합니다.
정의: 테스트 케이스를 업로드하고 메트릭스를 설정합니다.
실행: 라이브 앱에서 실험을 실행합니다.
배포: 품질 검사를 위해 CI에 평가를 통합합니다.
Confident AI의 사용 사례
- AI 벤치마킹
- 프롬프트 테스트
- 회귀 탐지
- 다중 턴 대화
- 사용자 정의 모델 평가