メインコンテンツへスキップ
ToolPotion
AI アドバイザー
送信(無料)

WeVisOne-VL

WeVisOne-VLは、TencentのWeChat Visionによって開発された統合ビジョン・言語モデルです。オブジェクト検出や画像マッティングなどのタスクに対して、オブジェクトおよびピクセルレベルの知覚を統合し、軽量のピクセルデコーダを使用しています。

URLを訪問
共有
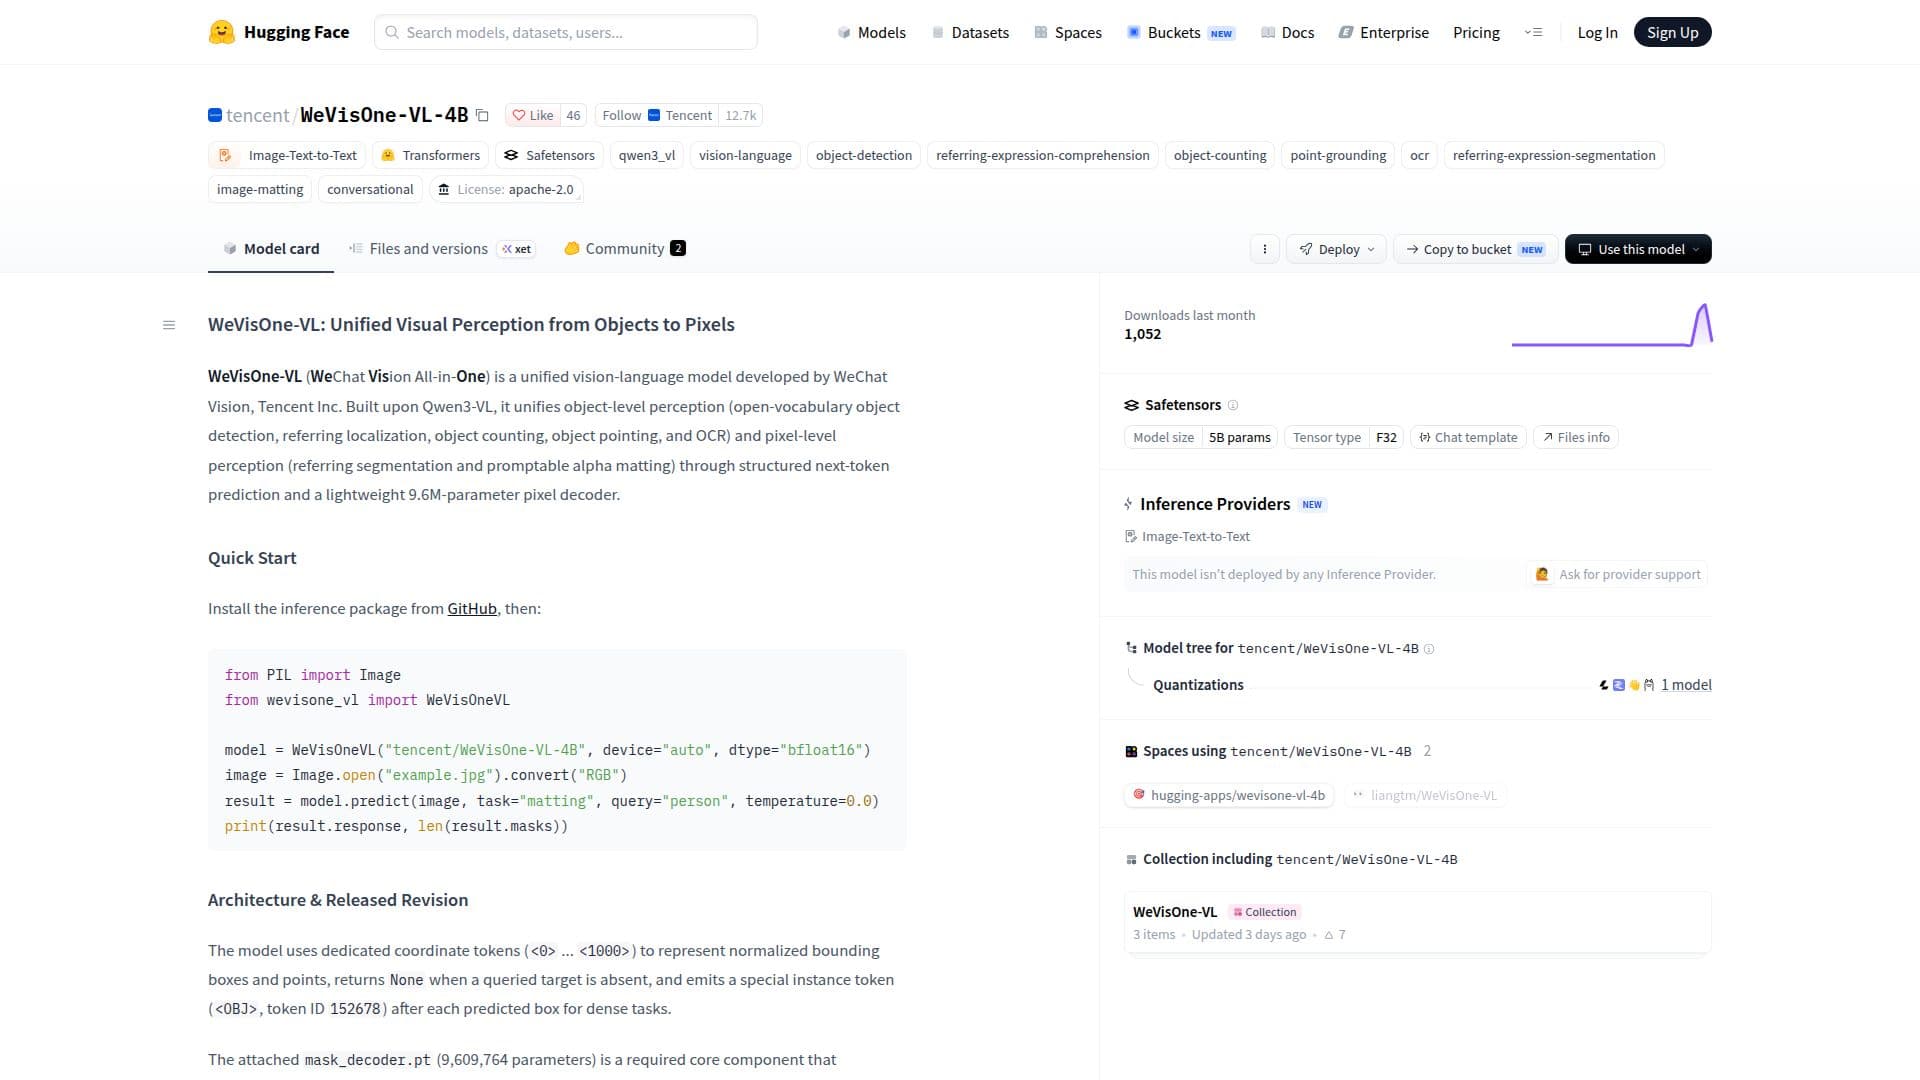
WeVisOne-VL のスクリーンショット

WeVisOne-VLは、Tencent Inc.の一部であるWeChat Visionによって開発されたビジョン・言語モデルです。オブジェクトレベルとピクセルレベルの知覚タスクを統合するように設計されています。Qwen3-VLフレームワークに基づいて構築されたWeVisOne-VLは、オープンボキャブラリーオブジェクト検出、参照ローカリゼーション、オブジェクトカウント、オブジェクトポイント、光学文字認識(OCR)などのさまざまな視覚タスクをサポートします。さらに、参照セグメンテーションやプロンプト可能なアルファマッティングなどのピクセルレベルのタスクも処理します。このモデルは、構造化された次トークン予測を採用し、軽量の9.6Mパラメータのピクセルデコーダを特徴としています。

続きを読む

WeVisOne-VLのアーキテクチャには、正規化されたバウンディングボックスやポイントを表現するための専用の座標トークンが含まれています。密なタスクのために特別なインスタンストークンを使用し、マスクデコーダをコアコンポーネントとして統合しています。このデコーダは、視覚特徴アダプタ、ボックスガイドクエリデコーダ、およびインスタンス条件付き密予測ヘッドを組み合わせて、予測を洗練し、フル解像度のアルファマットを出力します。

WeVisOne-VLは、視覚的グラウンディング、参照ローカリゼーション、ポイント、カウント、OCRローカリゼーション、参照セグメンテーション、および画像マッティングの研究目的で使用されることを意図しています。自律的な高影響の意思決定や個人識別のためには設計されていません。このモデルは構造化された出力を生成するのに効率的ですが、明示的な思考の連鎖推論をサポートせず、現在は単一ターンの画像知覚に制限されています。

このモデルはApache License 2.0の下でリリースされており、サードパーティのコンポーネントは元のライセンスを保持しています。最近1ヶ月で1,000回以上ダウンロードされており、研究コミュニティでの人気が高まっています。

  • カテゴリーAIモデルとLLM
  • 料金モデル無料
  • デプロイクラウド
  • プラットフォームWeb

  • 統合ビジョン・言語モデル

  • オブジェクトレベルの知覚

  • ピクセルレベルの知覚

  • 9.6Mパラメータのピクセルデコーダ

  • 構造化された次トークン予測

  • 専用の座標トークン

  • 密なタスク用の特別なインスタンストークン

  • Apache License 2.0

  1. モデルページにアクセス: WeVisOne-VLのHugging Faceページに訪問します

  2. 認証: モデルにアクセスするための必要な権限があることを確認します

  3. 設定: 研究ニーズに応じてモデルパラメータを設定します

  4. プロンプトを送信: 処理するための視覚タスクを入力します

  5. ファインチューニング: 必要に応じて特定のタスクにモデルを調整します

  • オブジェクト検出
  • 参照ローカリゼーション
  • オブジェクトカウント
  • OCRローカリゼーション
  • 画像マッティング

WeVisOne-VL に似た人気のAIツール

WeVisOne-VLは、WeChat Vision(テンセント社)が開発した統合ビジョン・言語モデルです。物体検出や画像マッティングなどのタスクにおいて、物体レベルとピクセルレベルの知覚を統合しており、研究目的で設計されています。

コンピュータービジョンツール
ツールを見る

WeChat Vision(テンセント社)が開発した統合ビジョン・言語モデルです。物体検出や画像マッティングなどのタスクにおいて、物体レベルとピクセルレベルの知覚を統合しており、研究目的で設計されています。WeVisOne-VLは、WeChat Vision(テンセント社)が開発した統合ビジョン・言語モデルです。物体検出や画像マッティングなどのタスクにおいて、物体レベルとピクセルレベルの知覚を統合しており、研究目的で設計されています。

コンピュータービジョンツール
LLM トップ50を見る

Qwen2-VL-7B-Instructは、視覚理解と多言語サポートのために設計された高度なAIモデルです。画像や動画の処理に優れ、さまざまなベンチマークで最先端のパフォーマンスを提供します。このモデルは、視覚およびテキスト入力に基づく自動操作のためにデバイスとの統合をサポートします。

コンピュータービジョンツール
ツールを見る

視覚理解と多言語サポートのために設計された高度なAIモデルです。画像や動画の処理に優れ、さまざまなベンチマークで最先端のパフォーマンスを提供します。このモデルは、視覚およびテキスト入力に基づく自動操作のためにデバイスとの統合をサポートします。Qwen2-VL-7B-Instructは、視覚理解と多言語サポートのために設計された高度なAIモデルです。画像や動画の処理に優れ、さまざまなベンチマークで最先端のパフォーマンスを提供します。このモデルは、視覚およびテキスト入力に基づく自動操作のためにデバイスとの統合をサポートします。

コンピュータービジョンツール
AI モデル トップ5を見る

Qwen-VL

AI GitHub リポジトリ

Qwen-VLは、Alibaba Cloudによって開発された大規模なビジョン言語モデルです。チャットおよびビジョンタスクに対する高度な機能を提供し、これらの分野におけるAIアプリケーションのための堅牢なプラットフォームを提供します。

AIモデルとLLM
ツールを見る

AI GitHub リポジトリ

Alibaba Cloudによって開発された大規模なビジョン言語モデルです。チャットおよびビジョンタスクに対する高度な機能を提供し、これらの分野におけるAIアプリケーションのための堅牢なプラットフォームを提供します。Qwen-VLは、Alibaba Cloudによって開発された大規模なビジョン言語モデルです。チャットおよびビジョンタスクに対する高度な機能を提供し、これらの分野におけるAIアプリケーションのための堅牢なプラットフォームを提供します。

AIモデルとLLM
AI GitHub リポジトリ トップ250を見る

コンピュータビジョンツールボックスは、視覚検査、物体検出、特徴マッチングを含むコンピュータビジョンシステムの設計とテストのためのアルゴリズムとアプリを提供します。画像分類やセグメンテーションなどのタスクに対して、CNNやビジョントランスフォーマーなどのAI技術をサポートしています。

コンピュータービジョンツール
ツールを見る

視覚検査、物体検出、特徴マッチングを含むコンピュータビジョンシステムの設計とテストのためのアルゴリズムとアプリを提供します。画像分類やセグメンテーションなどのタスクに対して、CNNやビジョントランスフォーマーなどのAI技術をサポートしています。コンピュータビジョンツールボックスは、視覚検査、物体検出、特徴マッチングを含むコンピュータビジョンシステムの設計とテストのためのアルゴリズムとアプリを提供します。画像分類やセグメンテーションなどのタスクに対して、CNNやビジョントランスフォーマーなどのAI技術をサポートしています。

コンピュータービジョンツール
AI アプリ トップ250を見る

Qwen2-VL-72B-Instructは、最先端の視覚理解と多言語サポートのために設計された高度なAIモデルです。画像、動画、複雑な推論タスクの処理に優れており、AI駆動の環境における多様なアプリケーションに適しています。

AIモデルとLLM
ツールを見る

最先端の視覚理解と多言語サポートのために設計された高度なAIモデルです。画像、動画、複雑な推論タスクの処理に優れており、AI駆動の環境における多様なアプリケーションに適しています。Qwen2-VL-72B-Instructは、最先端の視覚理解と多言語サポートのために設計された高度なAIモデルです。画像、動画、複雑な推論タスクの処理に優れており、AI駆動の環境における多様なアプリケーションに適しています。

AIモデルとLLM
AI モデル トップ5を見る

Ultralytics YOLO

AI GitHub リポジトリ

Ultralytics YOLOにはYOLO26、YOLO11、YOLOv8が含まれており、物体検出、インスタンスセグメンテーション、セマンティックセグメンテーション、画像分類、ポーズ推定、物体追跡の機能を提供します。これはコンピュータビジョンの分野における開発者や研究者向けに設計されています。

コンピュータービジョンツール

AI GitHub リポジトリで第19位

ツールを見る

AI GitHub リポジトリ

Ultralytics YOLOにはYOLO26、YOLO11、YOLOv8が含まれており、物体検出、インスタンスセグメンテーション、セマンティックセグメンテーション、画像分類、ポーズ推定、物体追跡の機能を提供します。これはコンピュータビジョンの分野における開発者や研究者向けに設計されています。

注目コンピュータービジョンツール
AI GitHub リポジトリで第19位

CLIP ViT-B/32

AI モデル

OpenAIによって開発されたclip-vit-base-patch32モデルは、ゼロショット画像分類タスクのために設計されています。これは、コンピュータビジョンにおける堅牢性と一般化を強化するために、ビジョントランスフォーマーアーキテクチャを利用しており、AI研究者にとって貴重なリソースとなっています。

コンピュータービジョンツール
ツールを見る

AI モデル

OpenAIによって開発されたclip-vit-base-patch32モデルは、ゼロショット画像分類タスクのために設計されています。これは、コンピュータビジョンにおける堅牢性と一般化を強化するために、ビジョントランスフォーマーアーキテクチャを利用しており、AI研究者にとって貴重なリソースとなっています。

注目コンピュータービジョンツール
AI モデル トップ5を見る

Ultralytics

AI アプリ

データの注釈付け、YOLOモデルのトレーニング、そして世界中への展開を行うエンドツーエンドのコンピュータビジョンプラットフォームで、広く採用されているUltralytics YOLOオープンソースフレームワークを基盤としています。

コンピュータービジョンツール製造・工業

製造・工業で第5位

ツールを見る

AI アプリ

データの注釈付け、YOLOモデルのトレーニング、そして世界中への展開を行うエンドツーエンドのコンピュータビジョンプラットフォームで、広く採用されているUltralytics YOLOオープンソースフレームワークを基盤としています。

注目コンピュータービジョンツール製造・工業
製造・工業で第5位
1 / 8