メインコンテンツへスキップ
ToolPotion
AI アドバイザー
送信(無料)

WeVisOne-VL

WeVisOne-VLは、WeChat Vision(テンセント社)が開発した統合ビジョン・言語モデルです。物体検出や画像マッティングなどのタスクにおいて、物体レベルとピクセルレベルの知覚を統合しており、研究目的で設計されています。

URLを訪問
共有
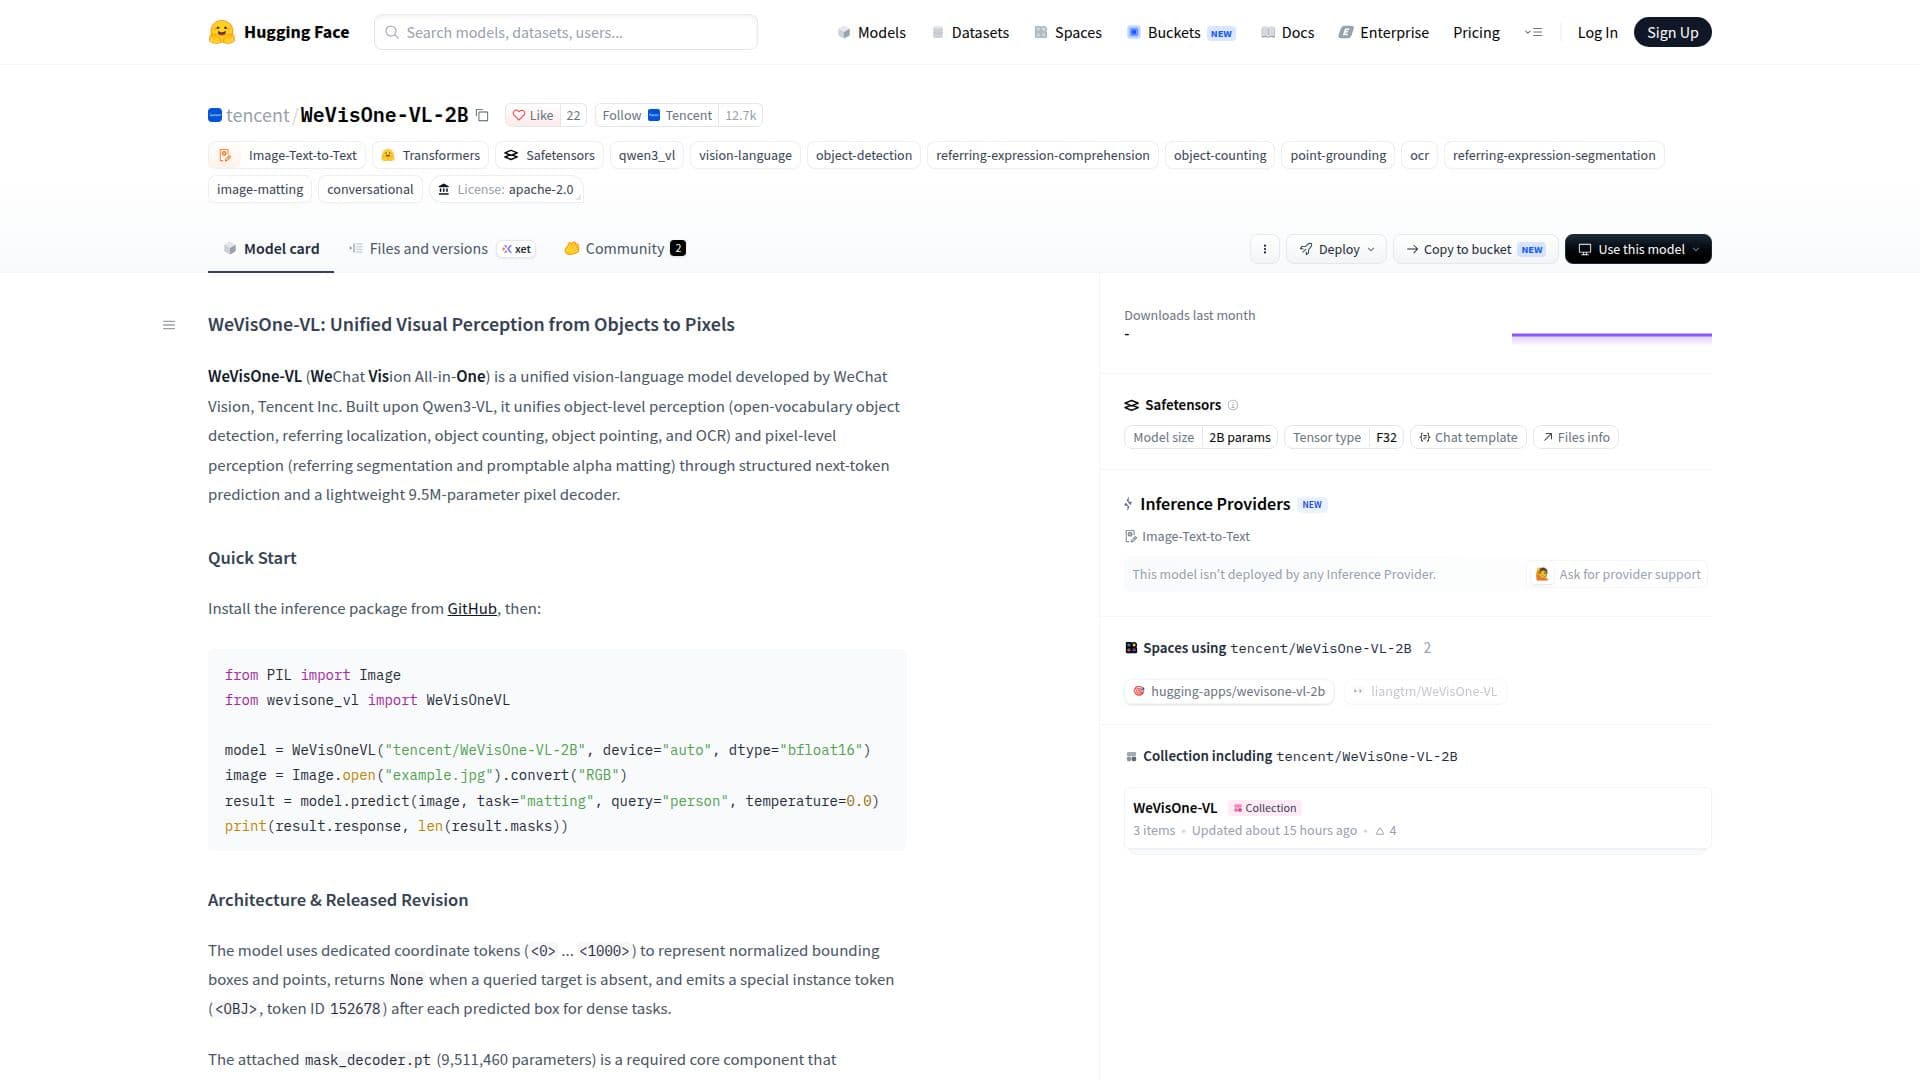
WeVisOne-VL のスクリーンショット

WeVisOne-VLは、テンセント社のWeChat Vision部門が開発した高度なビジョン・言語モデルです。このモデルはQwen3-VLフレームワークに基づいて構築されており、物体レベルとピクセルレベルの知覚タスクを統合するように設計されています。オープンボキャブラリーの物体検出、参照ローカリゼーション、物体カウント、物体指示、光学文字認識(OCR)を処理する能力があります。さらに、参照セグメンテーションやプロンプト可能なアルファマッティングなどのピクセルレベルのタスクもサポートしています。

続きを読む

このモデルは構造化された次トークン予測を採用し、950万パラメータを持つ軽量のピクセルデコーダーを特徴としています。WeVisOne-VLの重要なコンポーネントはmask_decoder.ptであり、視覚特徴アダプター、ボックスガイドクエリデコーダー、インスタンス条件付き密な予測ヘッドを統合しています。これらのコンポーネントは、予測を洗練し、高解像度のアルファマットを出力するために協力します。

WeVisOne-VLは、視覚的グラウンディング、ローカリゼーション、指示、カウント、OCR、セグメンテーション、画像マッティングにおける研究アプリケーションを目的としています。自律的な意思決定や個人識別のためには設計されていません。このモデルは、単一ターンの画像知覚に最適化されており、ビデオグリッドをサポートしていません。

このモデルはApache License 2.0の下でリリースされており、サードパーティのコンポーネントは元のライセンスを保持しています。ユーザーは特定のライセンスの詳細についてソースファイルを確認することが推奨されています。

  • カテゴリーコンピュータービジョンツール
  • 料金モデルオープンソース
  • デプロイクラウド
  • プラットフォームWeb

  • 統合ビジョン・言語モデル

  • 物体レベルの知覚

  • ピクセルレベルの知覚

  • オープンボキャブラリーの物体検出

  • 参照セグメンテーション

  • プロンプト可能なアルファマッティング

  • 構造化された次トークン予測

  • 軽量ピクセルデコーダー

  1. モデルページにアクセス: Hugging Faceのモデルページを訪問

  2. 認証: Hugging Faceアカウントにログイン

  3. 設定: 必要なパラメータでモデルを設定

  4. プロンプトを送信: 処理のために視覚データを入力

  5. ファインチューニング: 特定のタスクに合わせてモデル設定を調整

  • 視覚的グラウンディング
  • 物体検出
  • 画像マッティング
  • OCRローカリゼーション
  • 参照セグメンテーション

WeVisOne-VL に似た人気のAIツール

Qwen2-VL-7B-Instructは、視覚理解と多言語サポートのために設計された高度なAIモデルです。画像や動画の処理に優れ、さまざまなベンチマークで最先端のパフォーマンスを提供します。このモデルは、視覚およびテキスト入力に基づく自動操作のためにデバイスとの統合をサポートします。

コンピュータービジョンツール
ツールを見る

視覚理解と多言語サポートのために設計された高度なAIモデルです。画像や動画の処理に優れ、さまざまなベンチマークで最先端のパフォーマンスを提供します。このモデルは、視覚およびテキスト入力に基づく自動操作のためにデバイスとの統合をサポートします。Qwen2-VL-7B-Instructは、視覚理解と多言語サポートのために設計された高度なAIモデルです。画像や動画の処理に優れ、さまざまなベンチマークで最先端のパフォーマンスを提供します。このモデルは、視覚およびテキスト入力に基づく自動操作のためにデバイスとの統合をサポートします。

コンピュータービジョンツール
AI モデル トップ5を見る

CLIP ViT-B/32

AI モデル

OpenAIによって開発されたclip-vit-base-patch32モデルは、ゼロショット画像分類タスクのために設計されています。これは、コンピュータビジョンにおける堅牢性と一般化を強化するために、ビジョントランスフォーマーアーキテクチャを利用しており、AI研究者にとって貴重なリソースとなっています。

コンピュータービジョンツール
ツールを見る

AI モデル

OpenAIによって開発されたclip-vit-base-patch32モデルは、ゼロショット画像分類タスクのために設計されています。これは、コンピュータビジョンにおける堅牢性と一般化を強化するために、ビジョントランスフォーマーアーキテクチャを利用しており、AI研究者にとって貴重なリソースとなっています。

注目コンピュータービジョンツール
AI モデル トップ5を見る

Florence-2は、Microsoftによって開発された高度なビジョン基盤モデルで、さまざまなビジョンおよびビジョン-言語タスクを処理するように設計されています。キャプショニングや物体検出などのタスクに対してプロンプトベースのアプローチを使用し、多様なデータセットを活用してマルチタスク学習を行います。

AIモデルとLLM
ツールを見る

Microsoftによって開発された高度なビジョン基盤モデルで、さまざまなビジョンおよびビジョン-言語タスクを処理するように設計されています。キャプショニングや物体検出などのタスクに対してプロンプトベースのアプローチを使用し、多様なデータセットを活用してマルチタスク学習を行います。Florence-2は、Microsoftによって開発された高度なビジョン基盤モデルで、さまざまなビジョンおよびビジョン-言語タスクを処理するように設計されています。キャプショニングや物体検出などのタスクに対してプロンプトベースのアプローチを使用し、多様なデータセットを活用してマルチタスク学習を行います。

AIモデルとLLM
AI モデル トップ5を見る

Qwen-VL

AI GitHub リポジトリ

Qwen-VLは、Alibaba Cloudによって開発された大規模なビジョン言語モデルです。チャットおよびビジョンタスクに対する高度な機能を提供し、これらの分野におけるAIアプリケーションのための堅牢なプラットフォームを提供します。

AIモデルとLLM
ツールを見る

AI GitHub リポジトリ

Alibaba Cloudによって開発された大規模なビジョン言語モデルです。チャットおよびビジョンタスクに対する高度な機能を提供し、これらの分野におけるAIアプリケーションのための堅牢なプラットフォームを提供します。Qwen-VLは、Alibaba Cloudによって開発された大規模なビジョン言語モデルです。チャットおよびビジョンタスクに対する高度な機能を提供し、これらの分野におけるAIアプリケーションのための堅牢なプラットフォームを提供します。

AIモデルとLLM
AI GitHub リポジトリ トップ250を見る

コンピュータビジョンツールボックスは、視覚検査、物体検出、特徴マッチングを含むコンピュータビジョンシステムの設計とテストのためのアルゴリズムとアプリを提供します。画像分類やセグメンテーションなどのタスクに対して、CNNやビジョントランスフォーマーなどのAI技術をサポートしています。

コンピュータービジョンツール
ツールを見る

視覚検査、物体検出、特徴マッチングを含むコンピュータビジョンシステムの設計とテストのためのアルゴリズムとアプリを提供します。画像分類やセグメンテーションなどのタスクに対して、CNNやビジョントランスフォーマーなどのAI技術をサポートしています。コンピュータビジョンツールボックスは、視覚検査、物体検出、特徴マッチングを含むコンピュータビジョンシステムの設計とテストのためのアルゴリズムとアプリを提供します。画像分類やセグメンテーションなどのタスクに対して、CNNやビジョントランスフォーマーなどのAI技術をサポートしています。

コンピュータービジョンツール
AI アプリ トップ250を見る

Ultralytics YOLO

AI GitHub リポジトリ

Ultralytics YOLOにはYOLO26、YOLO11、YOLOv8が含まれており、物体検出、インスタンスセグメンテーション、セマンティックセグメンテーション、画像分類、ポーズ推定、物体追跡の機能を提供します。これはコンピュータビジョンの分野における開発者や研究者向けに設計されています。

コンピュータービジョンツール

AI GitHub リポジトリで第18位

ツールを見る

AI GitHub リポジトリ

Ultralytics YOLOにはYOLO26、YOLO11、YOLOv8が含まれており、物体検出、インスタンスセグメンテーション、セマンティックセグメンテーション、画像分類、ポーズ推定、物体追跡の機能を提供します。これはコンピュータビジョンの分野における開発者や研究者向けに設計されています。

注目コンピュータービジョンツール
AI GitHub リポジトリで第18位

Qwen2-VL-72B-Instructは、最先端の視覚理解と多言語サポートのために設計された高度なAIモデルです。画像、動画、複雑な推論タスクの処理に優れており、AI駆動の環境における多様なアプリケーションに適しています。

AIモデルとLLM
ツールを見る

最先端の視覚理解と多言語サポートのために設計された高度なAIモデルです。画像、動画、複雑な推論タスクの処理に優れており、AI駆動の環境における多様なアプリケーションに適しています。Qwen2-VL-72B-Instructは、最先端の視覚理解と多言語サポートのために設計された高度なAIモデルです。画像、動画、複雑な推論タスクの処理に優れており、AI駆動の環境における多様なアプリケーションに適しています。

AIモデルとLLM
AI モデル トップ5を見る

Ultralytics

AI アプリ

データの注釈付け、YOLOモデルのトレーニング、そして世界中への展開を行うエンドツーエンドのコンピュータビジョンプラットフォームで、広く採用されているUltralytics YOLOオープンソースフレームワークを基盤としています。

コンピュータービジョンツール製造・工業

製造・工業で第6位

ツールを見る

AI アプリ

データの注釈付け、YOLOモデルのトレーニング、そして世界中への展開を行うエンドツーエンドのコンピュータビジョンプラットフォームで、広く採用されているUltralytics YOLOオープンソースフレームワークを基盤としています。

注目コンピュータービジョンツール製造・工業
製造・工業で第6位
1 / 8