メインコンテンツへスキップ
ToolPotion
AI アドバイザー
送信(無料)

Mage-VL-Cowork

LLM#78AIモデルとLLMオープンソース · Web

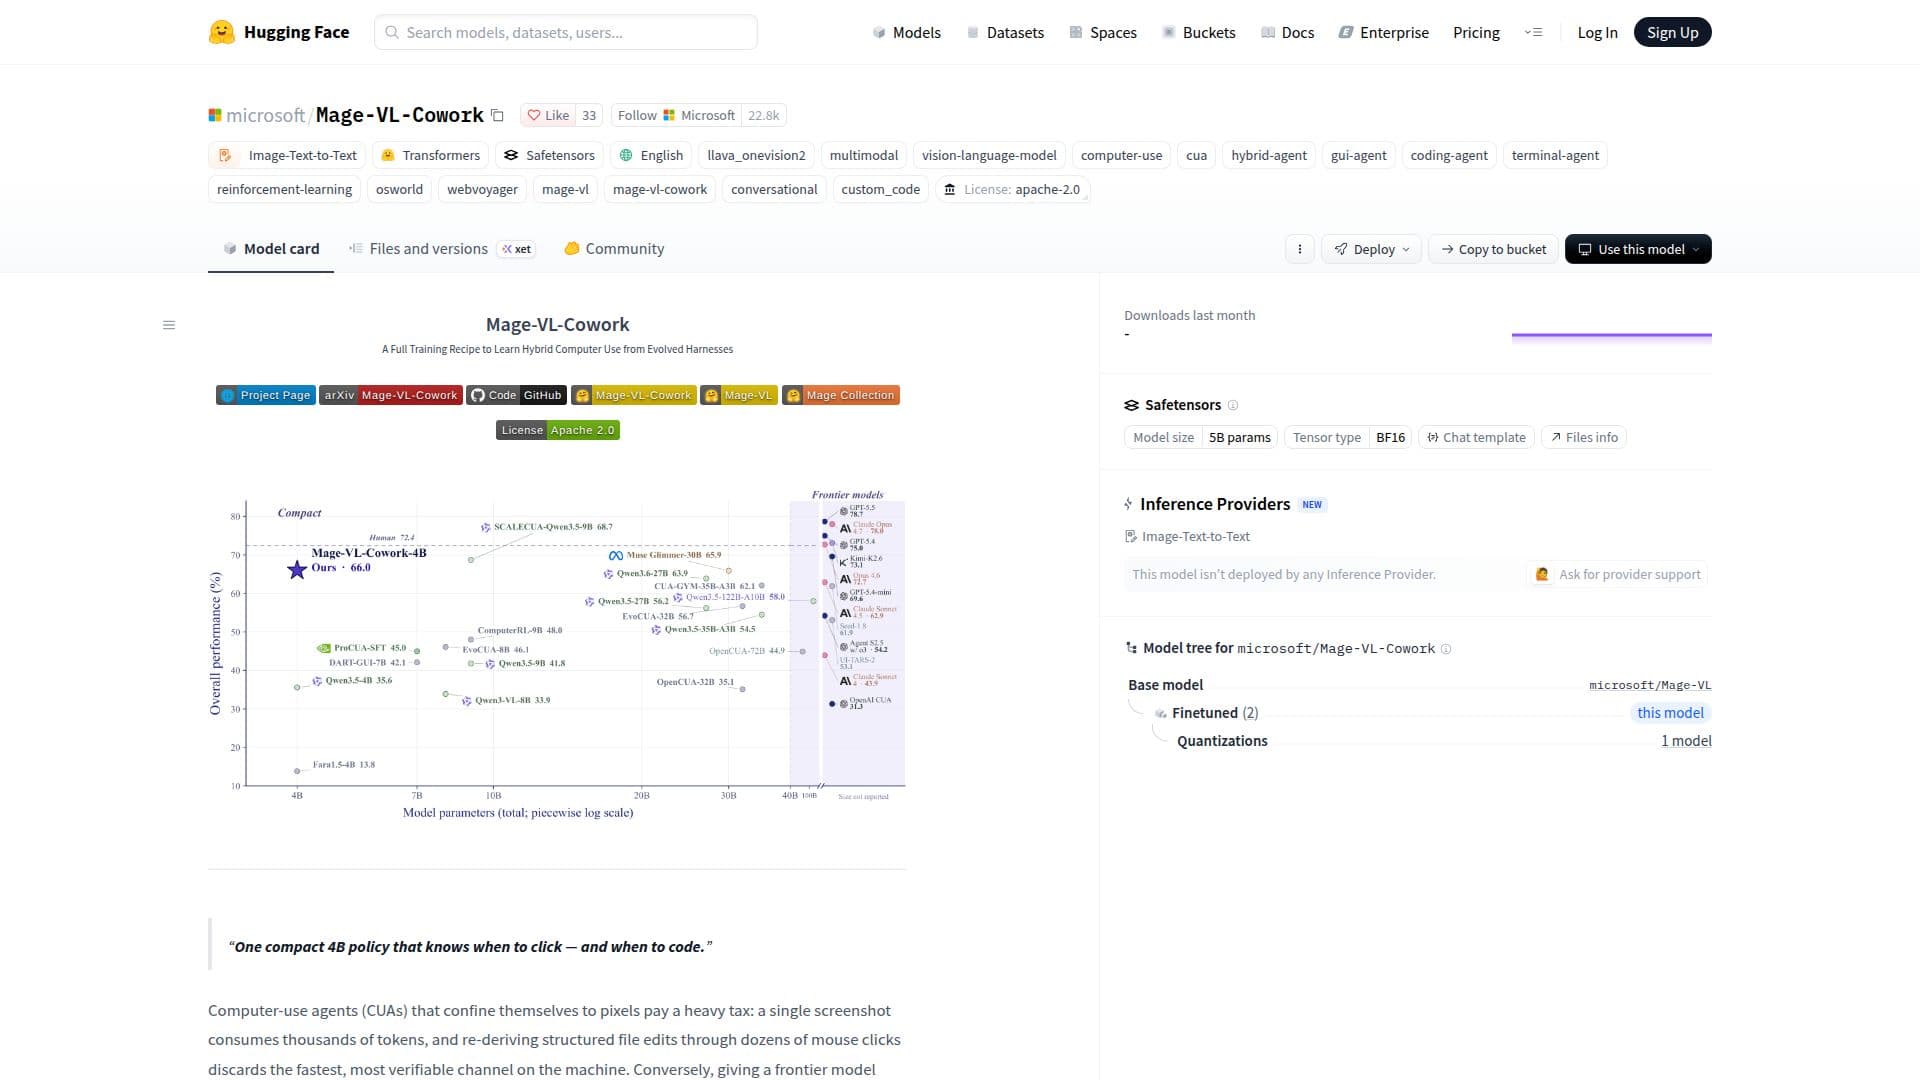
Mage-VL-Coworkは、Microsoftによって開発された4Bパラメータのマルチモーダルハイブリッドコンピュータ使用エージェントです。スクリーンショットに基づくGUIインタラクションと持続的なコード/ターミナル実行を単一のビジョン・ランゲージポリシー内で統合しています。このモデルは、複雑なコンピュータタスクに優れた性能を発揮し、そのスケールにおいて最高のパフォーマンスを示し、自律デスクトップエージェントのためのオンデバイスインテリジェンスの最前線を押し広げています。

URLを訪問
共有
Mage-VL-Cowork のスクリーンショット

Mage-VL-Coworkは、Microsoft Mageチームによって開発された高度な4Bパラメータのマルチモーダルハイブリッドコンピュータ使用エージェントです。これは、ピクセルベースのコンピュータ使用エージェント(CUA)と、GUIおよびターミナルツールへの単純なアクセスを持つエージェントとのギャップを埋めるように設計されています。このモデルは、スクリーンショットに基づくGUIインタラクション(`computer_use`)と持続的なコード/ターミナル実行(`bash`)を単一のビジョン・ランゲージポリシー内で組み合わせることにより、ハイブリッドな能力を実現し、外部オーケストレーターの必要性を排除します。

続きを読む

モデルのトレーニングは、初級の4B Mage-VLチェックポイントから始まる進行的な5段階の専門化・統合カリキュラムを含みます。このカリキュラムは、強力なスタンドアロンの視覚的基盤、GUI実行、およびコーディング/ターミナルの能力を構築し、その後、ハイブリッドSFTおよび非同期オンラインハイブリッドRLを通じて統合します。開発の重要な側面は、冗長なアクションルートを剪定し、ドメインライブラリを装備する教師ハーネスの進化であり、これにより学生の蒸留効果が大幅に向上します。

Mage-VL-Coworkは、作業フローを重視した合成エンジンであるMage-CUA-Forgeも活用しており、原子スキル全体にわたって膨大な数のタスクを生成し、再発生するタスク生成コストを大幅に削減します。このアプローチは、標準的なエージェントファースト構築方法と比較して、トークン消費と支出を削減します。

4BパラメータのMage-VL-Coworkは、50ステップの予算内でOSWorld-Verifiedで66.0%を達成し、そのサイズのモデルの中で最高のパフォーマンスを示しています。オペレーティングシステムタスク(87.5%)およびマルチアプリケーションワークフロー(62.7%)においても強力な実行を示します。モデルの効率は、オンライン強化学習によってさらに向上し、平均モデル呼び出しと出力トークンを同時に削減しながら、重要な精度向上をもたらします。その非対称作業メモリは、以前のターンを圧縮し、最近の視覚データと応答データを保持することにより、長期的なデスクトップタスクを管理します。

Mage-VL-CoworkはApache-2.0ライセンスの下でリリースされており、その自律的な能力のために、隔離された使い捨てのサンドボックス環境での展開を意図しています。カスタムマルチモーダルアーキテクチャをサポートし、GUIおよびターミナルインタラクションのための統一された二チャネル契約を含む特定の構成が必要です。

  • カテゴリーAIモデルとLLM
  • 料金モデルオープンソース
  • デプロイクラウド
  • プラットフォームWeb

  • ハイブリッドコンピュータ使用:単一のポリシー内でGUIインタラクションとターミナル実行を組み合わせます。

  • 4Bパラメータ:4Bスケールで最高のパフォーマンスを達成します。

  • マルチモーダルアーキテクチャ:llava_onevision2アーキテクチャに基づく画像-テキスト-テキストモデル。

  • 五段階トレーニングカリキュラム:包括的なスキル開発のための進行的な専門化・統合アプローチ。

  • 進化した教師ハーネス:学生の蒸留を強化し、効率を改善します。

  • ワークフロー優先環境合成(Mage-CUA-Forge):タスク生成コストとトークン消費を削減します。

  • 内部化されたターンレベルチャネルルーティング:最適な実行のためにGUIとbashの間で動的に選択します。

  • 高いOSWorld-Verifiedパフォーマンス:OSWorld-Verifiedタスクで66.0%を達成します。

  • 強力なOSおよびマルチアプリケーションワークフロー実行:OSタスクで87.5%、マルチアプリケーションワークフローで62.7%を達成します。

  • オンライン強化学習:精度を+10.16 pp向上させ、モデル呼び出し/出力トークンを削減します。

  • 非対称作業メモリ:折りたたまれたメモリとアクティブな視覚ウィンドウで長期タスクを管理します。

  • 統一チェックポイント:視覚的基盤、GUI操作、プログラム的操作、およびチャネル切り替えを処理します。

  • Apache-2.0ライセンス:使用および配布のためのオープンソースライセンス。

  • カスタムマルチモーダルアーキテクチャ:Qwen2_5_VLProcessorを使用したllava_onevision2。

  1. 依存関係のインストール:SGLang、PyTorch、およびTransformersを含む必要な環境を設定します。

  2. SGLangでの提供:提供されたDockerコンテナまたはカスタム環境を使用してGPU推論サーバーを起動します。

  3. マルチモーダルリクエストの構成:AutoProcessor.apply_chat_templateを使用してプロンプトをレンダリングし、base64画像ペイロードをSGLangの/generateエンドポイントに送信します。

  4. サンプリングパラメータの適用:温度0.7、top_p 0.8、max_new_tokens 4096などの推奨設定を使用します。

  5. システムプロンプトとツールスキーマの実装:computer_useとbashのための正確な統一二チャネル契約を使用します。

  6. オフラインTransformers推論の実施:提供された例を使用してモデルを推論に利用します。

  7. OSWorld-Verified評価の再現:SGLangランタイムを起動し、OSWorld-Verified評価ハーネスを実行します。

  8. 安全に展開:常にスコープ付きの認可とゼロの資格情報露出を持つ隔離されたサンドボックス環境でエージェントを実行します。

  • 自律デスクトップ自動化
  • GUIインタラクション
  • プログラム的ファイル編集
  • システム操作
  • ウェブ環境インタラクション
  • ソフトウェアエンジニアリングタスク
  • オンデバイスインテリジェンス
  • 研究開発

Microsoft の製品

Mage-VL-Cowork のレビュー

読み込み中...

Mage-VL-Cowork に似た人気のAIツール

DeepSeek-V4-Flash-Vision-Expは、視覚理解能力を強化するDeepSeek-V4ファミリーの実験的なマルチモーダルモデルです。DeepSeek-V4-Flashアーキテクチャに基づき、テキスト専用のパフォーマンスを維持しながら、マルチモーダルエージェントの能力を向上させます。

AIモデルとLLM

LLMで第70位

ツールを見る

視覚理解能力を強化するDeepSeek-V4ファミリーの実験的なマルチモーダルモデルです。DeepSeek-V4-Flashアーキテクチャに基づき、テキスト専用のパフォーマンスを維持しながら、マルチモーダルエージェントの能力を向上させます。DeepSeek-V4-Flash-Vision-Expは、視覚理解能力を強化するDeepSeek-V4ファミリーの実験的なマルチモーダルモデルです。DeepSeek-V4-Flashアーキテクチャに基づき、テキスト専用のパフォーマンスを維持しながら、マルチモーダルエージェントの能力を向上させます。

AIモデルとLLM
LLMで第70位

LiquidAI LFM2.5-2.6Bは、デバイス上での展開を目的としたハイブリッドモデルで、効率的な推論とエージェント機能を提供します。複数の言語をサポートし、さまざまなプラットフォームに最適化されているため、多様なアプリケーションに対応可能です。

AIモデルとLLM

LLMで第26位

ツールを見る

デバイス上での展開を目的としたハイブリッドモデルで、効率的な推論とエージェント機能を提供します。複数の言語をサポートし、さまざまなプラットフォームに最適化されているため、多様なアプリケーションに対応可能です。LiquidAI LFM2.5-2.6Bは、デバイス上での展開を目的としたハイブリッドモデルで、効率的な推論とエージェント機能を提供します。複数の言語をサポートし、さまざまなプラットフォームに最適化されているため、多様なアプリケーションに対応可能です。

AIモデルとLLM
LLMで第26位

OmniParserは、ユーザーインターフェースのスクリーンショットを構造化された要素に解析するための手法です。GPT-4Vのようなビジョン言語モデルがインターフェース上でアクションを生成する能力を向上させます。OmniParserは、インタラクティブなアイコンを識別し、要素のセマンティクスを理解することで、ベンチマークでのパフォーマンスを向上させます。さま…

AIモデルとLLM
ツールを見る

ユーザーインターフェースのスクリーンショットを構造化された要素に解析するための手法です。GPT-4Vのようなビジョン言語モデルがインターフェース上でアクションを生成する能力を向上させます。OmniParserは、インタラクティブなアイコンを識別し、要素のセマンティクスを理解することで、ベンチマークでのパフォーマンスを向上させます。さま…OmniParserは、ユーザーインターフェースのスクリーンショットを構造化された要素に解析するための手法です。GPT-4Vのようなビジョン言語モデルがインターフェース上でアクションを生成する能力を向上させます。OmniParserは、インタラクティブなアイコンを識別し、要素のセマンティクスを理解することで、ベンチマークでのパフォーマンスを向上させます。さま…

AIモデルとLLM
AI モデル トップ5を見る

Command A+ は、複雑な推論、視覚、48 言語にわたる多言語タスクのために設計された、25B のアクティブパラメータと 218B の総パラメータを持つ専門家の混合モデルです。企業向けに効率的で正確なソリューションを提供します。

AIモデルとLLM
ツールを見る

複雑な推論、視覚、48 言語にわたる多言語タスクのために設計された、25B のアクティブパラメータと 218B の総パラメータを持つ専門家の混合モデルです。企業向けに効率的で正確なソリューションを提供します。Command A+ は、複雑な推論、視覚、48 言語にわたる多言語タスクのために設計された、25B のアクティブパラメータと 218B の総パラメータを持つ専門家の混合モデルです。企業向けに効率的で正確なソリューションを提供します。

注目AIモデルとLLM
AI モデル トップ5を見る

Spark-X2.6-4Bは、デバイス上での展開を目的としたコンパクトな汎用言語モデルです。コーディング、マルチリンガル、推論能力が向上しており、実世界のタスクに取り組む開発者やユーザーに最適です。

AIモデルとLLM
ツールを見る

デバイス上での展開を目的としたコンパクトな汎用言語モデルです。コーディング、マルチリンガル、推論能力が向上しており、実世界のタスクに取り組む開発者やユーザーに最適です。Spark-X2.6-4Bは、デバイス上での展開を目的としたコンパクトな汎用言語モデルです。コーディング、マルチリンガル、推論能力が向上しており、実世界のタスクに取り組む開発者やユーザーに最適です。

AIモデルとLLM
LLM トップ100を見る

MiniMax-M3.1-Flashは、コーディング、エージェントワークフロー、サイバーセキュリティのために設計されたマルチモーダルなエキスパート混合モデルです。テキスト、画像、動画の入力をサポートし、スパースアテンションと量子化対応トレーニングにより、タスクのパフォーマンスと推論効率を向上させます。

AIモデルとLLM

LLMで第84位

ツールを見る

コーディング、エージェントワークフロー、サイバーセキュリティのために設計されたマルチモーダルなエキスパート混合モデルです。テキスト、画像、動画の入力をサポートし、スパースアテンションと量子化対応トレーニングにより、タスクのパフォーマンスと推論効率を向上させます。MiniMax-M3.1-Flashは、コーディング、エージェントワークフロー、サイバーセキュリティのために設計されたマルチモーダルなエキスパート混合モデルです。テキスト、画像、動画の入力をサポートし、スパースアテンションと量子化対応トレーニングにより、タスクのパフォーマンスと推論効率を向上させます。

AIモデルとLLM
LLMで第84位

LLaVA

AI GitHub リポジトリ

LLaVAは、大規模言語とビジョン機能を組み合わせたビジュアル指示チューニングモデルです。GPT-4Vレベルのパフォーマンスを目指し、マルチモーダルな理解とインタラクションを可能にします。このプロジェクトは、研究者や開発者向けにコード、モデル、リソースを提供します。

AIモデルとLLM
ツールを見る

AI GitHub リポジトリ

大規模言語とビジョン機能を組み合わせたビジュアル指示チューニングモデルです。GPT-4Vレベルのパフォーマンスを目指し、マルチモーダルな理解とインタラクションを可能にします。このプロジェクトは、研究者や開発者向けにコード、モデル、リソースを提供します。LLaVAは、大規模言語とビジョン機能を組み合わせたビジュアル指示チューニングモデルです。GPT-4Vレベルのパフォーマンスを目指し、マルチモーダルな理解とインタラクションを可能にします。このプロジェクトは、研究者や開発者向けにコード、モデル、リソースを提供します。

AIモデルとLLM
AI GitHub リポジトリ トップ250を見る

gptme - Agent in Terminal

AI エージェント

gptmeは、プロバイダーに依存せず、ローカルファーストのAIエージェントで、あらゆるターミナルで実行できます。コーディング、ナレッジワーク、自律エージェントタスクのための強力なCLIを提供し、多数のLLMプロバイダーと豊富なツール連携をサポートして生産性を向上させます。

AI コーディングアシスタント

AI エージェントで第219位

ツールを見る

AI エージェント

プロバイダーに依存せず、ローカルファーストのAIエージェントで、あらゆるターミナルで実行できます。コーディング、ナレッジワーク、自律エージェントタスクのための強力なCLIを提供し、多数のLLMプロバイダーと豊富なツール連携をサポートして生産性を向上させます。gptmeは、プロバイダーに依存せず、ローカルファーストのAIエージェントで、あらゆるターミナルで実行できます。コーディング、ナレッジワーク、自律エージェントタスクのための強力なCLIを提供し、多数のLLMプロバイダーと豊富なツール連携をサポートして生産性を向上させます。

AI コーディングアシスタント
AI エージェントで第219位
1 / 8