メインコンテンツへスキップ
ToolPotion
AI アドバイザー
送信(無料)

Mage-VL

LLM#20AIモデルとLLMオープンソース · Web

Mage-VLは、効率的な画像および動画理解のために設計されたコーデックネイティブなプロアクティブストリーミングマルチモーダル基盤モデルです。独自の視覚エンコーダーと因果デコーダーを活用し、リアルタイムストリーミングの認識を向上させながら、計算要求を削減します。

URLを訪問
共有
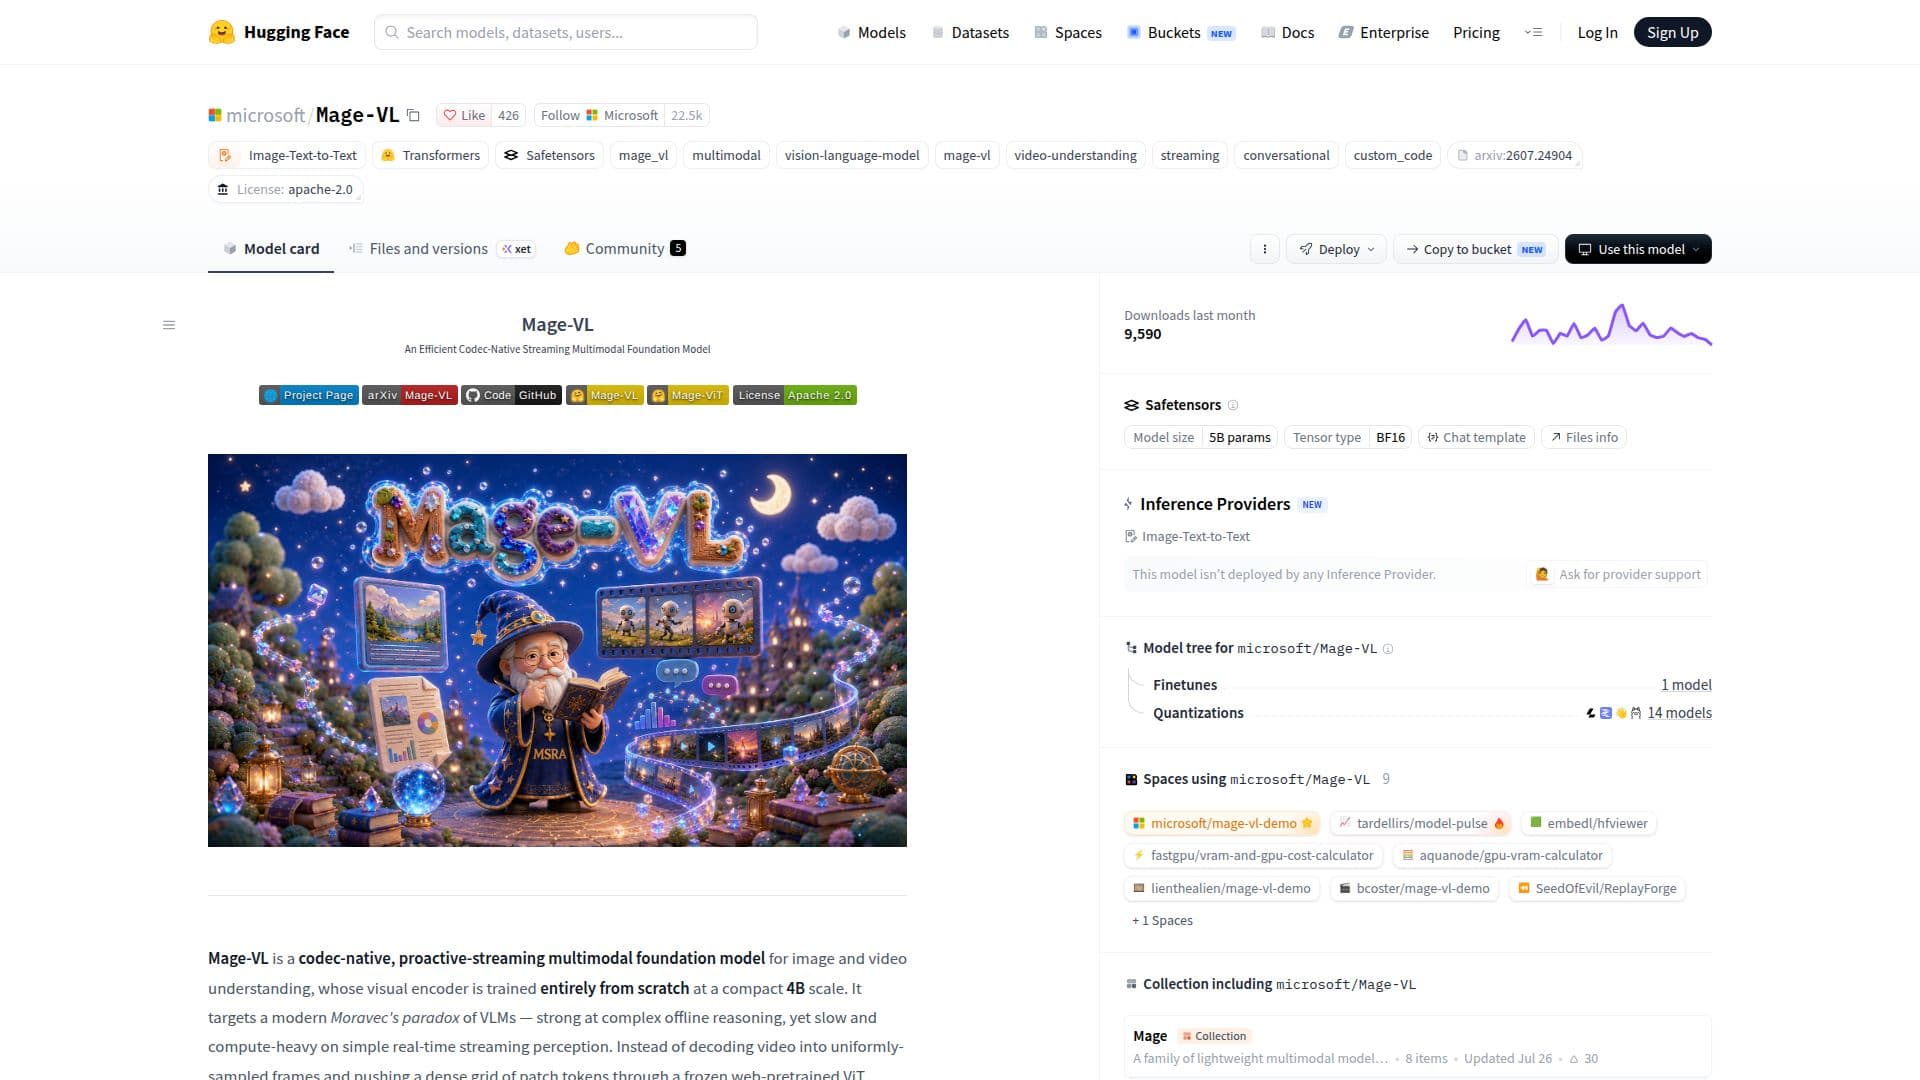
Mage-VL のスクリーンショット
Mage-VL のスクリーンショット

Mage-VLは、画像および動画理解の課題に対処するために開発された革新的なマルチモーダル基盤モデルです。視覚データを効率的に処理するコーデックネイティブなプロアクティブストリーミングモデルとして設計されています。このモデルの視覚エンコーダーであるMage-ViTは、ゼロからトレーニングされ、コンパクトな4Bスケールで動作します。このエンコーダーは、コーデック由来の空間的および時間的な重要性に基づいてトークンを割り当てる能力が独特であり、同じ計算予算の下で最大8倍長い動画を処理することができます。

続きを読む

Mage-VLのアーキテクチャには、唯一の事前トレーニングされたコンポーネントであるQwen3-4B因果デコーダーが含まれています。このデコーダーは、Mage-ViTと連携して可変長トークンストリームを処理し、異なる長さの画像と動画に対して統一されたインターフェースをサポートします。モデルの二重プロセス設計には、コンテンツを監視し、必要なときにのみ完全な視覚言語モデルをアクティブにするプロアクティブストリーミングを可能にする認知ゲートが組み込まれています。

このモデルのコーデックネイティブアプローチは、視覚トークンの消費を75%以上削減し、従来の方法と比較して3.5倍の推論速度向上を実現します。この効率性は、精度を損なうことなく達成されており、Mage-VLはリアルタイムの動画分析と理解のための強力なツールとなっています。

Mage-VLは特に動画理解と空間的知性に強く、いくつかのベンチマークで同等のモデルを上回っています。そのプロアクティブストリーミング機能は、SoccerNetストリーミングタスクでのパフォーマンスを通じて示されており、低遅延のイベントゲート付き解説を提供します。

全体として、Mage-VLはマルチモーダルAIモデルにおける重要な進展を表しており、複雑な視覚タスクに対するデータ効率の良いソリューションを提供します。そのオープンソースの性質と包括的な機能は、人工知能の分野における開発者や研究者にとって貴重なリソースとなります。

  • カテゴリーAIモデルとLLM
  • 料金モデルオープンソース
  • デプロイクラウド
  • プラットフォームWeb

  • コーデックネイティブ視覚エンコーダー

  • プロアクティブストリーミングゲート

  • Qwen3-4B因果デコーダー

  • 3.5倍の推論速度向上

  • データ効率の良いトークナイザー

  • 可変解像度の事前トレーニング

  • 画像と動画のための統一モデル

  • イベントゲート付き解説

  1. モデルページにアクセス: Hugging Faceリポジトリを訪問

  2. 認証: Hugging Faceアカウントの資格情報を使用

  3. 設定: モデルパラメータと環境を設定

  4. プロンプトを送信: 処理する画像または動画データを入力

  5. ファインチューニング: 特定のタスクに合わせてモデル設定を調整

  • リアルタイム動画分析
  • 空間知性
  • イベントゲート付き解説
  • 画像理解
  • プロアクティブストリーミング

Mage-VL に似た人気のAIツール

Qwen3.5-4Bは、高性能なマルチモーダル学習のために設計されたビジョンエンコーダーを備えた因果言語モデルです。201の言語をサポートし、スケーラブルな強化学習のための効率的なハイブリッドアーキテクチャを提供します。

AIモデルとLLM
ツールを見る

高性能なマルチモーダル学習のために設計されたビジョンエンコーダーを備えた因果言語モデルです。201の言語をサポートし、スケーラブルな強化学習のための効率的なハイブリッドアーキテクチャを提供します。Qwen3.5-4Bは、高性能なマルチモーダル学習のために設計されたビジョンエンコーダーを備えた因果言語モデルです。201の言語をサポートし、スケーラブルな強化学習のための効率的なハイブリッドアーキテクチャを提供します。

AIモデルとLLM
AI モデル トップ5を見る

DeepSeek-V4-Flash-Vision-Expは、視覚理解能力を強化するDeepSeek-V4ファミリーの実験的なマルチモーダルモデルです。DeepSeek-V4-Flashアーキテクチャに基づき、テキスト専用のパフォーマンスを維持しながら、マルチモーダルエージェントの能力を向上させます。

AIモデルとLLM
ツールを見る

視覚理解能力を強化するDeepSeek-V4ファミリーの実験的なマルチモーダルモデルです。DeepSeek-V4-Flashアーキテクチャに基づき、テキスト専用のパフォーマンスを維持しながら、マルチモーダルエージェントの能力を向上させます。DeepSeek-V4-Flash-Vision-Expは、視覚理解能力を強化するDeepSeek-V4ファミリーの実験的なマルチモーダルモデルです。DeepSeek-V4-Flashアーキテクチャに基づき、テキスト専用のパフォーマンスを維持しながら、マルチモーダルエージェントの能力を向上させます。

AIモデルとLLM
LLM トップ50を見る

MiniMax M3は、コーディングとエージェンティックタスクに優れた高度なAIモデルです。1Mのコンテキストウィンドウとネイティブなマルチモーダル理解を備え、MSAアーキテクチャによって支えられています。このモデルはオープンウェイト機能を提供し、開発者や研究者にとって多用途なツールとなっています。

AIモデルとLLM

LLMで第48位

ツールを見る

コーディングとエージェンティックタスクに優れた高度なAIモデルです。1Mのコンテキストウィンドウとネイティブなマルチモーダル理解を備え、MSAアーキテクチャによって支えられています。このモデルはオープンウェイト機能を提供し、開発者や研究者にとって多用途なツールとなっています。MiniMax M3は、コーディングとエージェンティックタスクに優れた高度なAIモデルです。1Mのコンテキストウィンドウとネイティブなマルチモーダル理解を備え、MSAアーキテクチャによって支えられています。このモデルはオープンウェイト機能を提供し、開発者や研究者にとって多用途なツールとなっています。

AIモデルとLLM
LLMで第48位

Ideogram 4

AI モデル

Ideogram 4は、画像の構成、スタイル、レイアウトに対する比類のない制御を提供する最先端のテキストから画像へのモデルです。ネイティブ2k解像度と多言語テキストレンダリングをサポートしており、デザイン指向のアプリケーションに最適です。

AIモデルとLLM
ツールを見る

AI モデル

画像の構成、スタイル、レイアウトに対する比類のない制御を提供する最先端のテキストから画像へのモデルです。ネイティブ2k解像度と多言語テキストレンダリングをサポートしており、デザイン指向のアプリケーションに最適です。Ideogram 4は、画像の構成、スタイル、レイアウトに対する比類のない制御を提供する最先端のテキストから画像へのモデルです。ネイティブ2k解像度と多言語テキストレンダリングをサポートしており、デザイン指向のアプリケーションに最適です。

AIモデルとLLM
AI モデル トップ5を見る

SmolVLM2は、さまざまなデバイスで効率的に動作するように設計された高度なビデオ理解モデルです。ビデオ分析と視覚的推論の能力を強化し、異なるプラットフォームでのビデオ理解を可能にします。

AIモデルとLLM
ツールを見る

さまざまなデバイスで効率的に動作するように設計された高度なビデオ理解モデルです。ビデオ分析と視覚的推論の能力を強化し、異なるプラットフォームでのビデオ理解を可能にします。SmolVLM2は、さまざまなデバイスで効率的に動作するように設計された高度なビデオ理解モデルです。ビデオ分析と視覚的推論の能力を強化し、異なるプラットフォームでのビデオ理解を可能にします。

AIモデルとLLM
AI モデル トップ5を見る

Pixtral-12B-2409は、12億のパラメータと4億のパラメータを持つビジョンエンコーダを備えたマルチモーダルAIモデルで、高度な画像およびテキスト処理タスクのために設計されています。

AIモデルとLLM
ツールを見る

12億のパラメータと4億のパラメータを持つビジョンエンコーダを備えたマルチモーダルAIモデルで、高度な画像およびテキスト処理タスクのために設計されています。Pixtral-12B-2409は、12億のパラメータと4億のパラメータを持つビジョンエンコーダを備えたマルチモーダルAIモデルで、高度な画像およびテキスト処理タスクのために設計されています。

AIモデルとLLM
AI モデル トップ5を見る

V-JEPA

AI GitHub リポジトリ

V-JEPAは、ビデオからの自己教師あり学習のためのPyTorch実装です。人間によるアノテーションやピクセルレベルの再構築なしに視覚的表現を学習するために、共同埋め込み予測アーキテクチャを利用します。コードとモデルは、多様な下流のビデオおよび画像タスク向けに設計されています。

AIモデルとLLM
ツールを見る

AI GitHub リポジトリ

ビデオからの自己教師あり学習のためのPyTorch実装です。人間によるアノテーションやピクセルレベルの再構築なしに視覚的表現を学習するために、共同埋め込み予測アーキテクチャを利用します。コードとモデルは、多様な下流のビデオおよび画像タスク向けに設計されています。V-JEPAは、ビデオからの自己教師あり学習のためのPyTorch実装です。人間によるアノテーションやピクセルレベルの再構築なしに視覚的表現を学習するために、共同埋め込み予測アーキテクチャを利用します。コードとモデルは、多様な下流のビデオおよび画像タスク向けに設計されています。

AIモデルとLLM
AI GitHub リポジトリ トップ250を見る

LTX-2

AI モデル

LTX-2は、同期したビデオとオーディオを生成するために設計されたDiTベースのオーディオビデオ基盤モデルです。最新のビデオ生成技術とオープンウェイトを組み合わせており、さまざまなアプリケーションに対して実用的なローカル実行を可能にします。

AIモデルとLLM
ツールを見る

AI モデル

同期したビデオとオーディオを生成するために設計されたDiTベースのオーディオビデオ基盤モデルです。最新のビデオ生成技術とオープンウェイトを組み合わせており、さまざまなアプリケーションに対して実用的なローカル実行を可能にします。LTX-2は、同期したビデオとオーディオを生成するために設計されたDiTベースのオーディオビデオ基盤モデルです。最新のビデオ生成技術とオープンウェイトを組み合わせており、さまざまなアプリケーションに対して実用的なローカル実行を可能にします。

注目AIモデルとLLM
AI モデル トップ5を見る
1 / 8