メインコンテンツへスキップ
ToolPotion
AI アドバイザー
送信(無料)

DiffusionGemma

LLMAIモデルとLLMOpen Weights · Web

DiffusionGemmaは、Google DeepMindによって開発された生成モデルで、Gemma 4アーキテクチャに基づいています。テキスト、画像、動画の入力を処理し、テキスト出力を生成し、さまざまなハードウェア環境での速度と効率を最適化します。

URLを訪問
共有
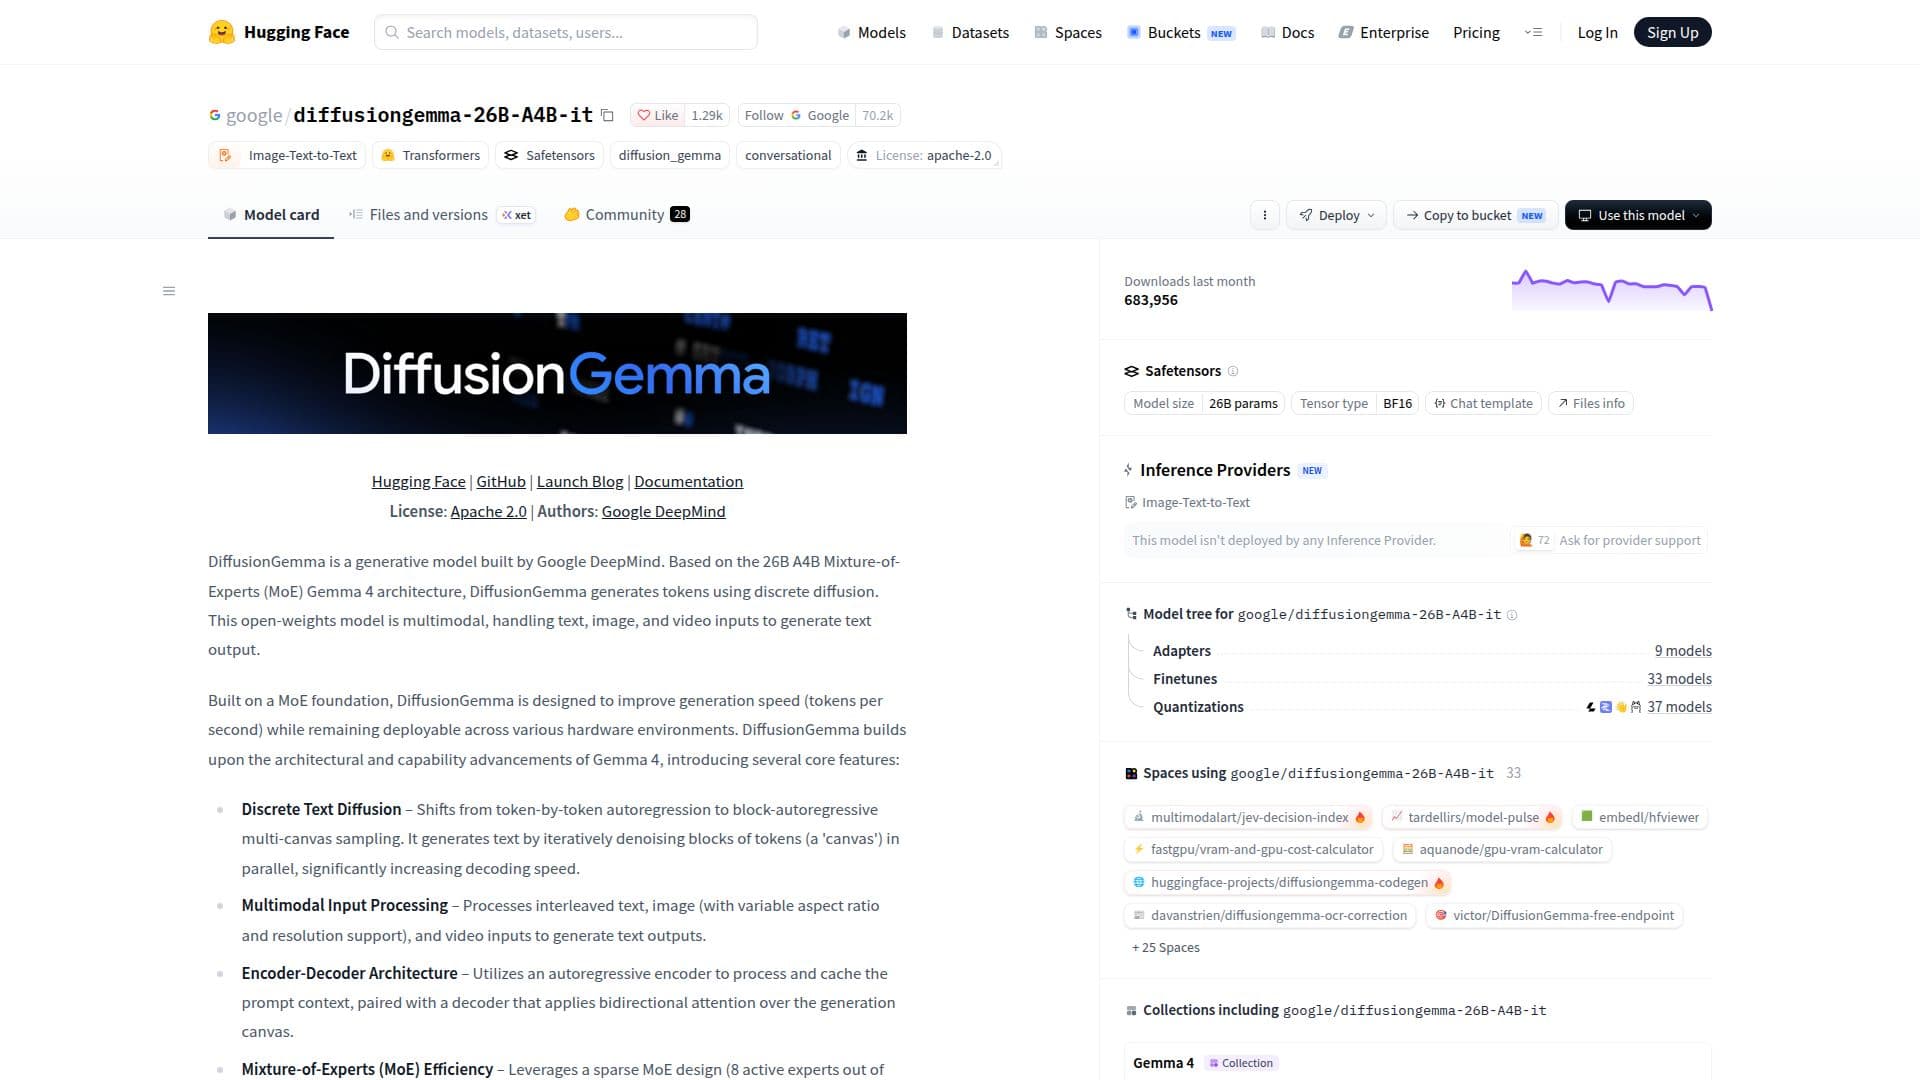
DiffusionGemma のスクリーンショット

DiffusionGemmaは、Google DeepMindによって開発された生成モデルで、26B A4B Mixture-of-Experts (MoE) Gemma 4アーキテクチャを活用しています。テキスト、画像、動画を含むマルチモーダル入力からテキスト出力を生成するように設計されています。このモデルは、トークン生成速度を向上させるために離散拡散を採用しており、多様なハードウェア環境での展開に適しています。

続きを読む

モデルのアーキテクチャは、ブロック自己回帰型マルチキャンバスサンプリング手法を特徴としており、トークンのブロックを並行してデノイズすることでデコーディング速度を大幅に向上させます。このアプローチにより、DiffusionGemmaは従来の自己回帰モデルと比較して、より高速にテキストを生成することができます。エンコーダ-デコーダアーキテクチャは、プロンプトコンテキストを処理しキャッシュするために自己回帰型エンコーダを使用し、デコーダは生成キャンバス上で双方向注意を適用します。

DiffusionGemmaのスパースMoE設計は、128のアクティブエキスパートのうち8つを使用しており、強力な推論能力を提供しながら低いメモリフットプリントを維持します。この効率性により、ローカル実行に適しており、小さなバッチサイズの推論に最適化されており、単一の能力のあるアクセラレータ上で高速生成を実現します。

このモデルは、構造化された制御可能な会話を可能にするネイティブシステムプロンプトの更新をサポートしています。また、強化された推論能力のための構成可能な思考モードも含まれています。最大256Kトークンのコンテキストウィンドウを持つDiffusionGemmaは、長いコンテキストタスクを効果的に処理できます。

DiffusionGemmaは、さまざまなベンチマークに対して評価されており、テキスト生成および推論タスクにおいて競争力のあるパフォーマンスを示しています。140以上の言語で事前トレーニングされており、多言語機能をサポートし、オブジェクト検出、文書解析、動画コンテンツ分析などの堅牢な画像および動画理解機能を提供します。

全体として、DiffusionGemmaは、高速でマルチモーダルなテキスト生成を目的とした多用途なモデルであり、コンテンツ作成、研究、教育などの幅広いアプリケーションに適しています。

  • カテゴリーAIモデルとLLM
  • 料金モデルOpen Weights
  • デプロイクラウド
  • プラットフォームWeb

  • 離散テキスト拡散

  • マルチモーダル入力処理

  • エンコーダ-デコーダアーキテクチャ

  • Mixture-of-Expertsの効率性

  • 思考モード

  • 小さなバッチサイズの推論に最適化

  • ネイティブシステムプロンプトサポート

  • 長いコンテキスト処理

  1. モデルページにアクセス: Hugging Faceモデルページを訪問

  2. 認証: ログインまたはアカウントを作成

  3. 設定: モデルパラメータを設定

  4. プロンプトを送信: テキスト、画像、または動画のプロンプトを入力

  5. ファインチューニング: 特定のタスクに合わせて設定を調整

  • テキスト生成
  • 画像データ抽出
  • 動画理解
  • 多言語サポート
  • 研究と教育

Google DeepMind の製品

DiffusionGemma のレビュー

読み込み中...

DiffusionGemma に似た人気のAIツール

Google DeepMindによるGemma 4 12B統合モデルは、効率的なローカル実行のために設計されたマルチモーダルAIモデルです。テキスト、画像、音声入力をサポートし、大きなコンテキストウィンドウを持つ高度な推論およびコーディング機能を提供します。

AIモデルとLLM
ツールを見る

Google DeepMindによるGemma 4 12B統合モデルは、効率的なローカル実行のために設計されたマルチモーダルAIモデルです。テキスト、画像、音声入力をサポートし、大きなコンテキストウィンドウを持つ高度な推論およびコーディング機能を提供します。

AIモデルとLLM
AI モデル トップ5を見る

Gemmaは、Geminiモデルを支えるのと同じ技術を基に構築された軽量でオープンなモデルのコレクションです。これにより、開発者はさまざまなプラットフォーム向けにAIアプリケーションを作成し、モバイルおよびIoTデバイスにおける効率と知性を向上させることができます。

AIモデルとLLM
ツールを見る

Geminiモデルを支えるのと同じ技術を基に構築された軽量でオープンなモデルのコレクションです。これにより、開発者はさまざまなプラットフォーム向けにAIアプリケーションを作成し、モバイルおよびIoTデバイスにおける効率と知性を向上させることができます。Gemmaは、Geminiモデルを支えるのと同じ技術を基に構築された軽量でオープンなモデルのコレクションです。これにより、開発者はさまざまなプラットフォーム向けにAIアプリケーションを作成し、モバイルおよびIoTデバイスにおける効率と知性を向上させることができます。

注目AIモデルとLLM
AI モデル トップ5を見る

DeepSeek-V3は、6710億のパラメータを持つMixture-of-Experts言語モデルで、効率的な推論とコスト効果の高いトレーニングを目的としています。自然言語処理タスクにおいて強力なパフォーマンスを示し、さまざまなベンチマークで優れた結果を出しています。

AIモデルとLLM

LLMで第31位

ツールを見る

6710億のパラメータを持つMixture-of-Experts言語モデルで、効率的な推論とコスト効果の高いトレーニングを目的としています。自然言語処理タスクにおいて強力なパフォーマンスを示し、さまざまなベンチマークで優れた結果を出しています。DeepSeek-V3は、6710億のパラメータを持つMixture-of-Experts言語モデルで、効率的な推論とコスト効果の高いトレーニングを目的としています。自然言語処理タスクにおいて強力なパフォーマンスを示し、さまざまなベンチマークで優れた結果を出しています。

注目AIモデルとLLM
LLMで第31位

Inkling-Smallは、テキスト、画像、音声入力を処理してテキスト出力を生成する多用途のマルチモーダルモデルです。開放された重みを持ち、研究や統合をサポートし、チャットボットやコーディングアシスタントなどのAIアプリケーションの開発を支援します。

AIモデルとLLM

LLMで第27位

ツールを見る

テキスト、画像、音声入力を処理してテキスト出力を生成する多用途のマルチモーダルモデルです。開放された重みを持ち、研究や統合をサポートし、チャットボットやコーディングアシスタントなどのAIアプリケーションの開発を支援します。Inkling-Smallは、テキスト、画像、音声入力を処理してテキスト出力を生成する多用途のマルチモーダルモデルです。開放された重みを持ち、研究や統合をサポートし、チャットボットやコーディングアシスタントなどのAIアプリケーションの開発を支援します。

AIモデルとLLM
LLMで第27位

DeepSeek-V4-Proは、効率的な百万トークンコンテキストインテリジェンスのために設計された高度なAIモデルです。ハイブリッドアテンションアーキテクチャを特徴とし、32兆トークン以上で事前学習されており、複雑な推論タスクやコーディングベンチマークに適しています。

AIモデルとLLM
ツールを見る

効率的な百万トークンコンテキストインテリジェンスのために設計された高度なAIモデルです。ハイブリッドアテンションアーキテクチャを特徴とし、32兆トークン以上で事前学習されており、複雑な推論タスクやコーディングベンチマークに適しています。DeepSeek-V4-Proは、効率的な百万トークンコンテキストインテリジェンスのために設計された高度なAIモデルです。ハイブリッドアテンションアーキテクチャを特徴とし、32兆トークン以上で事前学習されており、複雑な推論タスクやコーディングベンチマークに適しています。

注目AIモデルとLLM
LLM トップ50を見る

ImagenはGoogle Researchが開発したテキストから画像を生成する拡散モデルです。言語を深く理解し、フォトリアルな画像を生成します。Imagenは画像とテキストの整合性およびサンプルの忠実性に優れており、人間の評価で他のモデルを凌駕し、COCOなどのベンチマークで最先端のFIDスコアを達成しています。

AIモデルとLLM
ツールを見る

Google Researchが開発したテキストから画像を生成する拡散モデルです。言語を深く理解し、フォトリアルな画像を生成します。Imagenは画像とテキストの整合性およびサンプルの忠実性に優れており、人間の評価で他のモデルを凌駕し、COCOなどのベンチマークで最先端のFIDスコアを達成しています。ImagenはGoogle Researchが開発したテキストから画像を生成する拡散モデルです。言語を深く理解し、フォトリアルな画像を生成します。Imagenは画像とテキストの整合性およびサンプルの忠実性に優れており、人間の評価で他のモデルを凌駕し、COCOなどのベンチマークで最先端のFIDスコアを達成しています。

AIモデルとLLM
AI モデル トップ5を見る

Gemma-3n-E4B-itは、Googleによって開発された軽量で最先端のAIモデルで、リソースの少ないデバイスでの効率的な実行を目的としています。テキスト、画像、動画、音声のマルチモーダル入力をサポートし、事前学習済みおよび指示調整済みのバリアントのオープンウェイトでテキスト出力を生成します。

AIモデルとLLM
ツールを見る

Googleによって開発された軽量で最先端のAIモデルで、リソースの少ないデバイスでの効率的な実行を目的としています。テキスト、画像、動画、音声のマルチモーダル入力をサポートし、事前学習済みおよび指示調整済みのバリアントのオープンウェイトでテキスト出力を生成します。Gemma-3n-E4B-itは、Googleによって開発された軽量で最先端のAIモデルで、リソースの少ないデバイスでの効率的な実行を目的としています。テキスト、画像、動画、音声のマルチモーダル入力をサポートし、事前学習済みおよび指示調整済みのバリアントのオープンウェイトでテキスト出力を生成します。

AIモデルとLLM
AI モデル トップ5を見る

Hy4 Previewは、Tencent Hyチームによって開発された新世代のMixture-of-Expertsモデルです。7700億のパラメータを特徴とし、ソフトウェアエンジニアリング、ゲーム開発、科学研究など、さまざまな分野での生産性向上を目的としています。

AIモデルとLLM

LLMで第35位

ツールを見る

Tencent Hyチームによって開発された新世代のMixture-of-Expertsモデルです。7700億のパラメータを特徴とし、ソフトウェアエンジニアリング、ゲーム開発、科学研究など、さまざまな分野での生産性向上を目的としています。Hy4 Previewは、Tencent Hyチームによって開発された新世代のMixture-of-Expertsモデルです。7700億のパラメータを特徴とし、ソフトウェアエンジニアリング、ゲーム開発、科学研究など、さまざまな分野での生産性向上を目的としています。

AIモデルとLLM
LLMで第35位
1 / 8