説明
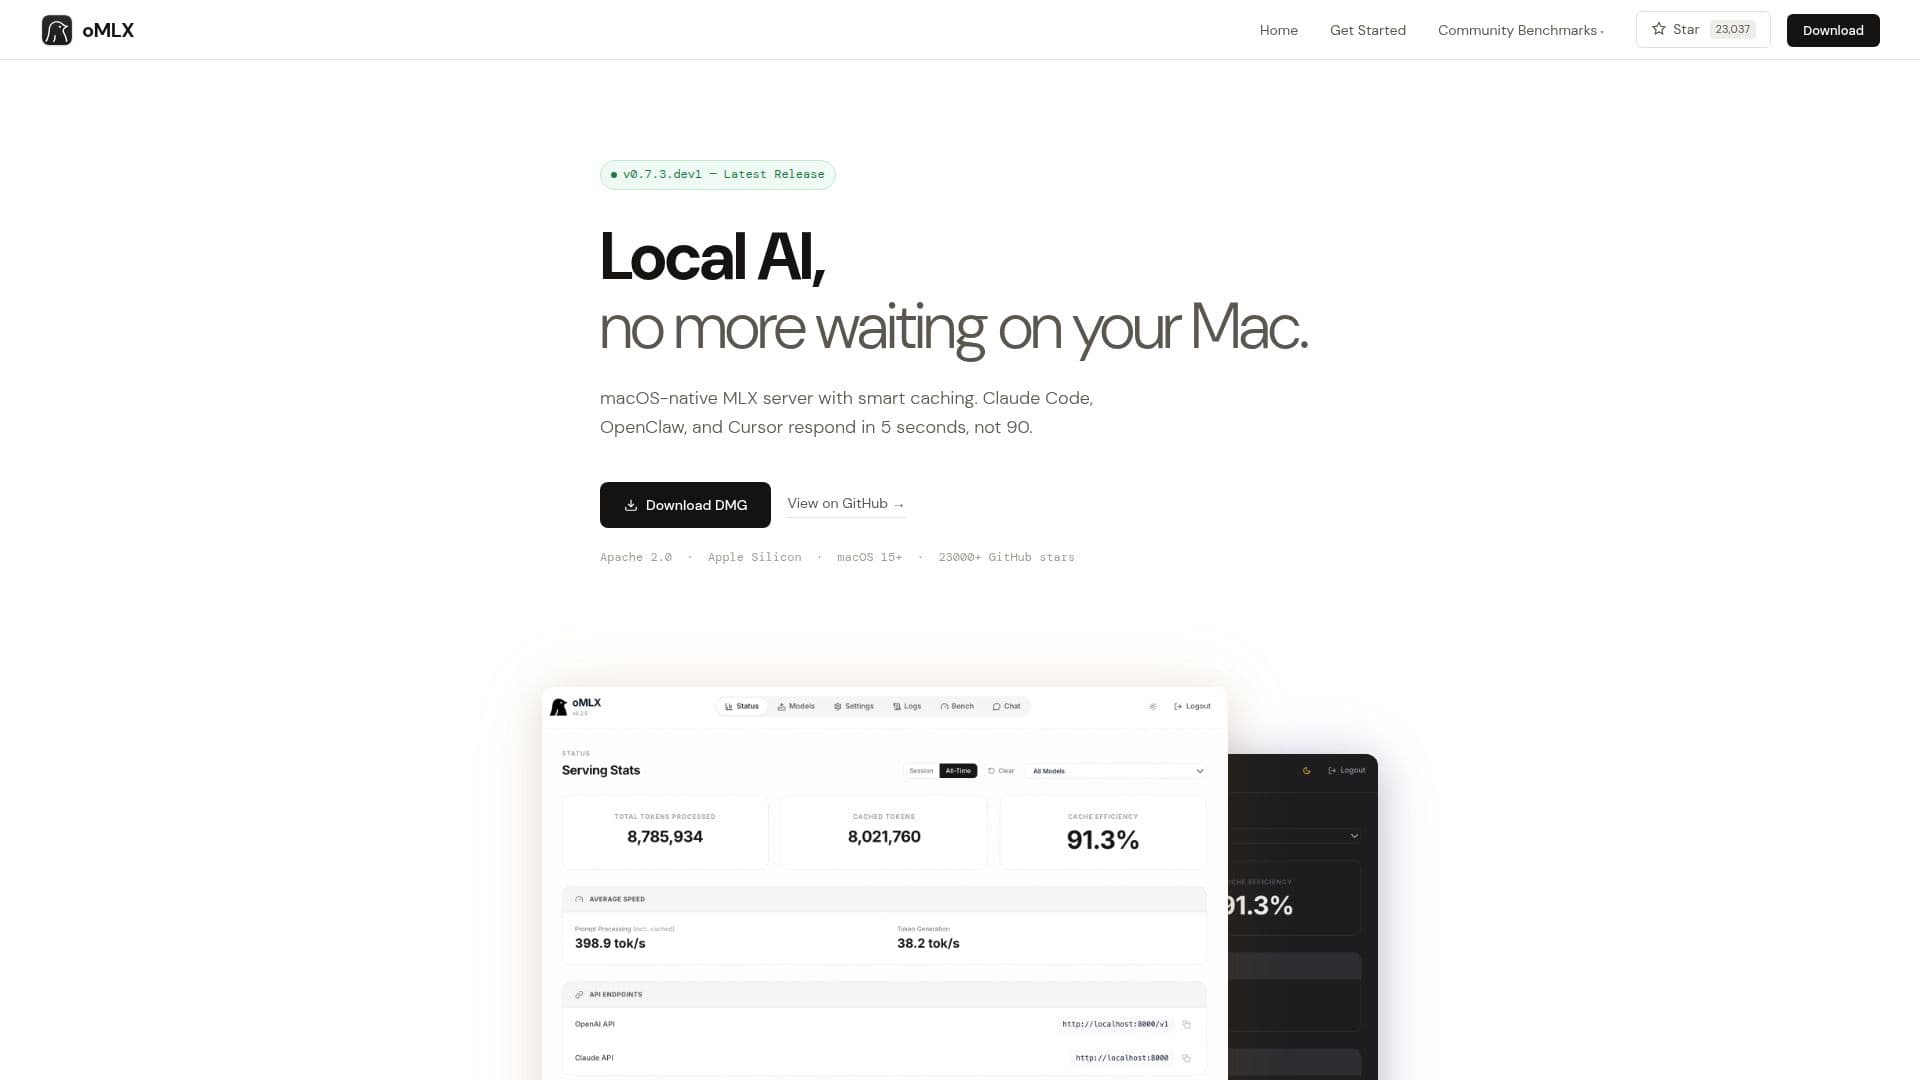
oMLXは、Apple Siliconの力を活用してmacOS専用に設計された最先端の推論サーバーです。MLXフレームワークに基づいて構築されており、Macコンピュータ上で大規模言語モデル(LLM)をローカルで実行するためのネイティブソリューションを提供します。その際立った特徴の一つは、ページングされたSSD KVキャッシングで、通常の30-90秒からTTFTを5秒未満に大幅に短縮します。この改善は、キャッシュを頻繁に無効にするコーディングエージェントに特に有益であり、oMLXはすべてのキャッシュブロックをSSDに永続化することで、ディスクからの迅速な復元を可能にします。
続きを読む
このサーバーは、OpenAIやAnthropicなどの人気APIと互換性があり、これらのプラットフォームで作業する開発者にとって多用途なツールです。連続バッチ処理をサポートし、Claude Code、OpenClaw、Cursorなどのモデル用のドロップインAPIを提供し、応答を数秒で提供します。512GB RAMを搭載したM3 Ultraで実施されたパフォーマンスベンチマークは、さまざまなコンテキストやバッチサイズにおいて印象的なスループットとメモリ効率を示しています。
oMLXは、Mac上で信頼性が高く迅速なローカルAIソリューションを必要とする開発者やAI愛好者のために設計されています。クラウドベースの推論の必要性を排除し、レイテンシと外部サーバーへの依存を減らします。このツールはApache 2.0ライセンスの下でオープンソースであり、23,000以上のGitHubスターによって強力なコミュニティの存在が示されています。ユーザーはDMGをダウンロードするか、ソースからインストールすることで簡単に始めることができ、標準のHugging FaceキャッシュやLM Studioフォルダーとの互換性があります。
全体として、oMLXはmacOS上でAIモデルをローカルに実行するための堅牢で効率的なソリューションを提供し、速度の大幅な向上と既存のAIワークフローとのシームレスな統合を実現します。
- カテゴリーMLOps・モデルデプロイ
- 料金モデルオープンソース
- デプロイローカル
- プラットフォームmacOS 15+
oMLXの主要機能
ネイティブmacOS推論サーバー
ページングされたSSD KVキャッシング
OpenAIおよびAnthropic APIとの互換性
連続バッチ処理のサポート
Claude Code、OpenClaw、Cursor用のドロップインAPI
SSDからの迅速なキャッシュ復元
Apache 2.0の下でオープンソース
23,000以上のGitHubスター
oMLXの使い方は?
ダウンロード: DMGまたはソースを取得
インストール: インストール手順に従う
設定: Hugging Faceキャッシュで設定
使用: 短縮されたTTFTでモデルを実行
最適化: 連続バッチ処理を活用
oMLXの使用例
- ローカルAI開発
- API統合
- コーディングエージェント
- バッチ処理
- オープンソース貢献