メインコンテンツへスキップ
ToolPotion
AI アドバイザー
送信(無料)

evalship

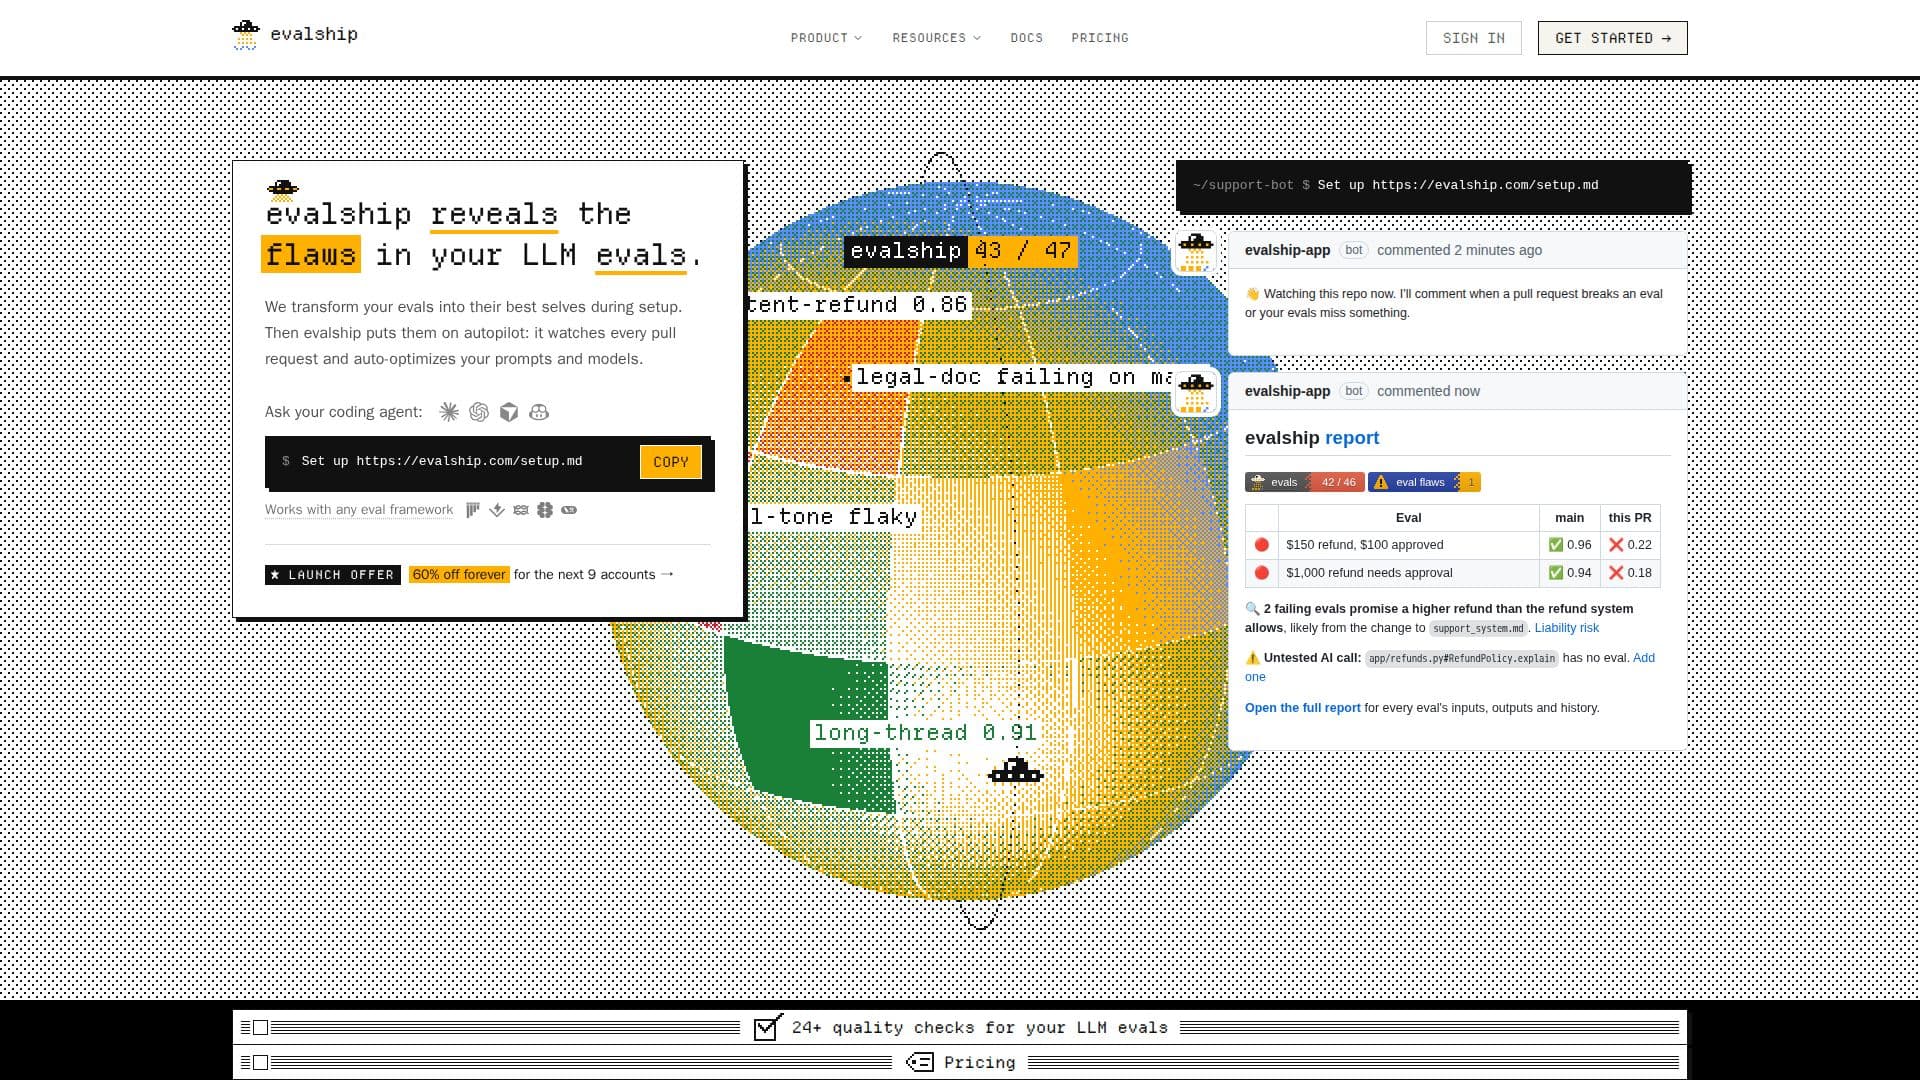
evalshipは、LLM評価の品質管理を提供し、欠陥を特定し、プロンプトとモデルを最適化します。既存の評価フレームワークと統合し、プルリクエストに対して何が壊れたのか、なぜ壊れたのかの詳細な内訳をコメントし、AI呼び出しが徹底的にテストされることを助けます。このプラットフォームは、あなたのLLM評価を自動化し、信頼性とパフォーマンスを向上させることを目指しています。

URLを訪問
共有
evalship のスクリーンショット
evalship のスクリーンショット

evalshipは、特に大規模言語モデル(LLM)評価のために設計された包括的な品質管理ソリューションを提供します。GitHubワークフローに直接統合され、あなたのLLM開発プロセスのための警戒心の強い守護者として機能します。evalshipの主な目的は、評価設定の欠陥を特定し、対処することであり、あなたのLLMが期待通りに機能し、回帰を引き起こさないことを保証します。

続きを読む

セットアップ後、evalshipは既存の評価者、審査員、プロンプトを徹底的にレビューし、誤って合格する評価や適切なテストカバレッジが欠如しているルールなどの弱点を特定します。その後、すべてのプルリクエストを監視し、何が壊れたのか、なぜ壊れたのか、そしてその原因を即座にフィードバックします。これには、未テストのAI呼び出しをフラグ付けし、デフォルトブランチでの過去のパフォーマンスを分析することによって、真の回帰と不安定な評価結果を区別することが含まれます。

このプラットフォームは、JUnit XML、promptfoo JSON、evalship JSONを生成するさまざまな評価フレームワークとシームレスに連携します。pytest、Vitest、Jest、RSpec、Go、Java、PHPUnit、Rust、Langfuse、Braintrust、LangSmithなどが含まれます。evalshipは、評価を直接実行するのではなく、あなたのGitHub ActionsワークフローまたはコーディングエージェントがAPIキーを使用してそれらを実行し、evalshipが結果を処理します。

問題を特定するだけでなく、evalshipはプロンプトとモデルの最適化を助けます。コーディングエージェントを通じて、より安価なモデルや明確なルールなど、さまざまな変更をあなたのマシンでテストし、どの変更が統計的に有意な改善をもたらすかを報告します。これにより、チームはモデルのパフォーマンスとコスト効率を向上させるためのデータ駆動型の意思決定を行うことができます。evalshipはまた、評価のパフォーマンスを要約し、プロダクションに到達する前に発見された重要な問題を強調する週次レポートを提供します。

料金には、パブリックリポジトリ用の無料プランと1人のユーザーによる1つのプライベートリポジトリが含まれ、100件のPR分析と30日間の評価履歴を提供します。有料プラン(チーム、プロ、ビジネス)は、ユーザー数、プライベートリポジトリ、PR分析、長期の評価履歴を増加させ、月額または年額の請求オプションがあります。ローンチオファーでは、早期採用者に対して大幅な割引を提供します。evalshipは、ソースコードやAPIキーを保存せず、差分と評価結果のみを処理することでセキュリティを確保します。

  • カテゴリーAI コードレビュー・テスト
  • 料金モデルフリーミアム
  • デプロイクラウド
  • プラットフォームWeb

  • セットアップ中にLLM評価の欠陥を特定

  • 評価の失敗の詳細な内訳を含むすべてのプルリクエストにコメント

  • パフォーマンスデータに基づいてプロンプトとモデルを自動最適化

  • 既存の評価フレームワーク(JUnit XML、promptfoo、evalship JSON)で動作

  • LLM評価のための24以上の品質チェックを提供

  • 歴史的データを使用して回帰と不安定な評価を区別

  • プルリクエスト内の未テストのAI呼び出しを検出

  • 評価ルールを破るマージをブロック(設定可能)

  • 問題が修正されるとプルリクエストのブロックを解除

  • パフォーマンスと問題を要約した週次評価レポートをメール送信

  • モノレポと複数の評価ワークフローをサポート

  • Langfuse、Braintrust、LangSmithと統合し、切り替えを必要としない

  • セットアップ時に評価の無料レビューを提供

  • コーディングエージェントがプルリクエストを開く前に変更を確認可能

  • ソースコードやAPIキーを保存せずにセキュリティを確保

  1. セットアップ: GitHubリポジトリを接続し、コーディングエージェントにevalshipをセットアップさせ、評価をレビューし、セットアッププルリクエストを作成させます。

  2. プルリクエストを監視: evalshipはすべてのプルリクエストを自動的に監視し、評価を壊す変更や未テストのAI呼び出しにコメントします。

  3. レポートをレビュー: 各評価の入力、出力、履歴に関する詳細なレポートにアクセスし、何が壊れたのか、なぜ壊れたのかを理解します。

  4. 最適化: evalshipの最適化機能を使用して、コーディングエージェントと共にプロンプトとモデルの変更をテストし、偶然を超えた改善を特定します。

  5. レポートを受け取る: マージ前に発見された重要な問題を強調した評価パフォーマンスを要約した週次メールレポートを受け取ります。

  • LLM評価の品質管理
  • 自動プルリクエストレビュー
  • プロンプトとモデルの最適化
  • 回帰防止
  • 未テストのAI呼び出し検出
  • 不安定な評価管理
  • コンプライアンスと責任リスクの軽減
  • 開発者ワークフローの強化

evalship のレビュー

読み込み中...

evalship に似た人気のAIツール

LangWatch

AI アプリ

LangWatchは、AIエージェントのテスト、LLM評価、オブザーバビリティプラットフォームです。開発者は、本番環境のトレースを評価に変換することで、現実世界のシナリオをシミュレートし、リグレッションを防ぎ、問題をデバッグできます。デプロイ前にプロンプト、モデル、エージェントをテストして、リリースごとにAIの品質を向上させます。

MLOps・モデルデプロイ

プロンプトエンジニアリングツールで第14位

ツールを見る

AI アプリ

AIエージェントのテスト、LLM評価、オブザーバビリティプラットフォームです。開発者は、本番環境のトレースを評価に変換することで、現実世界のシナリオをシミュレートし、リグレッションを防ぎ、問題をデバッグできます。デプロイ前にプロンプト、モデル、エージェントをテストして、リリースごとにAIの品質を向上させます。LangWatchは、AIエージェントのテスト、LLM評価、オブザーバビリティプラットフォームです。開発者は、本番環境のトレースを評価に変換することで、現実世界のシナリオをシミュレートし、リグレッションを防ぎ、問題をデバッグできます。デプロイ前にプロンプト、モデル、エージェントをテストして、リリースごとにAIの品質を向上させます。

注目MLOps・モデルデプロイ
プロンプトエンジニアリングツールで第14位

EvalCore

AI アプリ

EvalCoreはAIの動作に対するスナップショットテストを提供し、LLMアプリの動作を記録し、変更ごとにCIで再生することを可能にします。これにより、変更がパフォーマンスに悪影響を及ぼさないことが保証され、オフラインで無料で利用できます。

AI コードレビュー・テスト
ツールを見る

AI アプリ

AIの動作に対するスナップショットテストを提供し、LLMアプリの動作を記録し、変更ごとにCIで再生することを可能にします。これにより、変更がパフォーマンスに悪影響を及ぼさないことが保証され、オフラインで無料で利用できます。EvalCoreはAIの動作に対するスナップショットテストを提供し、LLMアプリの動作を記録し、変更ごとにCIで再生することを可能にします。これにより、変更がパフォーマンスに悪影響を及ぼさないことが保証され、オフラインで無料で利用できます。

AI コードレビュー・テスト
AI アプリ トップ250を見る

Confident AI

AI アプリ

Confident AIは、AIシステムをベンチマークし、プロンプトとモデルを比較し、研究に基づいたメトリクスを使用して回帰を特定する包括的なLLM評価プラットフォームを提供します。マルチターン会話テストをサポートし、ユーザーがエンジニアリングのボトルネックなしで実験できるようにします。

機械学習プラットフォーム

AIモデルの監視で第47位

ツールを見る

AI アプリ

AIシステムをベンチマークし、プロンプトとモデルを比較し、研究に基づいたメトリクスを使用して回帰を特定する包括的なLLM評価プラットフォームを提供します。マルチターン会話テストをサポートし、ユーザーがエンジニアリングのボトルネックなしで実験できるようにします。Confident AIは、AIシステムをベンチマークし、プロンプトとモデルを比較し、研究に基づいたメトリクスを使用して回帰を特定する包括的なLLM評価プラットフォームを提供します。マルチターン会話テストをサポートし、ユーザーがエンジニアリングのボトルネックなしで実験できるようにします。

機械学習プラットフォーム
AIモデルの監視で第47位

Evidently AIは、AIアプリケーションの評価と監視のためのオープンソースツールを提供します。LLMをテストし、さまざまなワークフローにおけるパフォーマンスを監視することで、AIシステムが本番環境に適していることを確保します。世界中のAIチームに信頼されています。

MLOps・モデルデプロイ

MLOps・モデルデプロイで第20位

ツールを見る

AIアプリケーションの評価と監視のためのオープンソースツールを提供します。LLMをテストし、さまざまなワークフローにおけるパフォーマンスを監視することで、AIシステムが本番環境に適していることを確保します。世界中のAIチームに信頼されています。Evidently AIは、AIアプリケーションの評価と監視のためのオープンソースツールを提供します。LLMをテストし、さまざまなワークフローにおけるパフォーマンスを監視することで、AIシステムが本番環境に適していることを確保します。世界中のAIチームに信頼されています。

MLOps・モデルデプロイ
MLOps・モデルデプロイで第20位

mabl

AI アプリ

mablは、チームがリリースを加速し、ソフトウェアの品質を確保するための自動化されたソフトウェアテストプラットフォームです。機械学習と自己修復テストを活用して、アプリケーションの信頼性のある検証を提供し、ウェブ、モバイル、API全体でユーザー体験を向上させます。

AI コードレビュー・テスト

AI コードレビュー・テストで第32位

ツールを見る

AI アプリ

チームがリリースを加速し、ソフトウェアの品質を確保するための自動化されたソフトウェアテストプラットフォームです。機械学習と自己修復テストを活用して、アプリケーションの信頼性のある検証を提供し、ウェブ、モバイル、API全体でユーザー体験を向上させます。mablは、チームがリリースを加速し、ソフトウェアの品質を確保するための自動化されたソフトウェアテストプラットフォームです。機械学習と自己修復テストを活用して、アプリケーションの信頼性のある検証を提供し、ウェブ、モバイル、API全体でユーザー体験を向上させます。

AI コードレビュー・テスト
AI コードレビュー・テストで第32位

Giskard OSS

AI GitHub リポジトリ

Giskard OSSは、LLMエージェントのために設計されたオープンソースの評価およびテストライブラリです。言語モデルの性能を評価し改善するためのツールを提供し、堅牢で信頼性の高いAIアプリケーションを確保します。

AI コードレビュー・テスト

AI GitHub リポジトリで第111位

ツールを見る

AI GitHub リポジトリ

LLMエージェントのために設計されたオープンソースの評価およびテストライブラリです。言語モデルの性能を評価し改善するためのツールを提供し、堅牢で信頼性の高いAIアプリケーションを確保します。Giskard OSSは、LLMエージェントのために設計されたオープンソースの評価およびテストライブラリです。言語モデルの性能を評価し改善するためのツールを提供し、堅牢で信頼性の高いAIアプリケーションを確保します。

AI コードレビュー・テスト
AI GitHub リポジトリで第111位

Future AGI

AI アプリ

Future AGIは、AIエージェントの構築、テスト、監視のためのオープンソースプラットフォームです。ガードレール、20以上のメトリクスを使用した包括的な評価、Sentryスタイルのエラー追跡により、AIの幻覚をリアルタイムで検出し修正するのに役立ちます。このプラットフォームは、強化学習による継続的な改善を可能にし、エンドツーエンドのリクエストトレーシング…

MLOps・モデルデプロイ

MLOps・モデルデプロイで第38位

ツールを見る

AI アプリ

AIエージェントの構築、テスト、監視のためのオープンソースプラットフォームです。ガードレール、20以上のメトリクスを使用した包括的な評価、Sentryスタイルのエラー追跡により、AIの幻覚をリアルタイムで検出し修正するのに役立ちます。このプラットフォームは、強化学習による継続的な改善を可能にし、エンドツーエンドのリクエストトレーシング…Future AGIは、AIエージェントの構築、テスト、監視のためのオープンソースプラットフォームです。ガードレール、20以上のメトリクスを使用した包括的な評価、Sentryスタイルのエラー追跡により、AIの幻覚をリアルタイムで検出し修正するのに役立ちます。このプラットフォームは、強化学習による継続的な改善を可能にし、エンドツーエンドのリクエストトレーシング…

注目MLOps・モデルデプロイ
MLOps・モデルデプロイで第38位

DeepEval

AI GitHub リポジトリ

DeepEvalは、大規模言語モデル(LLM)を評価するために設計されたオープンソースのフレームワークです。開発者が評価プロセスに貢献し、LLMのパフォーマンスと信頼性を向上させることができます。

MLOps・モデルデプロイ

AI GitHub リポジトリで第91位

ツールを見る

AI GitHub リポジトリ

大規模言語モデル(LLM)を評価するために設計されたオープンソースのフレームワークです。開発者が評価プロセスに貢献し、LLMのパフォーマンスと信頼性を向上させることができます。DeepEvalは、大規模言語モデル(LLM)を評価するために設計されたオープンソースのフレームワークです。開発者が評価プロセスに貢献し、LLMのパフォーマンスと信頼性を向上させることができます。

MLOps・モデルデプロイ
AI GitHub リポジトリで第91位
1 / 8