Langsung ke konten utama
ToolPotion
Penasihat AI
Kirim (Gratis)

ERNIE-5.5-Flash-Base-BF16

ERNIE-5.5-Flash-Base-BF16 adalah model bahasa Mixture-of-Experts (MoE) yang efisien dan jarang dengan total 280 miliar parameter. Dilatih sebelumnya pada 33,5 triliun token, model ini mendukung fine-tuning dan inferensi dengan konteks 1 juta token. Model ini dirancang untuk berbagai aplikasi, termasuk adaptasi domain, tuning instruksi, dan penelitian pembelajaran penguatan, menawarkan kinerja yang kuat di berbagai tolok ukur.

Kunjungi URL
Bagikan
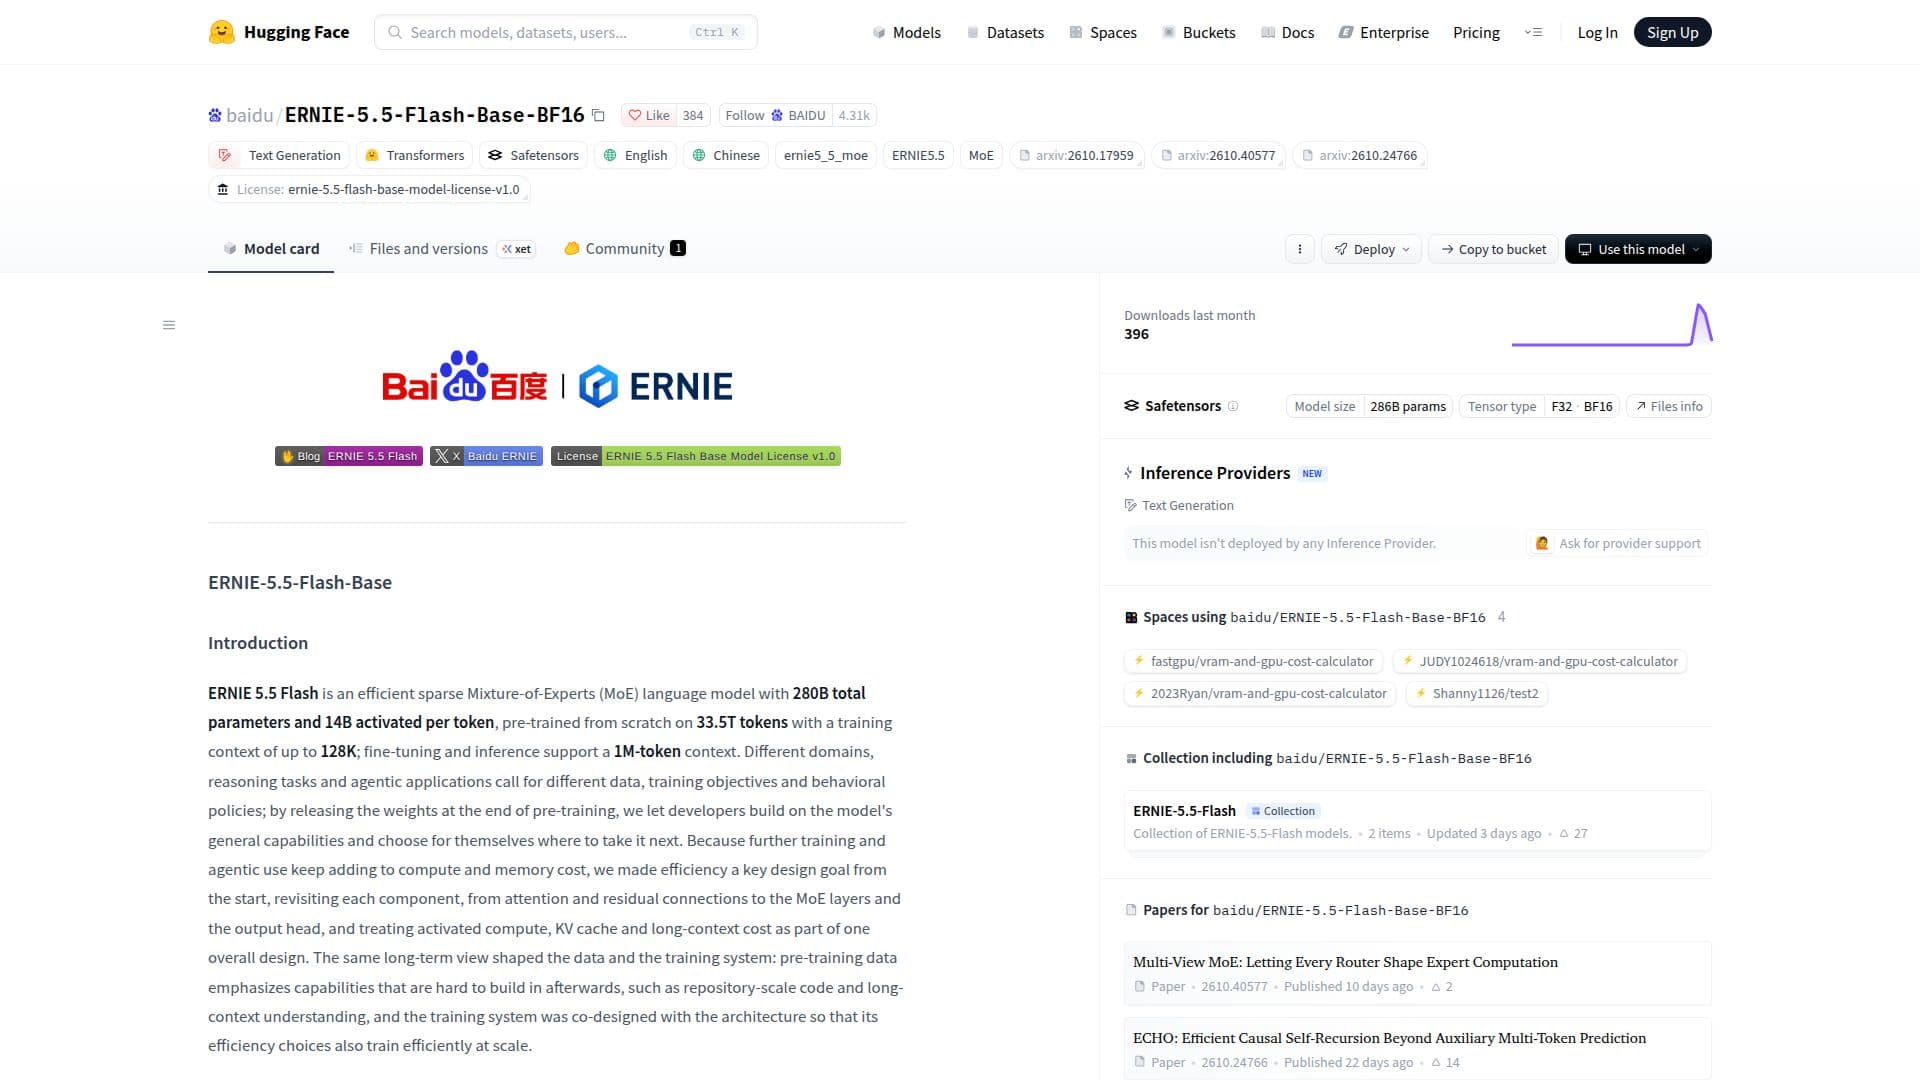
Tangkapan layar ERNIE-5.5-Flash-Base-BF16

ERNIE-5.5-Flash-Base-BF16 adalah model bahasa Mixture-of-Experts (MoE) yang canggih dan jarang yang dikembangkan oleh Baidu. Model ini memiliki total 280 miliar parameter, dengan 14 miliar parameter yang diaktifkan per token, menjadikannya sangat efisien untuk tugas bahasa yang kompleks. Model ini dilatih sebelumnya dari awal pada dataset yang luas dengan 33,5 triliun token, menggunakan konteks pelatihan hingga 128.000 token. Untuk fine-tuning dan inferensi, model ini mendukung panjang konteks yang mengesankan hingga 1 juta token, memungkinkan pemahaman mendalam dan generasi konten panjang.

Baca Selengkapnya

Dirancang dengan efisiensi sebagai prinsip inti, ERNIE 5.5 Flash meninjau setiap komponen, mulai dari mekanisme perhatian dan koneksi residual hingga lapisan MoE dan kepala output. Pendekatan holistik ini memastikan kinerja optimal sambil mengelola biaya komputasi, cache KV, dan konteks panjang. Data pelatihan menekankan kemampuan yang penting untuk aplikasi lanjutan, seperti pemahaman kode skala repositori dan pemahaman konteks panjang, memungkinkan pengembang untuk membangun di atas kemampuan umumnya untuk berbagai kasus penggunaan.

ERNIE-5.5-Flash-Base-BF16 mewakili titik pemeriksaan di akhir pelatihan awal, berfungsi sebagai model dasar sebelum tahap pelatihan menengah atau pasca pelatihan. Ini menjadikannya titik awal yang ideal bagi peneliti dan pengembang yang terlibat dalam adaptasi domain, tuning instruksi, dan pembelajaran penguatan. Model ini telah menunjukkan hasil yang kuat di seluruh jalur evaluasi terpadu, unggul dalam tolok ukur yang terkait dengan pengetahuan, penalaran, matematika, kode, tugas multibahasa, dan pemahaman konteks panjang.

Arsitektur ini menggabungkan MoE perhatian hibrida 280B-A14B dengan 43 lapisan, termasuk 1 FFN padat dan 42 lapisan MoE Latent Multi-Router. Ini memiliki 37 lapisan Heavily Compressed Attention (HCA) dan 6 lapisan Multi-head Latent Attention (MLA + DSA) dengan perhatian jarang. Model ini memanfaatkan 512 ahli yang diarahkan (top-10) ditambah 1 ahli bersama per lapisan MoE. Inovasi seperti Low-Rank Gated Attention, Virtual Head Attention (VHA), Multi-Router Latent MoE, ECHO, Manifold-constrained Hyper-Connections (mHC), dan MultiMax Output Head berkontribusi pada kemampuan dan efisiensinya yang canggih. Tokenizer mendukung sekitar 200.000 entri dan mengubah angka dari kanan ke kiri dalam kelompok hingga tiga digit.

Penerapan didukung dengan SGLang dan vLLM, memungkinkan penyajian produksi dengan panjang konteks hingga 1.048.576 token. Model ini tersedia di bawah Perjanjian Lisensi Model Dasar ERNIE 5.5 Flash v1.0.

  • KategoriModel AI & LLM
  • PenerapanCloud
  • PlatformWeb

  • 280 miliar total parameter

  • 14 miliar parameter yang diaktifkan per token

  • Dilatih sebelumnya pada 33,5 triliun token

  • Konteks pelatihan hingga 128.000 token

  • Dukungan fine-tuning dan inferensi untuk konteks 1 juta token

  • Arsitektur Mixture-of-Experts (MoE) yang efisien dan jarang

  • MoE perhatian hibrida dengan 43 lapisan

  • 37 lapisan Heavily Compressed Attention (HCA)

  • 6 lapisan Multi-head Latent Attention (MLA + DSA)

  • 512 ahli yang diarahkan (top-10) ditambah 1 ahli bersama per lapisan MoE

  • Low-Rank Gated Attention dan Virtual Head Attention (VHA)

  • Multi-Router Latent MoE untuk pemilihan ahli yang akurat

  • ECHO untuk kehilangan multi-horizon dan decoding spekulatif

  • Manifold-constrained Hyper-Connections (mHC) untuk propagasi sinyal

  • MultiMax Output Head untuk distribusi kosakata yang lebih tajam

  • Tokenizer BPE dengan sekitar 200.000 entri

  • Dukungan untuk SGLang dan vLLM untuk penyajian produksi

  1. Akses Halaman Model: Arahkan ke halaman ERNIE-5.5-Flash-Base-BF16 di Hugging Face.

  2. Jelajahi Berkas: Tinjau berkas model dan dokumentasi yang tersedia di halaman.

  3. Unduh Model: Unduh titik pemeriksaan model ERNIE-5.5-Flash-Base-BF16.

  4. Instal vLLM dan Plugin: Instal vLLM dan plugin ERNIE 5.5 untuk penerapan.

  5. Luncurkan Server: Gunakan SGLang atau vLLM untuk meluncurkan server model.

  6. Kirim Permintaan: Kirim permintaan ke endpoint penyelesaian menggunakan alat seperti curl untuk inferensi.

  • Generasi Teks
  • Adaptasi Domain
  • Tuning Instruksi
  • Penelitian Pembelajaran Penguatan
  • Pemahaman Kode
  • Pemahaman Konteks Panjang
  • Aplikasi Multibahasa
  • Tugas Penalaran
  • Aplikasi Agensif

Dari Baidu

Model dalam Baidu Wenxin Assistant.

Ulasan ERNIE-5.5-Flash-Base-BF16

Memuat...

Alat AI Populer Seperti ERNIE-5.5-Flash-Base-BF16

ERNIE-5.5-Flash-Base adalah model bahasa Mixture-of-Experts (MoE) yang efisien dan jarang dengan total 280B parameter, dirancang untuk generasi teks. Pra-latih pada 33.5T token,…

Model AI & LLM
Lihat Alat

Model bahasa Mixture-of-Experts (MoE) yang efisien dan jarang dengan total 280B parameter, dirancang untuk generasi teks. Pra-latih pada 33.5T token,…ERNIE-5.5-Flash-Base adalah model bahasa Mixture-of-Experts (MoE) yang efisien dan jarang dengan total 280B parameter, dirancang untuk generasi teks. Pra-latih pada 33.5T token,…

Model AI & LLM
Lihat Top 100 LLM

DeepSeek-V4-Pro adalah model AI canggih yang dirancang untuk kecerdasan konteks dengan jutaan token secara efisien. Model ini memiliki arsitektur perhatian hibrida dan telah…

Model AI & LLM
Lihat Alat

Model AI canggih yang dirancang untuk kecerdasan konteks dengan jutaan token secara efisien. Model ini memiliki arsitektur perhatian hibrida dan telah…DeepSeek-V4-Pro adalah model AI canggih yang dirancang untuk kecerdasan konteks dengan jutaan token secara efisien. Model ini memiliki arsitektur perhatian hibrida dan telah…

UnggulanModel AI & LLM
Lihat Top 100 LLM

DeepSeek-V3 adalah model bahasa Mixture-of-Experts dengan 671 miliar parameter, dirancang untuk inferensi yang efisien dan pelatihan yang hemat biaya. Model ini unggul dalam…

Model AI & LLM

Peringkat 42 di LLM

Lihat Alat

Model bahasa Mixture-of-Experts dengan 671 miliar parameter, dirancang untuk inferensi yang efisien dan pelatihan yang hemat biaya. Model ini unggul dalam…DeepSeek-V3 adalah model bahasa Mixture-of-Experts dengan 671 miliar parameter, dirancang untuk inferensi yang efisien dan pelatihan yang hemat biaya. Model ini unggul dalam…

UnggulanModel AI & LLM
Peringkat 42 di LLM

DeepSeek-V4-Pro-DSpark adalah model bahasa canggih yang menampilkan arsitektur perhatian hibrida dan hiper-koneksi terbatasi manifold. Model ini mendukung panjang konteks satu…

Model AI & LLM

Peringkat 71 di LLM

Lihat Alat

Model bahasa canggih yang menampilkan arsitektur perhatian hibrida dan hiper-koneksi terbatasi manifold. Model ini mendukung panjang konteks satu…DeepSeek-V4-Pro-DSpark adalah model bahasa canggih yang menampilkan arsitektur perhatian hibrida dan hiper-koneksi terbatasi manifold. Model ini mendukung panjang konteks satu…

Model AI & LLM
Peringkat 71 di LLM

AliceAI-Foundation-80B-A3B-Base adalah model bahasa dasar dengan arsitektur hibrida dan lapisan MoE, yang memiliki 80 miliar parameter. Model ini unggul dalam tugas pengetahuan…

Model AI & LLM

Peringkat 29 di LLM

Lihat Alat

Model bahasa dasar dengan arsitektur hibrida dan lapisan MoE, yang memiliki 80 miliar parameter. Model ini unggul dalam tugas pengetahuan…AliceAI-Foundation-80B-A3B-Base adalah model bahasa dasar dengan arsitektur hibrida dan lapisan MoE, yang memiliki 80 miliar parameter. Model ini unggul dalam tugas pengetahuan…

Model AI & LLM
Peringkat 29 di LLM

Ling-3.0-flash adalah model penalaran hibrida generasi berikutnya yang dirancang untuk efisiensi dan kinerja. Dengan 124 miliar parameter, model ini unggul dalam penalaran,…

Model AI & LLM

Peringkat 65 di LLM

Lihat Alat

Model penalaran hibrida generasi berikutnya yang dirancang untuk efisiensi dan kinerja. Dengan 124 miliar parameter, model ini unggul dalam penalaran,…Ling-3.0-flash adalah model penalaran hibrida generasi berikutnya yang dirancang untuk efisiensi dan kinerja. Dengan 124 miliar parameter, model ini unggul dalam penalaran,…

Model AI & LLM
Peringkat 65 di LLM

DeepSeek-V3

Repositori GitHub AI

DeepSeek-V3 adalah model bahasa Mixture-of-Experts dengan bobot terbuka dari DeepSeek, dengan total 671 miliar parameter dan 37 miliar yang diaktifkan per token. Dilatih…

Model AI & LLM
Lihat Alat

Repositori GitHub AI

Model bahasa Mixture-of-Experts dengan bobot terbuka dari DeepSeek, dengan total 671 miliar parameter dan 37 miliar yang diaktifkan per token. Dilatih…DeepSeek-V3 adalah model bahasa Mixture-of-Experts dengan bobot terbuka dari DeepSeek, dengan total 671 miliar parameter dan 37 miliar yang diaktifkan per token. Dilatih…

Model AI & LLM
Lihat Top 250 Repositori GitHub AI

Kimi-K2-Instruct adalah model bahasa campuran ahli yang canggih, dirancang untuk tugas AI tingkat lanjut. Model ini unggul dalam penalaran, pengkodean, dan penggunaan alat,…

Model AI & LLM

Peringkat 51 di LLM

Lihat Alat

Kimi-K2-Instruct adalah model bahasa campuran ahli yang canggih, dirancang untuk tugas AI tingkat lanjut. Model ini unggul dalam penalaran, pengkodean, dan penggunaan alat,…

Model AI & LLM
Peringkat 51 di LLM
1 dari 8