Langsung ke konten utama
ToolPotion
Penasihat AI
Kirim (Gratis)

ERNIE-5.5-Flash-Base

LLMModel AI & LLMOpen source · Web

ERNIE-5.5-Flash-Base adalah model bahasa Mixture-of-Experts (MoE) yang efisien dan jarang dengan total 280B parameter, dirancang untuk generasi teks. Pra-latih pada 33.5T token, mendukung fine-tuning dan inferensi dengan konteks 1M token. Model ini berfungsi sebagai titik awal yang kuat untuk adaptasi domain, tuning instruksi, dan penelitian pembelajaran penguatan, menawarkan kinerja yang kuat di berbagai tolok ukur.

Kunjungi URL
Bagikan
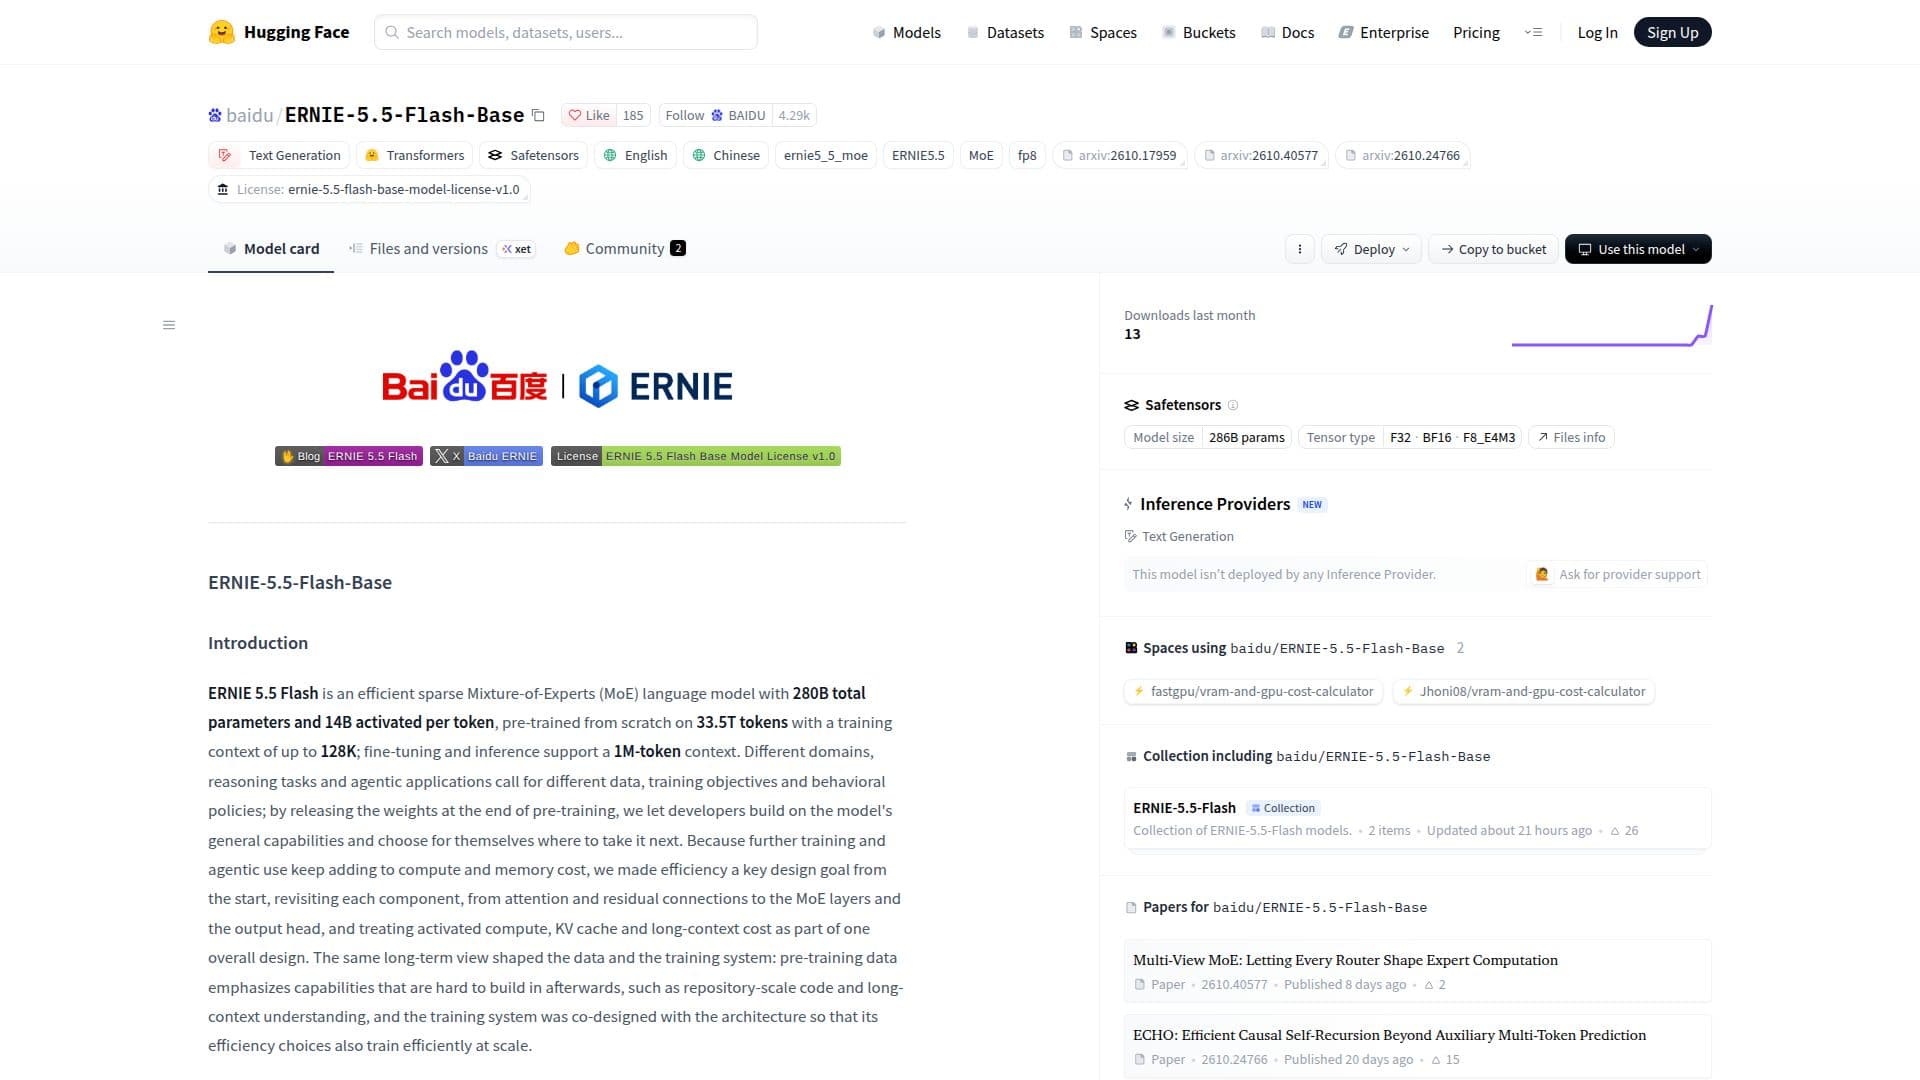
Tangkapan layar ERNIE-5.5-Flash-Base

ERNIE-5.5-Flash-Base adalah model generasi teks yang canggih yang dikembangkan oleh Baidu, tersedia di Hugging Face. Ini adalah model bahasa Mixture-of-Experts (MoE) yang efisien dan jarang, dengan total 280 miliar parameter dan 14 miliar yang diaktifkan per token. Model ini dilatih dari awal pada dataset luas yang terdiri dari 33.5 triliun token, memanfaatkan konteks pelatihan hingga 128K. Untuk fine-tuning dan inferensi, mendukung panjang konteks yang mengesankan hingga 1M token.

Baca Selengkapnya

Dirancang dengan efisiensi sebagai tujuan inti, ERNIE 5.5 Flash meninjau kembali setiap komponen, dari mekanisme perhatian dan koneksi residual hingga lapisan MoE dan kepala output. Pendekatan holistik ini mempertimbangkan komputasi yang diaktifkan, cache KV, dan biaya konteks panjang sebagai bagian dari desain terintegrasi. Data pra-pelatihan menekankan kemampuan yang sulit dibangun setelah pelatihan, seperti pemahaman kode skala repositori dan pemahaman konteks panjang. Sistem pelatihan dirancang bersama dengan arsitektur untuk memastikan skala yang efisien.

ERNIE-5.5-Flash-Base mewakili titik pemeriksaan di akhir pra-pelatihan, menjadikannya fondasi yang ideal bagi pengembang. Ini memungkinkan adaptasi domain, tuning instruksi, dan penelitian pembelajaran penguatan. Model ini menunjukkan hasil yang kuat di seluruh jalur evaluasi terpadu, mencakup pengetahuan, penalaran, matematika, kode, tugas multibahasa, dan tolok ukur konteks panjang. Kinerjanya dibandingkan dengan model besar lainnya seperti DeepSeek-V4-Flash-Base, Hy3-preview-Base, dan MiMo-V2.5-Base, semuanya dievaluasi di bawah kondisi yang konsisten.

Arsitektur ini menggabungkan MoE perhatian hibrida 280B-A14B dengan 43 lapisan, termasuk 1 FFN padat dan 42 lapisan MoE Latent Multi-Router. Ini memiliki 37 lapisan Heavily Compressed Attention (HCA) dan 6 lapisan Multi-head Latent Attention dengan perhatian jarang (MLA + DSA). Model ini memanfaatkan 512 ahli yang diarahkan (top-10) ditambah 1 ahli bersama per lapisan MoE. Inovasi kunci termasuk perhatian Hybrid MLA + HCA dengan dimensi kepala spesifik lapisan, Low-Rank Gated Attention, Virtual Head Attention (VHA), Multi-Router Latent MoE, ECHO untuk prediksi token masa depan, Manifold-constrained Hyper-Connections (mHC), dan MultiMax Output Head. Tokenizer menggunakan tokenizer BPE ≈200K-entri yang meng-tokenisasi angka dari kanan ke kiri dalam kelompok hingga tiga digit.

Penerapan ERNIE-5.5-Flash-Base didukung dengan SGLang dan vLLM, memungkinkan penyajian produksi dengan panjang konteks hingga 1.048.576 token untuk inferensi konteks panjang. Model ini disediakan di bawah Perjanjian Lisensi Model ERNIE 5.5 Flash Base v1.0, dengan hak cipta dipegang oleh Baidu.

  • KategoriModel AI & LLM
  • Model HargaOpen source
  • PenerapanCloud
  • PlatformWeb

  • 280B total parameter dengan 14B diaktifkan per token

  • Pra-latih pada 33.5T token

  • Mendukung konteks 1M-token untuk fine-tuning dan inferensi

  • Arsitektur Mixture-of-Experts (MoE) yang efisien dan jarang

  • Perhatian Hybrid MLA + HCA dengan dimensi kepala spesifik lapisan

  • Low-Rank Gated Attention dan Virtual Head Attention (VHA)

  • Multi-Router Latent MoE dengan 512 ahli yang diarahkan dan 1 ahli bersama

  • ECHO untuk kehilangan multi-horizon dan decoding spekulatif

  • Manifold-constrained Hyper-Connections (mHC) untuk propagasi sinyal

  • MultiMax Output Head untuk distribusi kosakata yang lebih tajam

  • ≈200K-entri tokenizer BPE dengan tokenisasi angka dari kanan ke kiri

  • Mendukung penerapan dengan SGLang dan vLLM

  • Kinerja yang kuat di seluruh pengetahuan, penalaran, matematika, kode, multibahasa, dan tolok ukur konteks panjang

  • Bobot presisi FP8 dan BF16 tersedia

  1. Akses Model: Arahkan ke halaman ERNIE-5.5-Flash-Base di Hugging Face.

  2. Unduh Model: Pilih antara presisi FP8 (safetensors) atau BF16 (safetensors) untuk diunduh.

  3. Instal Alat Penerapan: Instal vLLM dan plugin ERNIE 5.5, atau gunakan gambar Docker prebuilt resmi SGLang.

  4. Luncurkan Server: Mulai server vLLM atau SGLang untuk meng-host model.

  5. Kirim Permintaan: Gunakan curl atau klien API lainnya untuk mengirim permintaan ke endpoint penyelesaian untuk generasi teks.

  6. Fine-tune Model: Manfaatkan titik pemeriksaan pra-latih untuk adaptasi domain, tuning instruksi, atau penelitian pembelajaran penguatan.

  • Generasi Teks
  • Adaptasi Domain
  • Tuning Instruksi
  • Penelitian Pembelajaran Penguatan
  • Generasi dan Pemahaman Kode
  • Pemahaman Konteks Panjang
  • Aplikasi Multibahasa
  • Tugas Penalaran

Dari Baidu

Model dalam Baidu Wenxin Assistant.

Ulasan ERNIE-5.5-Flash-Base

Memuat...

Alat AI Populer Seperti ERNIE-5.5-Flash-Base

DeepSeek-V4-Pro adalah model AI canggih yang dirancang untuk kecerdasan konteks dengan jutaan token secara efisien. Model ini memiliki arsitektur perhatian hibrida dan telah…

Model AI & LLM
Lihat Alat

Model AI canggih yang dirancang untuk kecerdasan konteks dengan jutaan token secara efisien. Model ini memiliki arsitektur perhatian hibrida dan telah…DeepSeek-V4-Pro adalah model AI canggih yang dirancang untuk kecerdasan konteks dengan jutaan token secara efisien. Model ini memiliki arsitektur perhatian hibrida dan telah…

UnggulanModel AI & LLM
Lihat Top 50 LLM

DeepSeek-V3 adalah model bahasa Mixture-of-Experts dengan 671 miliar parameter, dirancang untuk inferensi yang efisien dan pelatihan yang hemat biaya. Model ini unggul dalam…

Model AI & LLM

Peringkat 37 di LLM

Lihat Alat

Model bahasa Mixture-of-Experts dengan 671 miliar parameter, dirancang untuk inferensi yang efisien dan pelatihan yang hemat biaya. Model ini unggul dalam…DeepSeek-V3 adalah model bahasa Mixture-of-Experts dengan 671 miliar parameter, dirancang untuk inferensi yang efisien dan pelatihan yang hemat biaya. Model ini unggul dalam…

UnggulanModel AI & LLM
Peringkat 37 di LLM

AliceAI-Foundation-80B-A3B-Base adalah model bahasa dasar dengan arsitektur hibrida dan lapisan MoE, yang memiliki 80 miliar parameter. Model ini unggul dalam tugas pengetahuan…

Model AI & LLM

Peringkat 28 di LLM

Lihat Alat

Model bahasa dasar dengan arsitektur hibrida dan lapisan MoE, yang memiliki 80 miliar parameter. Model ini unggul dalam tugas pengetahuan…AliceAI-Foundation-80B-A3B-Base adalah model bahasa dasar dengan arsitektur hibrida dan lapisan MoE, yang memiliki 80 miliar parameter. Model ini unggul dalam tugas pengetahuan…

Model AI & LLM
Peringkat 28 di LLM

Ling-3.0-flash adalah model penalaran hibrida generasi berikutnya yang dirancang untuk efisiensi dan kinerja. Dengan 124 miliar parameter, model ini unggul dalam penalaran,…

Model AI & LLM
Lihat Alat

Model penalaran hibrida generasi berikutnya yang dirancang untuk efisiensi dan kinerja. Dengan 124 miliar parameter, model ini unggul dalam penalaran,…Ling-3.0-flash adalah model penalaran hibrida generasi berikutnya yang dirancang untuk efisiensi dan kinerja. Dengan 124 miliar parameter, model ini unggul dalam penalaran,…

Model AI & LLM
Lihat Top 50 LLM

Kimi-K2-Instruct adalah model bahasa campuran ahli yang canggih, dirancang untuk tugas AI tingkat lanjut. Model ini unggul dalam penalaran, pengkodean, dan penggunaan alat,…

Model AI & LLM

Peringkat 46 di LLM

Lihat Alat

Kimi-K2-Instruct adalah model bahasa campuran ahli yang canggih, dirancang untuk tugas AI tingkat lanjut. Model ini unggul dalam penalaran, pengkodean, dan penggunaan alat,…

Model AI & LLM
Peringkat 46 di LLM

MiniMax-M3.1-Flash adalah model campuran multimodal yang dirancang untuk pengkodean, alur kerja agen, dan keamanan siber. Model ini mendukung input teks, gambar, dan video,…

Model AI & LLM
Lihat Alat

Model campuran multimodal yang dirancang untuk pengkodean, alur kerja agen, dan keamanan siber. Model ini mendukung input teks, gambar, dan video,…MiniMax-M3.1-Flash adalah model campuran multimodal yang dirancang untuk pengkodean, alur kerja agen, dan keamanan siber. Model ini mendukung input teks, gambar, dan video,…

Model AI & LLM
Lihat Top 50 LLM

DeepSeek-V4-Pro-DSpark adalah model bahasa canggih yang menampilkan arsitektur perhatian hibrida dan hiper-koneksi terbatasi manifold. Model ini mendukung panjang konteks satu…

Model AI & LLM
Lihat Alat

Model bahasa canggih yang menampilkan arsitektur perhatian hibrida dan hiper-koneksi terbatasi manifold. Model ini mendukung panjang konteks satu…DeepSeek-V4-Pro-DSpark adalah model bahasa canggih yang menampilkan arsitektur perhatian hibrida dan hiper-koneksi terbatasi manifold. Model ini mendukung panjang konteks satu…

Model AI & LLM
Lihat Top 50 LLM

Solar Open 2 adalah model bahasa besar dari Upstage, dirancang untuk kasus penggunaan agentic seperti produktivitas kantor dan pengkodean. Ini memiliki arsitektur Hybrid-Attention…

Model AI & LLM

Peringkat 19 di LLM

Lihat Alat

Model bahasa besar dari Upstage, dirancang untuk kasus penggunaan agentic seperti produktivitas kantor dan pengkodean. Ini memiliki arsitektur Hybrid-Attention…Solar Open 2 adalah model bahasa besar dari Upstage, dirancang untuk kasus penggunaan agentic seperti produktivitas kantor dan pengkodean. Ini memiliki arsitektur Hybrid-Attention…

Model AI & LLM
Peringkat 19 di LLM
1 dari 8