Deskripsi
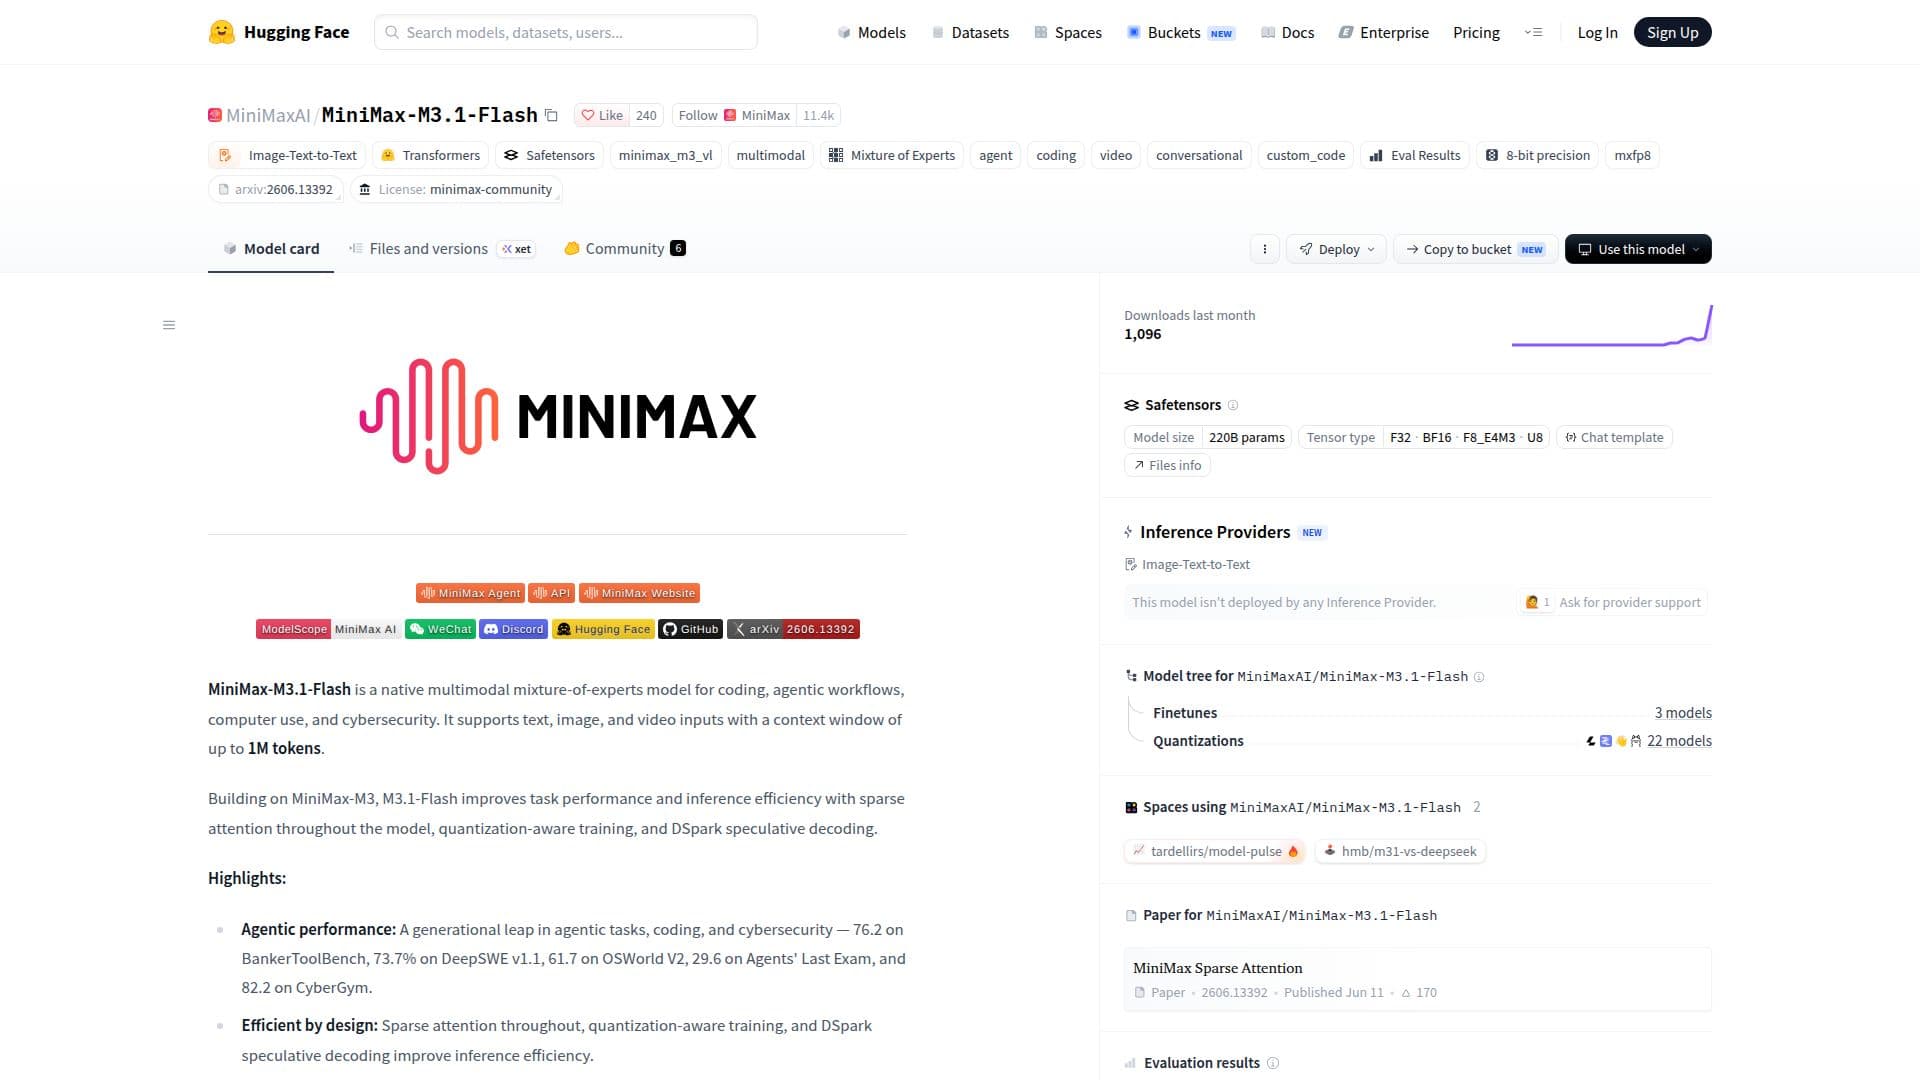
MiniMax-M3.1-Flash adalah model campuran multimodal yang canggih yang dikembangkan untuk meningkatkan pengkodean, alur kerja agen, penggunaan komputer, dan keamanan siber. Model ini mendukung input teks, gambar, dan video, menyediakan jendela konteks hingga 1 juta token. Berdasarkan arsitektur MiniMax-M3, M3.1-Flash memperkenalkan perbaikan dalam kinerja tugas dan efisiensi inferensi melalui penggunaan perhatian jarang di seluruh model, pelatihan yang sadar kuantisasi, dan pengkodean spekulatif DSpark.
Baca Selengkapnya
Arsitektur model ini dirancang untuk menangani berbagai jenis input dan output, dengan sekitar 428 miliar parameter, di mana 23 miliar diaktifkan per token. Ini memungkinkan pemrosesan yang efisien dan kinerja tinggi di berbagai tolok ukur, termasuk skor 76,2 di BankerToolBench dan 82,2 di CyberGym.
M3.1-Flash secara khusus dikenal karena kinerja ageniknya, menawarkan lompatan generasi dalam tugas terkait pengkodean dan keamanan siber. Model ini mencapai skor tinggi di beberapa tolok ukur, seperti 73,7% di DeepSWE v1.1 dan 61,7 di OSWorld V2. Efisiensi model ini semakin ditingkatkan oleh fitur-fitur seperti perhatian jarang dan pelatihan yang sadar kuantisasi, yang mengurangi jejak memori dan meningkatkan efisiensi penyajian.
Untuk penerapan, MiniMax-M3.1-Flash mendukung berbagai kerangka inferensi, termasuk SGLang, vLLM, dan TokenSpeed, dengan integrasi tambahan yang sedang berlangsung. Model ini dirancang untuk penerapan multi-chip, menawarkan fleksibilitas dalam konfigurasi penyajian. Pengguna dapat menyesuaikan pengaturan inferensi, seperti suhu dan top_p, untuk mengoptimalkan kinerja untuk tugas tertentu.
Secara keseluruhan, MiniMax-M3.1-Flash adalah alat yang kuat bagi pengembang dan peneliti yang ingin memanfaatkan kemampuan AI canggih dalam konteks multimodal, memberikan dukungan yang kuat untuk alur kerja kompleks dan aplikasi keamanan siber.
- KategoriModel AI & LLM
- Model HargaOpen source
- PenerapanCloud
- PlatformWeb
Sorotan MiniMax-M3.1-Flash
Arsitektur campuran multimodal
Mendukung input teks, gambar, dan video
Jendela konteks hingga 1 juta token
Perhatian jarang di seluruh model
Pelatihan yang sadar kuantisasi
Pengkodean spekulatif DSpark
Sekitar 428 miliar parameter
Kinerja tinggi di berbagai tolok ukur
Memulai dengan MiniMax-M3.1-Flash
Akses halaman model: Kunjungi halaman resmi Hugging Face untuk MiniMax-M3.1-Flash
Autentikasi: Pastikan Anda memiliki kredensial yang diperlukan untuk mengakses model
Konfigurasi: Siapkan model dengan kerangka inferensi pilihan Anda
Kirim prompt: Masukkan data teks, gambar, atau video untuk diproses
Fine-tune: Sesuaikan pengaturan seperti suhu dan top_p untuk hasil optimal
Kasus Penggunaan MiniMax-M3.1-Flash
- Bantuan Pengkodean
- Keamanan Siber
- Alur Kerja Agen
- Pemrosesan Multimodal
- Efisiensi Inferensi