Langsung ke konten utama
ToolPotion
Penasihat AI
Kirim (Gratis)

DeepSeek-V4-Pro-DSpark

LLMModel AI & LLMGratis · Web

DeepSeek-V4-Pro-DSpark adalah model bahasa canggih yang menampilkan arsitektur perhatian hibrida dan hiper-koneksi terbatasi manifold. Model ini mendukung panjang konteks satu juta token dan dioptimalkan untuk pemrosesan konteks panjang yang efisien.

Kunjungi URL
Bagikan
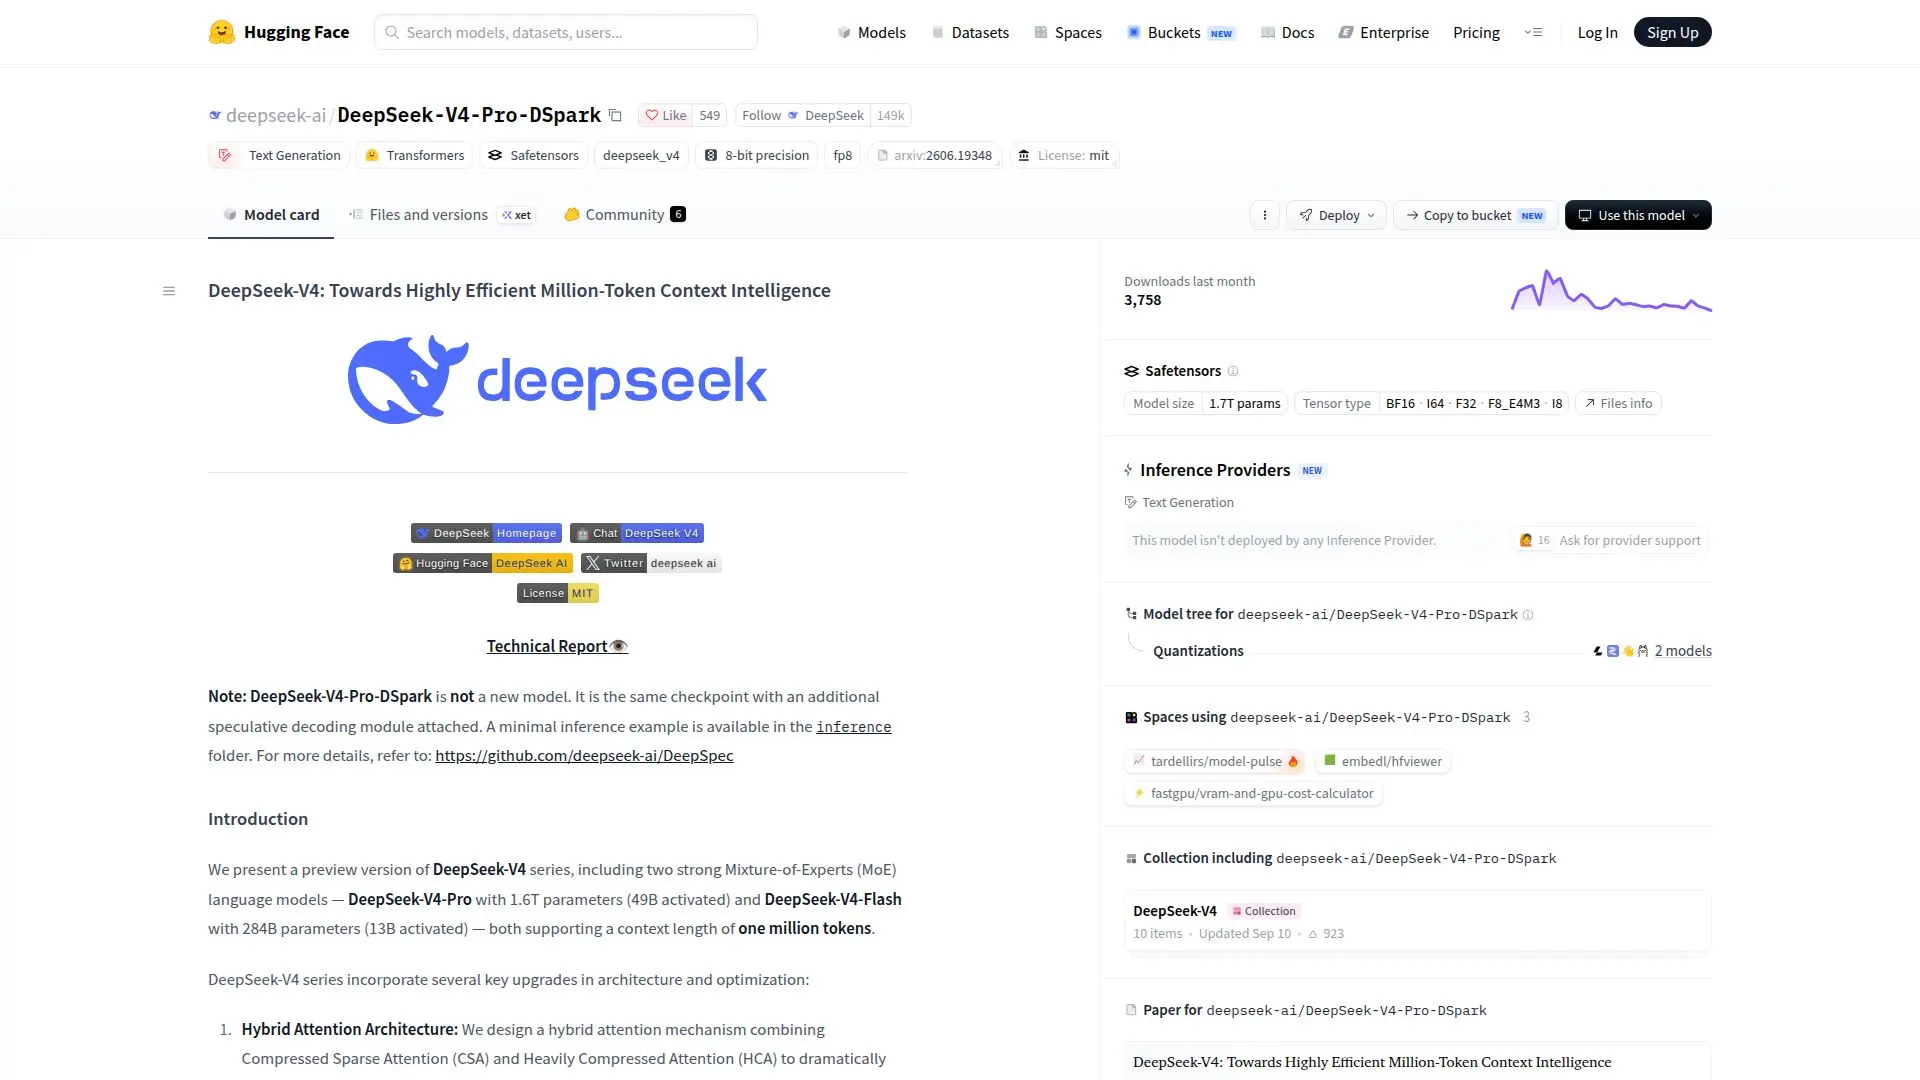
Tangkapan layar DeepSeek-V4-Pro-DSpark

DeepSeek-V4-Pro-DSpark adalah bagian dari seri DeepSeek-V4, yang mencakup model bahasa Mixture-of-Experts (MoE) yang sangat efisien. Model ini dirancang untuk menangani panjang konteks yang luas hingga satu juta token, menjadikannya cocok untuk tugas bahasa yang kompleks. Arsitektur perhatian hibrida menggabungkan Compressed Sparse Attention (CSA) dan Heavily Compressed Attention (HCA) untuk meningkatkan efisiensi konteks panjang. Selain itu, model ini menggabungkan hiper-koneksi terbatasi manifold (mHC) untuk meningkatkan stabilitas propagasi sinyal di seluruh lapisan.

Baca Selengkapnya

Model DeepSeek-V4-Pro-DSpark dilatih sebelumnya pada lebih dari 32 triliun token yang beragam dan berkualitas tinggi, diikuti dengan jalur pasca-pelatihan yang komprehensif. Jalur ini mencakup pengembangan independen dari para ahli spesifik domain melalui fine-tuning terawasi (SFT) dan pembelajaran penguatan dengan optimisasi kebijakan terarah (GRPO), diikuti dengan konsolidasi model terpadu melalui distilasi on-policy.

DeepSeek-V4-Pro-DSpark unggul dalam berbagai tolok ukur, mencapai kinerja terbaik dalam tugas pengkodean dan penalaran. Model ini secara signifikan menjembatani kesenjangan dengan model sumber tertutup terkemuka dalam tugas penalaran dan agen. Model ini mendukung tiga mode usaha penalaran: Non-think, Think High, dan Think Max, yang memenuhi berbagai kasus penggunaan dari tugas rutin hingga pemecahan masalah yang kompleks.

Model ini tersedia untuk diunduh di platform seperti Hugging Face dan ModelScope, dan dilisensikan di bawah MIT License. Pengguna dapat menjalankan model secara lokal dengan instruksi rinci yang disediakan di folder inferensi, yang mencakup konversi bobot model dan demo obrolan interaktif.

  • KategoriModel AI & LLM
  • Model HargaGratis
  • PenerapanCloud, Di-host sendiri
  • PlatformWeb

  • Arsitektur Perhatian Hibrida

  • Hiper-Koneksi Terbatasi Manifold

  • Pengoptimal Muon

  • Panjang Konteks Satu Juta Token

  • Model Mixture-of-Experts

  • Sumber Terbuka

  • Tiga Mode Usaha Penalaran

  • Jalur Pasca-Pelatihan yang Komprehensif

  1. Akses halaman model: Kunjungi halaman model Hugging Face

  2. Autentikasi: Masuk ke akun Hugging Face Anda

  3. Konfigurasi: Siapkan model dengan parameter yang diinginkan

  4. Kirim prompt: Masukkan prompt teks Anda untuk diproses

  5. Fine-tune: Sesuaikan pengaturan model untuk tugas tertentu

  • Pemrosesan Konteks Panjang
  • Pemecahan Masalah Kompleks
  • Tugas Rutin
  • Tolok Ukur Pengkodean
  • Tugas Penalaran

Ulasan DeepSeek-V4-Pro-DSpark

Memuat...

Alat AI Populer Seperti DeepSeek-V4-Pro-DSpark

DeepSeek-V4-Pro adalah model AI canggih yang dirancang untuk kecerdasan konteks dengan jutaan token secara efisien. Model ini memiliki arsitektur perhatian hibrida dan telah…

Model AI & LLM
Lihat Alat

Model AI canggih yang dirancang untuk kecerdasan konteks dengan jutaan token secara efisien. Model ini memiliki arsitektur perhatian hibrida dan telah…DeepSeek-V4-Pro adalah model AI canggih yang dirancang untuk kecerdasan konteks dengan jutaan token secara efisien. Model ini memiliki arsitektur perhatian hibrida dan telah…

UnggulanModel AI & LLM
Lihat Top 50 LLM

DeepSeek-V3 adalah model bahasa Mixture-of-Experts dengan 671 miliar parameter, dirancang untuk inferensi yang efisien dan pelatihan yang hemat biaya. Model ini unggul dalam…

Model AI & LLM

Peringkat 31 di LLM

Lihat Alat

Model bahasa Mixture-of-Experts dengan 671 miliar parameter, dirancang untuk inferensi yang efisien dan pelatihan yang hemat biaya. Model ini unggul dalam…DeepSeek-V3 adalah model bahasa Mixture-of-Experts dengan 671 miliar parameter, dirancang untuk inferensi yang efisien dan pelatihan yang hemat biaya. Model ini unggul dalam…

UnggulanModel AI & LLM
Peringkat 31 di LLM

MiMo-V2.5-Pro adalah model bahasa Mixture-of-Experts sumber terbuka yang canggih, dirancang untuk tugas-tugas kompleks. Model ini memiliki arsitektur perhatian hibrida dan…

Model AI & LLM
Lihat Alat

Model bahasa Mixture-of-Experts sumber terbuka yang canggih, dirancang untuk tugas-tugas kompleks. Model ini memiliki arsitektur perhatian hibrida dan…MiMo-V2.5-Pro adalah model bahasa Mixture-of-Experts sumber terbuka yang canggih, dirancang untuk tugas-tugas kompleks. Model ini memiliki arsitektur perhatian hibrida dan…

Model AI & LLM
Lihat Top 5 Model AI

Hy4 Preview adalah model Mixture-of-Experts generasi baru yang dikembangkan oleh Tim Hy Tencent. Model ini memiliki 770 miliar parameter dan dirancang untuk meningkatkan…

Model AI & LLM

Peringkat 35 di LLM

Lihat Alat

Model Mixture-of-Experts generasi baru yang dikembangkan oleh Tim Hy Tencent. Model ini memiliki 770 miliar parameter dan dirancang untuk meningkatkan…Hy4 Preview adalah model Mixture-of-Experts generasi baru yang dikembangkan oleh Tim Hy Tencent. Model ini memiliki 770 miliar parameter dan dirancang untuk meningkatkan…

Model AI & LLM
Peringkat 35 di LLM

Solar Open 2 adalah model bahasa besar dari Upstage, dirancang untuk kasus penggunaan agentic seperti produktivitas kantor dan pengkodean. Ini memiliki arsitektur Hybrid-Attention…

Model AI & LLM

Peringkat 18 di LLM

Lihat Alat

Model bahasa besar dari Upstage, dirancang untuk kasus penggunaan agentic seperti produktivitas kantor dan pengkodean. Ini memiliki arsitektur Hybrid-Attention…Solar Open 2 adalah model bahasa besar dari Upstage, dirancang untuk kasus penggunaan agentic seperti produktivitas kantor dan pengkodean. Ini memiliki arsitektur Hybrid-Attention…

Model AI & LLM
Peringkat 18 di LLM

Laguna M.1 adalah model Mixture-of-Experts dengan 225B parameter yang dirancang untuk pengkodean agentic dan tugas jangka panjang. Model ini memiliki routing ahli berkapasitas…

Model AI & LLM

Peringkat 36 di LLM

Lihat Alat

Model Mixture-of-Experts dengan 225B parameter yang dirancang untuk pengkodean agentic dan tugas jangka panjang. Model ini memiliki routing ahli berkapasitas…Laguna M.1 adalah model Mixture-of-Experts dengan 225B parameter yang dirancang untuk pengkodean agentic dan tugas jangka panjang. Model ini memiliki routing ahli berkapasitas…

Model AI & LLM
Peringkat 36 di LLM

MiniMax M3 adalah model AI canggih yang unggul dalam pengkodean dan tugas agens. Ini memiliki jendela konteks 1M dan pemahaman multimodal asli, didukung oleh arsitektur MSA. Model…

Model AI & LLM

Peringkat 49 di LLM

Lihat Alat

Model AI canggih yang unggul dalam pengkodean dan tugas agens. Ini memiliki jendela konteks 1M dan pemahaman multimodal asli, didukung oleh arsitektur MSA. Model…MiniMax M3 adalah model AI canggih yang unggul dalam pengkodean dan tugas agens. Ini memiliki jendela konteks 1M dan pemahaman multimodal asli, didukung oleh arsitektur MSA. Model…

Model AI & LLM
Peringkat 49 di LLM

Ling-3.0-tiny adalah model penalaran hibrida ringan dengan 7,9 miliar parameter, dirancang untuk penerapan lokal yang efisien. Model ini mendukung respons cepat dan penalaran…

Model AI & LLM
Lihat Alat

Model penalaran hibrida ringan dengan 7,9 miliar parameter, dirancang untuk penerapan lokal yang efisien. Model ini mendukung respons cepat dan penalaran…Ling-3.0-tiny adalah model penalaran hibrida ringan dengan 7,9 miliar parameter, dirancang untuk penerapan lokal yang efisien. Model ini mendukung respons cepat dan penalaran…

Model AI & LLM
Lihat Top 50 LLM
1 dari 8