Deskripsi
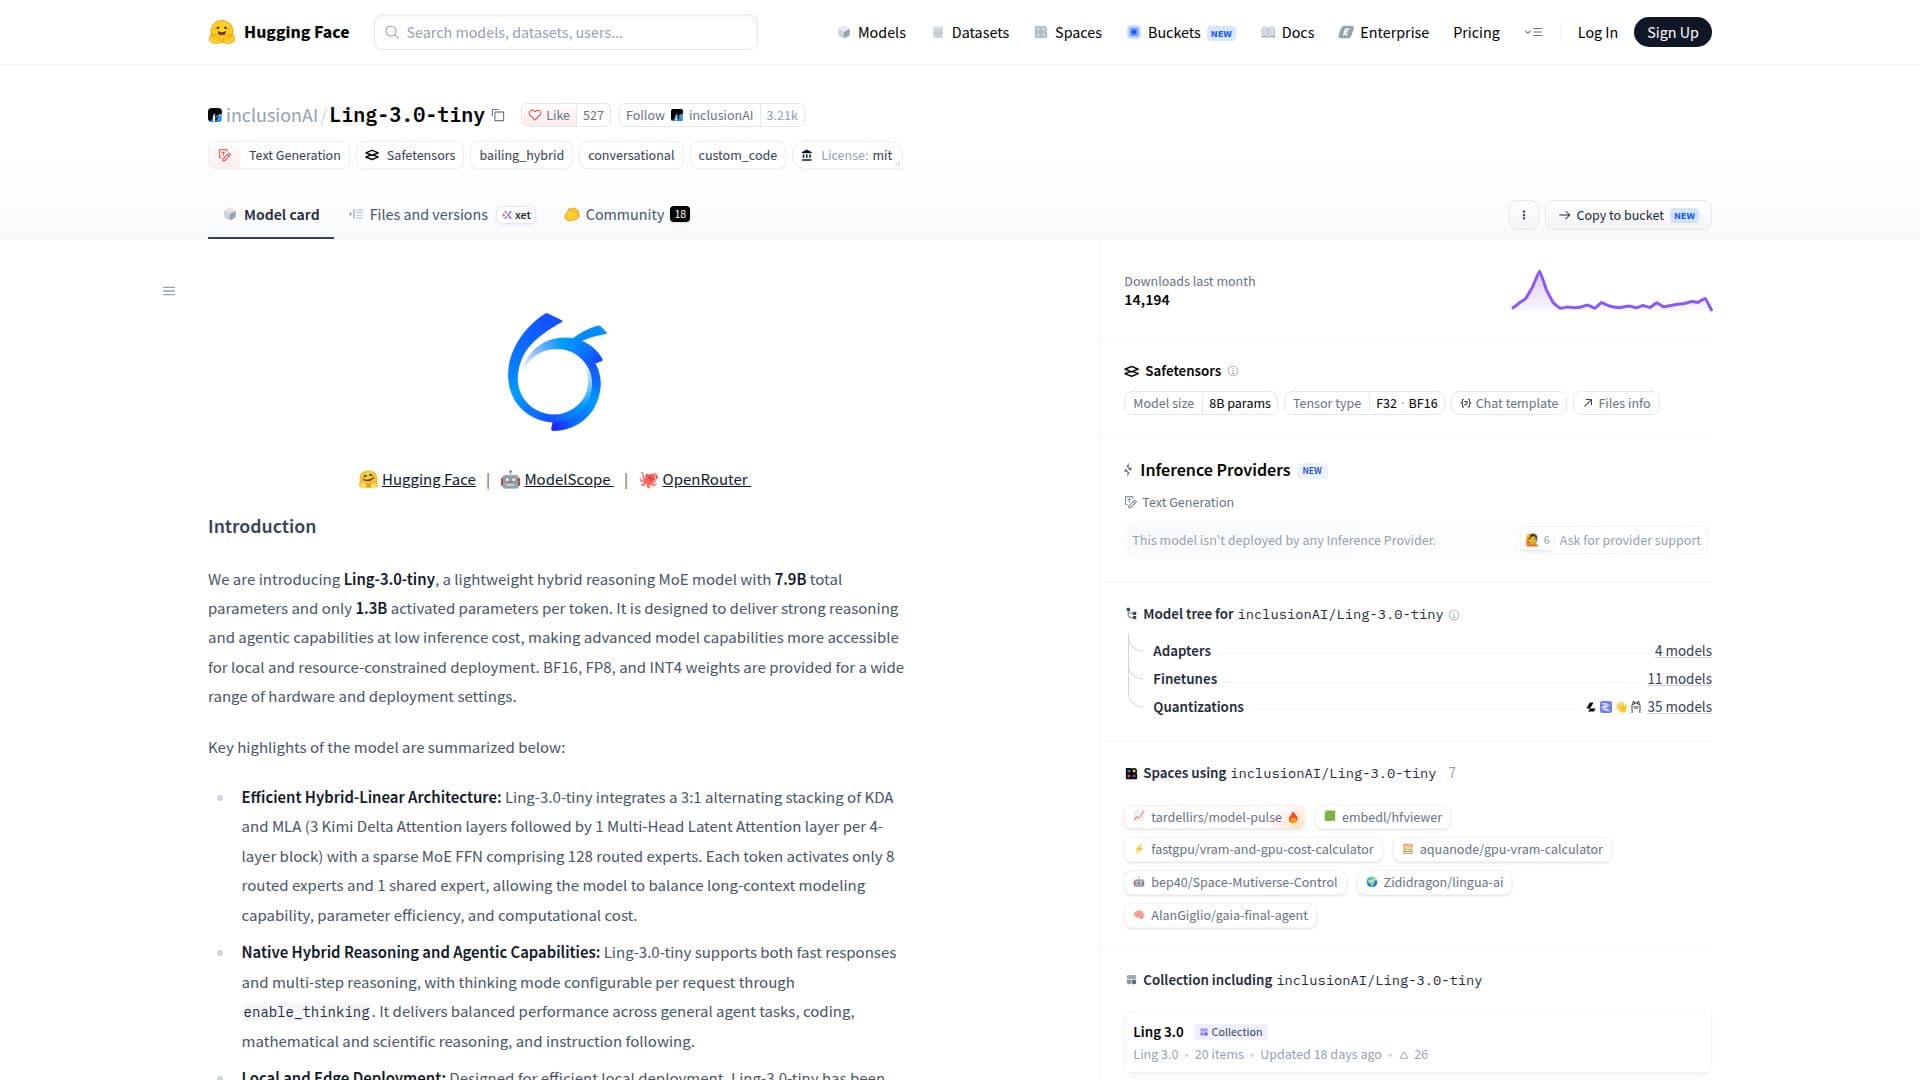
Ling-3.0-tiny adalah model penalaran hibrida ringan yang dikembangkan oleh inclusionAI, dihosting di Hugging Face. Model ini memiliki total 7,9 miliar parameter, dengan hanya 1,3 miliar yang diaktifkan per token, menjadikannya efisien untuk penerapan lokal dan terbatas sumber daya. Model ini mengintegrasikan tumpukan bergantian 3:1 dari Kimi Delta Attention (KDA) dan Multi-Head Latent Attention (MLA), bersama dengan Jaringan Feed-Forward Mixture of Experts (MoE) yang jarang dengan 128 ahli yang terhubung. Arsitektur ini memungkinkan model untuk menyeimbangkan kemampuan pemodelan konteks panjang, efisiensi parameter, dan biaya komputasi.
Baca Selengkapnya
Ling-3.0-tiny dirancang untuk memberikan kemampuan penalaran dan agen yang kuat dengan biaya inferensi yang rendah. Model ini mendukung respons cepat dan penalaran multi-langkah, dengan mode berpikir yang dapat dikonfigurasi. Model ini telah divalidasi pada berbagai perangkat keras, termasuk NVIDIA DGX Spark dan Apple Silicon MacBook, memungkinkan penalaran yang mampu dan beban kerja agen tanpa memerlukan GPU kelas pusat data. Dengan FP8, model ini mencapai sekitar 100-105 token per detik di DGX Spark dan 86-90 token per detik di MacBook M4 Pro, dengan penggunaan memori puncak sekitar 8,34 GiB pada panjang konteks 8K.
Efisiensi model ini ditunjukkan oleh kinerjanya pada Artificial Analysis Intelligence Index v4.1.1, dengan skor 25, dan pada Artificial Analysis Agentic Index, dengan skor 16. Model ini mencapai kecepatan keluaran lebih dari 160 token per detik, dengan latensi end-to-end sekitar 18 detik untuk respons 500 token. Ling-3.0-tiny cocok untuk berbagai tugas, termasuk tugas agen, pengkodean, pemahaman konteks panjang, keandalan pengetahuan, penalaran matematis dan ilmiah, serta mengikuti instruksi.
- KategoriModel AI & LLM
- Model HargaFreemium
- PenerapanBerjalan lokal
- PlatformWeb
Sorotan Ling-3.0-tiny
7,9 miliar total parameter
1,3 miliar parameter yang diaktifkan per token
Kemampuan penalaran hibrida
Penerapan lokal yang efisien
Arsitektur KDA-MLA 3:1
MoE FFN jarang dengan 128 ahli
Mendukung respons cepat dan penalaran multi-langkah
Divalidasi pada NVIDIA DGX Spark dan Apple Silicon
Memulai dengan Ling-3.0-tiny
Akses halaman model: Kunjungi Hugging Face
Autentikasi: Masuk ke akun Anda
Konfigurasi: Atur parameter model
Kirim prompt: Gunakan model untuk inferensi
Fine-tune: Sesuaikan pengaturan untuk tugas tertentu
Kasus Penggunaan Ling-3.0-tiny
- Tugas Agen
- Pengkodean
- Penalaran Ilmiah
- Mengikuti Instruksi
- Penerapan Lokal