

Deskripsi
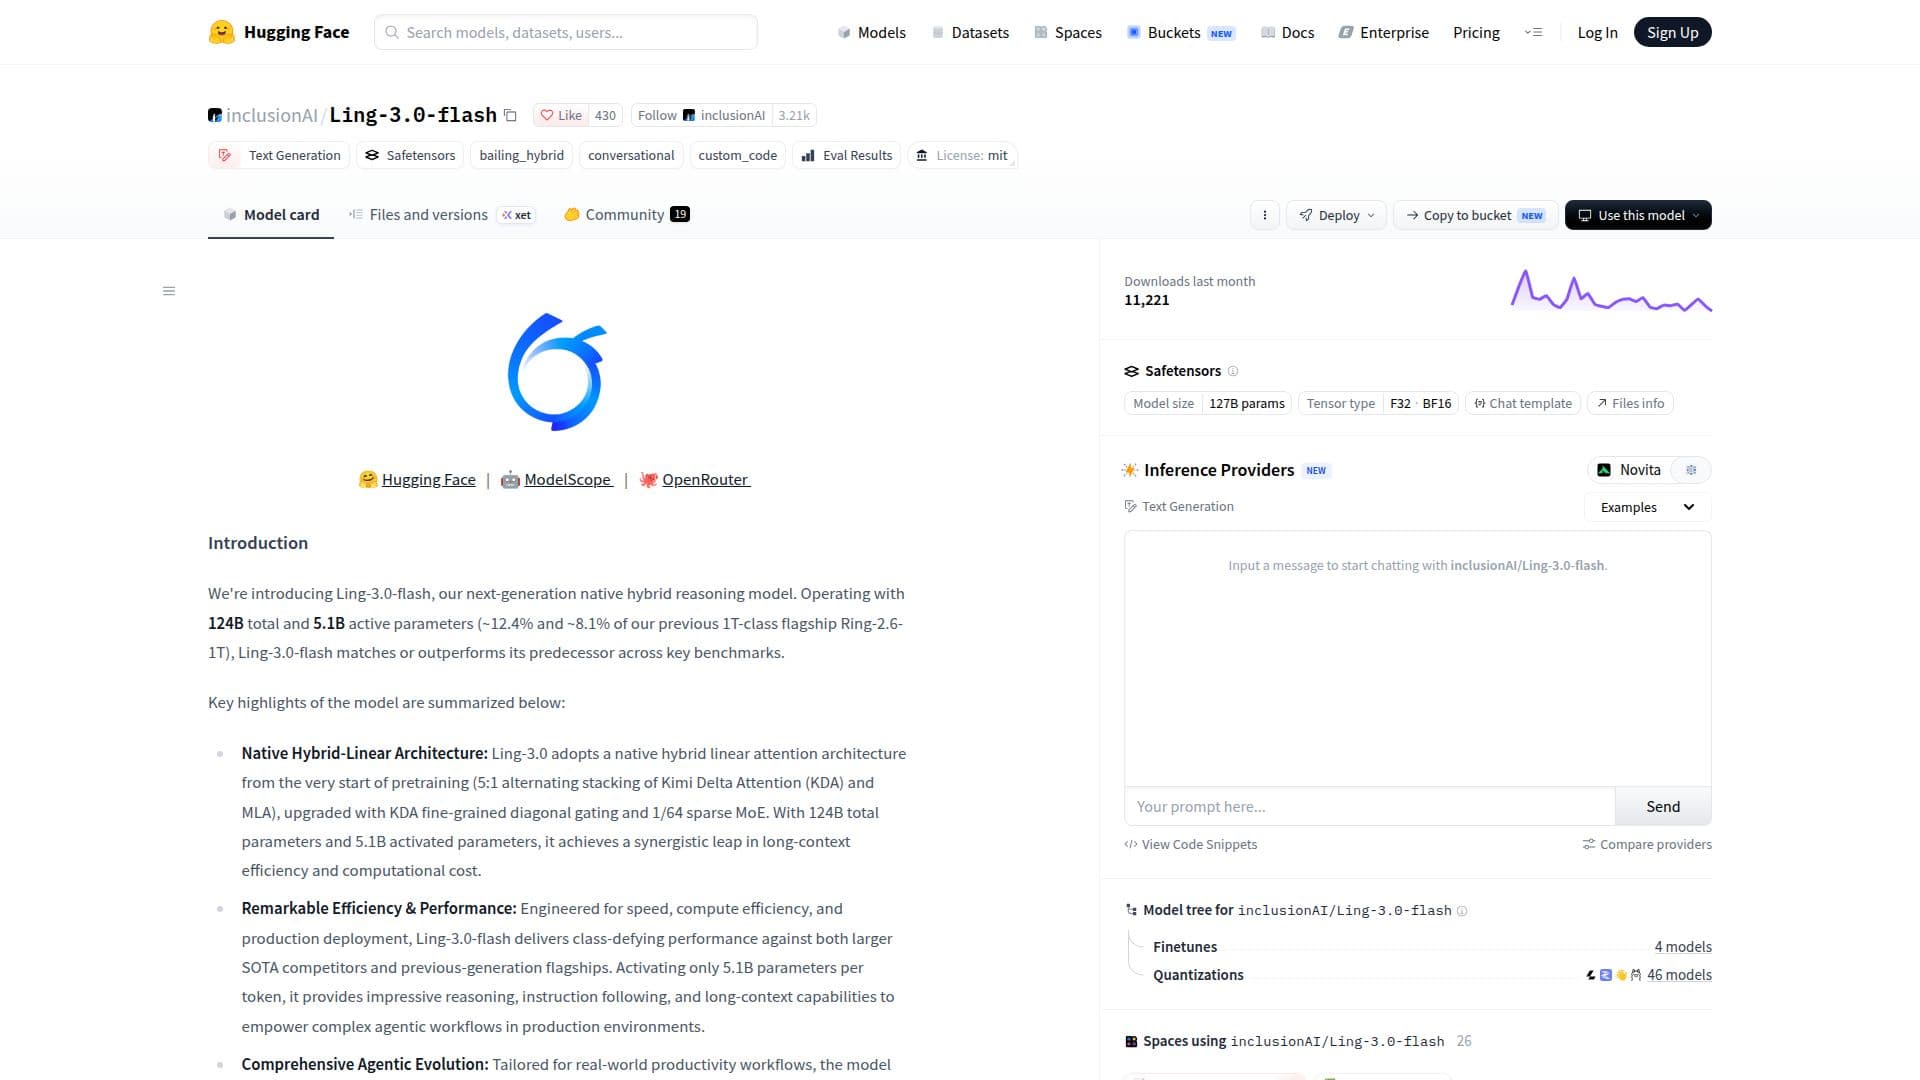
Ling-3.0-flash adalah model penalaran hibrida mutakhir yang dikembangkan oleh inclusionAI dan dihosting di Hugging Face. Model ini beroperasi dengan total 124 miliar parameter, dengan 5,1 miliar diaktifkan per token, memberikan efisiensi dan kinerja yang luar biasa. Model ini mengadopsi arsitektur perhatian linier hibrida asli, menampilkan Kimi Delta Attention (KDA) dan MLA, yang ditingkatkan dengan pengaturan diagonal halus dan MoE jarang. Arsitektur ini memungkinkan Ling-3.0-flash mencapai lompatan sinergis dalam efisiensi konteks panjang dan biaya komputasi.
Baca Selengkapnya
Dirancang untuk kecepatan dan efisiensi komputasi, Ling-3.0-flash memberikan kinerja yang melampaui kelas dibandingkan dengan pesaing mutakhir yang lebih besar dan flagship generasi sebelumnya. Model ini memberdayakan alur kerja agenik yang kompleks di lingkungan produksi, hanya mengaktifkan 5,1 miliar parameter per token. Model ini menggabungkan lebih dari 10.000 lingkungan pelatihan interaktif untuk mencapai eksekusi loop tertutup end-to-end di seluruh tugas pemrograman, umum, dan penelitian mendalam.
Ling-3.0-flash mengintegrasikan arsitektur caching hierarkis SGLang HiCache + Mooncake, yang menampilkan kolam fisik ganda dan cache L3 yang dibagikan kluster. Pengaturan ini menghilangkan perhitungan ulang yang tidak perlu selama interaksi jangka panjang, mengurangi Waktu ke Token Pertama (TTFT) sebesar 60% hingga lebih dari 80% dalam skenario input panjang. Model ini menunjukkan kinerja yang kuat di berbagai tolok ukur otoritatif, termasuk SWE-Bench Pro, SWE-Bench Multilingual, Tau3-banking-AA, MCP-Atlas, dan SkillsBench.
Model ini dirancang untuk alur kerja produktivitas dunia nyata, memberikan kinerja yang kuat dalam pengetahuan umum, penalaran matematis, mengikuti instruksi, dan pemahaman konteks panjang. Ling-3.0-flash dirancang untuk penerapan produksi, menawarkan kemampuan penalaran yang mengesankan dan efisiensi konteks panjang, menjadikannya cocok untuk alur kerja agenik yang kompleks.
- KategoriModel AI & LLM
- Model HargaFreemium
- PenerapanCloud
- PlatformWeb
Sorotan Ling-3.0-flash
Arsitektur Hibrida-Linier Asli
Efisiensi & Kinerja yang Luar Biasa
Evolusi Agenik yang Komprehensif
Caching SGLang HiCache + Mooncake
Eksekusi Loop Tertutup End-to-End
Efisiensi Konteks Panjang
Mengikuti Instruksi
Penalaran Matematis
Memulai dengan Ling-3.0-flash
Akses halaman model: Kunjungi Hugging Face
Autentikasi: Masuk ke akun Anda
Konfigurasi: Atur parameter dan preferensi
Kirim prompt: Masukkan pertanyaan Anda
Sesuaikan: Sesuaikan pengaturan model
Kasus Penggunaan Ling-3.0-flash
- Tugas Pemrograman
- Agen Penelitian
- Mengikuti Instruksi
- Pemahaman Konteks Panjang
- Penalaran Matematis







