Description
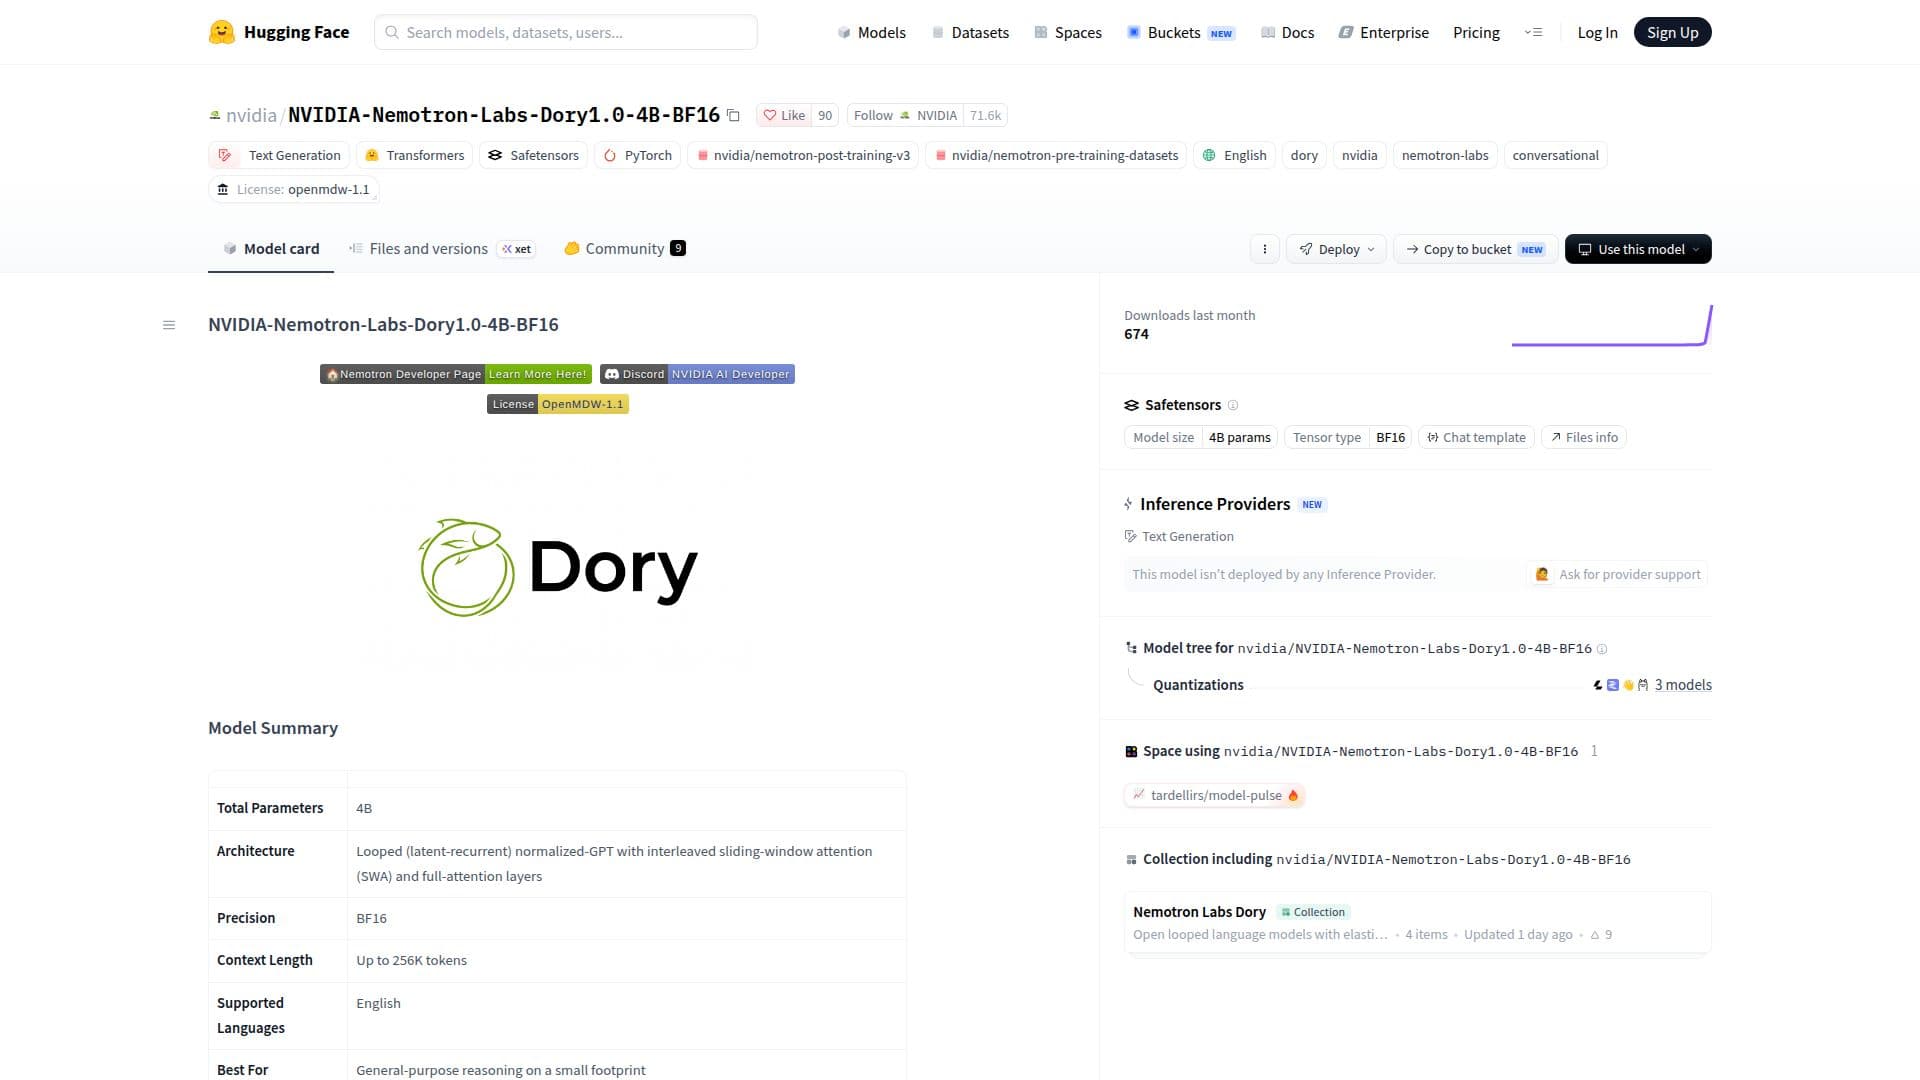
NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16 est un modèle de langage de grande taille développé par NVIDIA, utilisant une architecture normalisée-GPT en boucle (latent-récurrent). Ce modèle est conçu pour gérer des tâches de raisonnement général tout en maintenant une empreinte computationnelle réduite. Il dispose d'une attention à fenêtre glissante entrelacée (SWA) et de couches d'attention complète, lui permettant de traiter efficacement jusqu'à 256K tokens en longueur de contexte.
Lire la suite
Le modèle est construit avec 4 milliards de paramètres et utilise une précision BF16, ce qui le rend adapté aux applications commerciales et non commerciales. Il prend en charge le traitement de la langue anglaise et est particulièrement adapté aux tâches nécessitant des capacités de raisonnement général. L'architecture du modèle permet un calcul d'inférence élastique, permettant aux utilisateurs d'ajuster le nombre de boucles pour équilibrer l'efficacité computationnelle et la précision sans avoir besoin de réentraînement.
Dory1.0-4B-BF16 est pré-entraîné en utilisant le format NVFP4 de NVIDIA avant de continuer en BF16, garantissant des performances élevées sur les systèmes accélérés par GPU NVIDIA. Il est disponible dans plusieurs formats, y compris BF16, MXFP8, NVFP4 et Q5_K_M, offrant une flexibilité de déploiement sur différentes configurations matérielles.
L'entraînement du modèle a impliqué 6 trillions de tokens, avec un accent sur des domaines divers tels que les mathématiques, la science et les connaissances générales. Il a subi un ajustement fin supervisé et un apprentissage par renforcement pour améliorer ses performances dans l'utilisation d'outils multi-étapes, le suivi d'instructions et les environnements de sortie structurée. Les benchmarks du modèle démontrent des performances compétitives dans diverses tâches, y compris le codage, le raisonnement et le suivi d'instructions.
NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16 est régi par l'Accord de Licence OpenMDW, version 1.1, et a été publié le 16 octobre 2026. Il est conçu pour fonctionner de manière optimale sur les architectures Hopper et Blackwell de NVIDIA, avec un support pour les systèmes d'exploitation Linux.
- CatégorieModèles d'IA et LLM
- Modèle tarifaireOpen source
- DéploiementCloud
- PlateformesLinux
Points forts de NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16
Architecture latente-récurrente en boucle
Attention à fenêtre glissante entrelacée
Longueur de contexte de 256K tokens
Précision BF16
Calcul d'inférence élastique
Pré-entraînement natif NVFP4
Bouclage économe en mémoire
Accord de Licence OpenMDW
Premiers pas avec NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16
Accéder à la page du modèle : Visitez la page du modèle Hugging Face pour NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16.
Authentifier : Assurez-vous d'avoir les identifiants nécessaires pour accéder au modèle.
Configurer : Configurez les paramètres du modèle, y compris le nombre de boucles et les paramètres de cache KV.
Envoyer des invites : Saisissez des séquences de texte au modèle pour traitement.
Ajuster : Modifiez les paramètres du modèle pour des tâches spécifiques si nécessaire.
Cas d'utilisation de NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16
- Raisonnement Général
- Tâches de Codage
- Suivi d'Instructions
- Traitement de Long Contexte
- Recherche Scientifique