Description
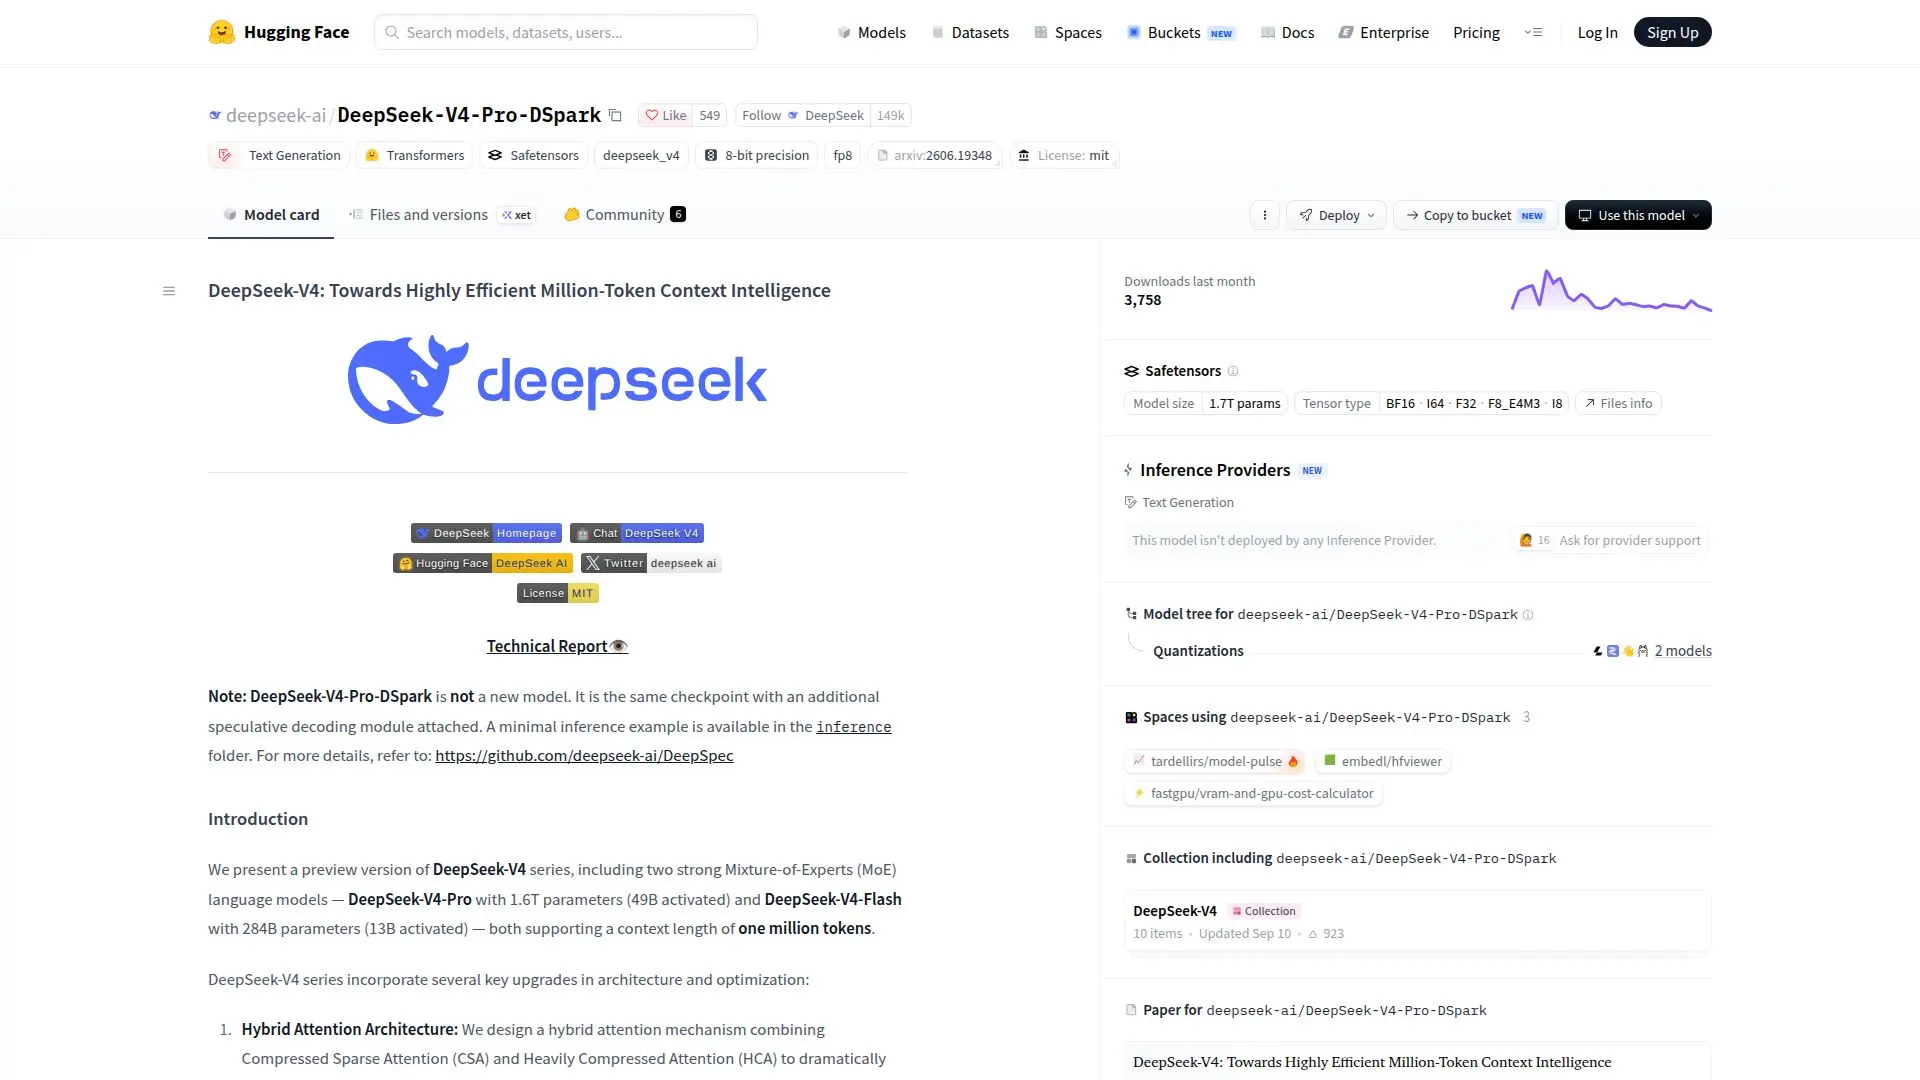
DeepSeek-V4-Pro-DSpark fait partie de la série DeepSeek-V4, qui comprend des modèles de langage Mixture-of-Experts (MoE) hautement efficaces. Ce modèle est conçu pour gérer des longueurs de contexte étendues allant jusqu'à un million de tokens, ce qui le rend adapté aux tâches linguistiques complexes. L'architecture d'attention hybride combine l'Attention Éparse Comprimée (CSA) et l'Attention Fortement Comprimée (HCA) pour améliorer l'efficacité des longs contextes. De plus, le modèle intègre des connexions hyper-contraintes sur variétés (mHC) pour améliorer la stabilité de la propagation du signal à travers les couches.
Lire la suite
Le modèle DeepSeek-V4-Pro-DSpark est pré-entraîné sur plus de 32 trillions de tokens divers et de haute qualité, suivi d'un pipeline de post-formation complet. Ce pipeline comprend la culture indépendante d'experts spécifiques au domaine grâce à un ajustement fin supervisé (SFT) et un apprentissage par renforcement avec optimisation de politique guidée (GRPO), suivi d'une consolidation unifiée du modèle via distillation en politique.
DeepSeek-V4-Pro-DSpark excelle dans divers benchmarks, atteignant des performances de premier plan dans les tâches de codage et de raisonnement. Il comble significativement l'écart avec les modèles propriétaires de premier plan sur les tâches de raisonnement et d'agent. Le modèle prend en charge trois modes d'effort de raisonnement : Non-pensée, Pensée Élevée et Pensée Maximale, répondant à différents cas d'utilisation allant des tâches routinières à la résolution de problèmes complexes.
Le modèle est disponible en téléchargement sur des plateformes comme Hugging Face et ModelScope, et il est sous licence MIT. Les utilisateurs peuvent exécuter le modèle localement avec des instructions détaillées fournies dans le dossier d'inférence, qui comprend la conversion des poids du modèle et des démonstrations de chat interactives.
- CatégorieModèles d'IA et LLM
- Modèle tarifaireGratuit
- DéploiementCloud, Auto-hébergé
- PlateformesWeb
Points forts de DeepSeek-V4-Pro-DSpark
Architecture d'Attention Hybride
Connexions Hyper-Contraintes sur Variétés
Optimiseur Muon
Longueur de Contexte d'un Million de Tokens
Modèle Mixture-of-Experts
Open Source
Trois Modes d'Effort de Raisonnement
Pipeline de Post-Formation Complet
Premiers pas avec DeepSeek-V4-Pro-DSpark
Accéder à la page du modèle : Visitez la page du modèle Hugging Face
S'authentifier : Connectez-vous à votre compte Hugging Face
Configurer : Configurez le modèle avec les paramètres souhaités
Envoyer des invites : Saisissez vos invites textuelles pour traitement
Ajuster : Modifiez les paramètres du modèle pour des tâches spécifiques
Cas d'utilisation de DeepSeek-V4-Pro-DSpark
- Traitement de Longs Contextes
- Résolution de Problèmes Complexes
- Tâches Routinières
- Benchmarks de Codage
- Tâches de Raisonnement