Aller au contenu principal
ToolPotion
Conseiller IA
Soumettre

Ling-3.1-flash

LLM#41Modèles d'IA et LLMOpen source · Web

Ling-3.1-flash est un modèle avancé de raisonnement hybride conçu pour des tâches complexes du monde réel. Il dispose de 560 milliards de paramètres au total et d'une fenêtre de contexte de 1 million de jetons, améliorant les performances dans divers domaines, y compris la santé, la finance et l'ingénierie logicielle.

Visiter l'URL
Partager
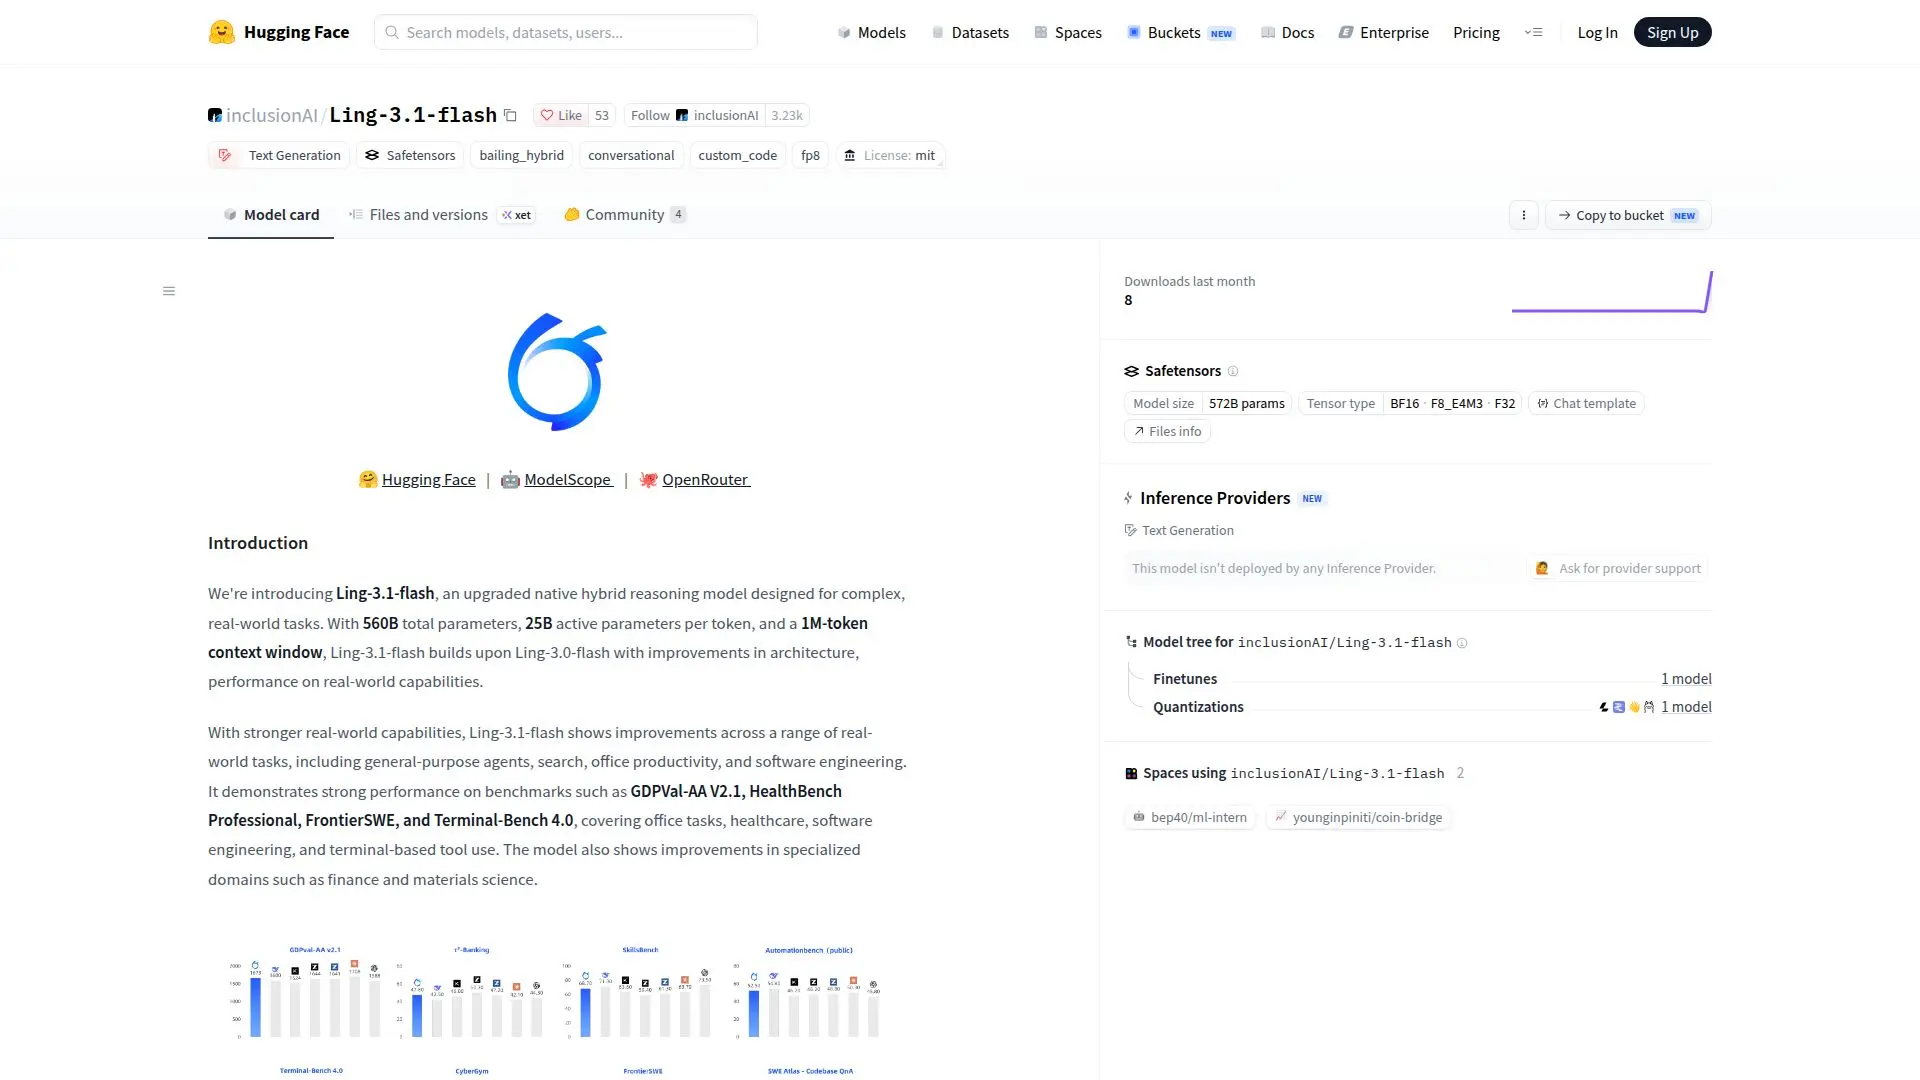
Capture d’écran de Ling-3.1-flash

Ling-3.1-flash est un modèle de raisonnement hybride natif amélioré introduit par inclusionAI sur la plateforme Hugging Face. Conçu pour s'attaquer à des tâches complexes du monde réel, ce modèle dispose d'un total de 560 milliards de paramètres, avec 25 milliards de paramètres actifs par jeton et une fenêtre de contexte de 1 million de jetons. Ces améliorations s'appuient sur son prédécesseur, Ling-3.0-flash, offrant une architecture et des performances améliorées.

Lire la suite

Le modèle excelle dans une variété d'applications du monde réel, telles que les agents à usage général, la recherche, la productivité de bureau et l'ingénierie logicielle. Il a démontré de solides performances sur des benchmarks tels que GDPVal-AA V2.1, HealthBench Professional, FrontierSWE et Terminal-Bench 4.0. Ces benchmarks couvrent un large éventail de tâches, y compris les tâches de bureau, la santé, l'ingénierie logicielle et l'utilisation d'outils basés sur des terminaux. De plus, Ling-3.1-flash montre des améliorations notables dans des domaines spécialisés tels que la finance et la science des matériaux.

L'architecture de Ling-3.1-flash est basée sur un modèle hybride-linéaire de mélange d'experts (MoE), avec 63 KDA et 9 couches de transformateurs Gated MLA, 4 couches denses et 512 experts routés. Le modèle comprend également 64 têtes d'attention et une taille cachée de 4096, avec une taille de vocabulaire de 157 184.

Ling-3.1-flash a été évalué sur plusieurs benchmarks autorisés, montrant ses solides performances dans les tâches de codage et d'agents. Il prend en charge des frameworks tels que Claude Code, Kilo Code, Qwen Code, Hermes Agent et OpenClaw. Le modèle introduit également LingCode, un harnais construit sur l'agent de codage open-source Pi, qui améliore les performances sur des tâches de codage complexes et à long terme.

Pour les utilisateurs souhaitant commencer, l'image SGLang recommandée inclut le support de Ling-3.1-flash, le décodage spéculatif MTP et les optimisations de décodage Hopper. Le modèle est disponible pour l'inférence sur diverses configurations de serveur, et des recettes vérifiées sont fournies pour différents matériels.

  • CatégorieModèles d'IA et LLM
  • Modèle tarifaireOpen source
  • DéploiementCloud
  • PlateformesWeb

  • 560B paramètres au total

  • Fenêtre de contexte de 1M jetons

  • Architecture hybride-linéaire MoE

  • 63 KDA + 9 couches Gated MLA

  • 512 experts routés

  • 64 têtes d'attention

  • Prend en charge plusieurs frameworks

  • Performances solides sur les benchmarks

  1. Accéder à la page du modèle : Visitez Hugging Face

  2. S'authentifier : Connectez-vous à votre compte

  3. Configurer : Configurez l'environnement serveur ou client

  4. Envoyer des invites : Utilisez des recettes vérifiées pour l'inférence

  • Agents à usage général
  • Productivité de bureau
  • Ingénierie logicielle
  • Applications de santé
  • Analyse financière

Avis sur Ling-3.1-flash

Chargement...

Outils IA populaires comme Ling-3.1-flash

Ling-3.0-flash est un modèle de raisonnement hybride de nouvelle génération conçu pour l'efficacité et la performance. Avec 124 milliards de paramètres, il excelle dans le…

Modèles d'IA et LLM
Voir l'outil

Modèle de raisonnement hybride de nouvelle génération conçu pour l'efficacité et la performance. Avec 124 milliards de paramètres, il excelle dans le…Ling-3.0-flash est un modèle de raisonnement hybride de nouvelle génération conçu pour l'efficacité et la performance. Avec 124 milliards de paramètres, il excelle dans le…

Modèles d'IA et LLM
Voir le Top 50 LLM

L'étape 3.7 Flash est un modèle de vision-langage Mixture-of-Experts (MoE) sparse conçu pour des charges de travail de production à haute fréquence. Il combine une architecture…

Modèles d'IA et LLM
Voir l'outil

L'étape 3.7 Flash est un modèle de vision-langage Mixture-of-Experts (MoE) sparse conçu pour des charges de travail de production à haute fréquence. Il combine une architecture…

Modèles d'IA et LLM
Voir le Top 50 LLM

Kolibri 1 est un modèle de langage multilingue développé par Aleph Alpha. Il excelle dans le raisonnement en plusieurs étapes, la génération augmentée par récupération et les…

Modèles d'IA et LLM

N°22 en LLM

Voir l'outil

Modèle de langage multilingue développé par Aleph Alpha. Il excelle dans le raisonnement en plusieurs étapes, la génération augmentée par récupération et les…Kolibri 1 est un modèle de langage multilingue développé par Aleph Alpha. Il excelle dans le raisonnement en plusieurs étapes, la génération augmentée par récupération et les…

Modèles d'IA et LLM
N°22 en LLM

Ling-3.0-tiny est un modèle de raisonnement hybride léger avec 7,9 milliards de paramètres, conçu pour un déploiement local efficace. Il prend en charge des réponses rapides et un…

Modèles d'IA et LLM
Voir l'outil

Modèle de raisonnement hybride léger avec 7,9 milliards de paramètres, conçu pour un déploiement local efficace. Il prend en charge des réponses rapides et un…Ling-3.0-tiny est un modèle de raisonnement hybride léger avec 7,9 milliards de paramètres, conçu pour un déploiement local efficace. Il prend en charge des réponses rapides et un…

Modèles d'IA et LLM
Voir le Top 50 LLM

LiquidAI LFM2.5-24B-A2B est un modèle de raisonnement à 24B de paramètres, optimisé pour des agents rapides et privés sur appareil. Il offre une inférence efficace et prend en…

Modèles d'IA et LLM

N°40 en LLM

Voir l'outil

Modèle de raisonnement à 24B de paramètres, optimisé pour des agents rapides et privés sur appareil. Il offre une inférence efficace et prend en…LiquidAI LFM2.5-24B-A2B est un modèle de raisonnement à 24B de paramètres, optimisé pour des agents rapides et privés sur appareil. Il offre une inférence efficace et prend en…

Modèles d'IA et LLM
N°40 en LLM

Qwen3-235B-A22B-Instruct-2507 est un modèle d'IA avancé conçu pour améliorer le suivi des instructions, le raisonnement logique et les capacités multilingues. Il excelle dans la…

Modèles d'IA et LLM
Voir l'outil

Modèle d'IA avancé conçu pour améliorer le suivi des instructions, le raisonnement logique et les capacités multilingues. Il excelle dans la…Qwen3-235B-A22B-Instruct-2507 est un modèle d'IA avancé conçu pour améliorer le suivi des instructions, le raisonnement logique et les capacités multilingues. Il excelle dans la…

Modèles d'IA et LLM
Voir le Top 50 LLM

Spark-X2.5-4B est un modèle de langage compact et polyvalent conçu pour l'efficacité et l'accessibilité. Il prend en charge plus de 200 langues et excelle dans des tâches telles…

Modèles d'IA et LLM

N°24 en LLM

Voir l'outil

Modèle de langage compact et polyvalent conçu pour l'efficacité et l'accessibilité. Il prend en charge plus de 200 langues et excelle dans des tâches telles…Spark-X2.5-4B est un modèle de langage compact et polyvalent conçu pour l'efficacité et l'accessibilité. Il prend en charge plus de 200 langues et excelle dans des tâches telles…

Modèles d'IA et LLM
N°24 en LLM

LiquidAI LFM2.5-2.6B est un modèle hybride conçu pour le déploiement sur appareil, offrant une inférence efficace et des capacités agentiques. Il prend en charge plusieurs langues…

Modèles d'IA et LLM

N°26 en LLM

Voir l'outil

Modèle hybride conçu pour le déploiement sur appareil, offrant une inférence efficace et des capacités agentiques. Il prend en charge plusieurs langues…LiquidAI LFM2.5-2.6B est un modèle hybride conçu pour le déploiement sur appareil, offrant une inférence efficace et des capacités agentiques. Il prend en charge plusieurs langues…

Modèles d'IA et LLM
N°26 en LLM
1 sur 8