Description
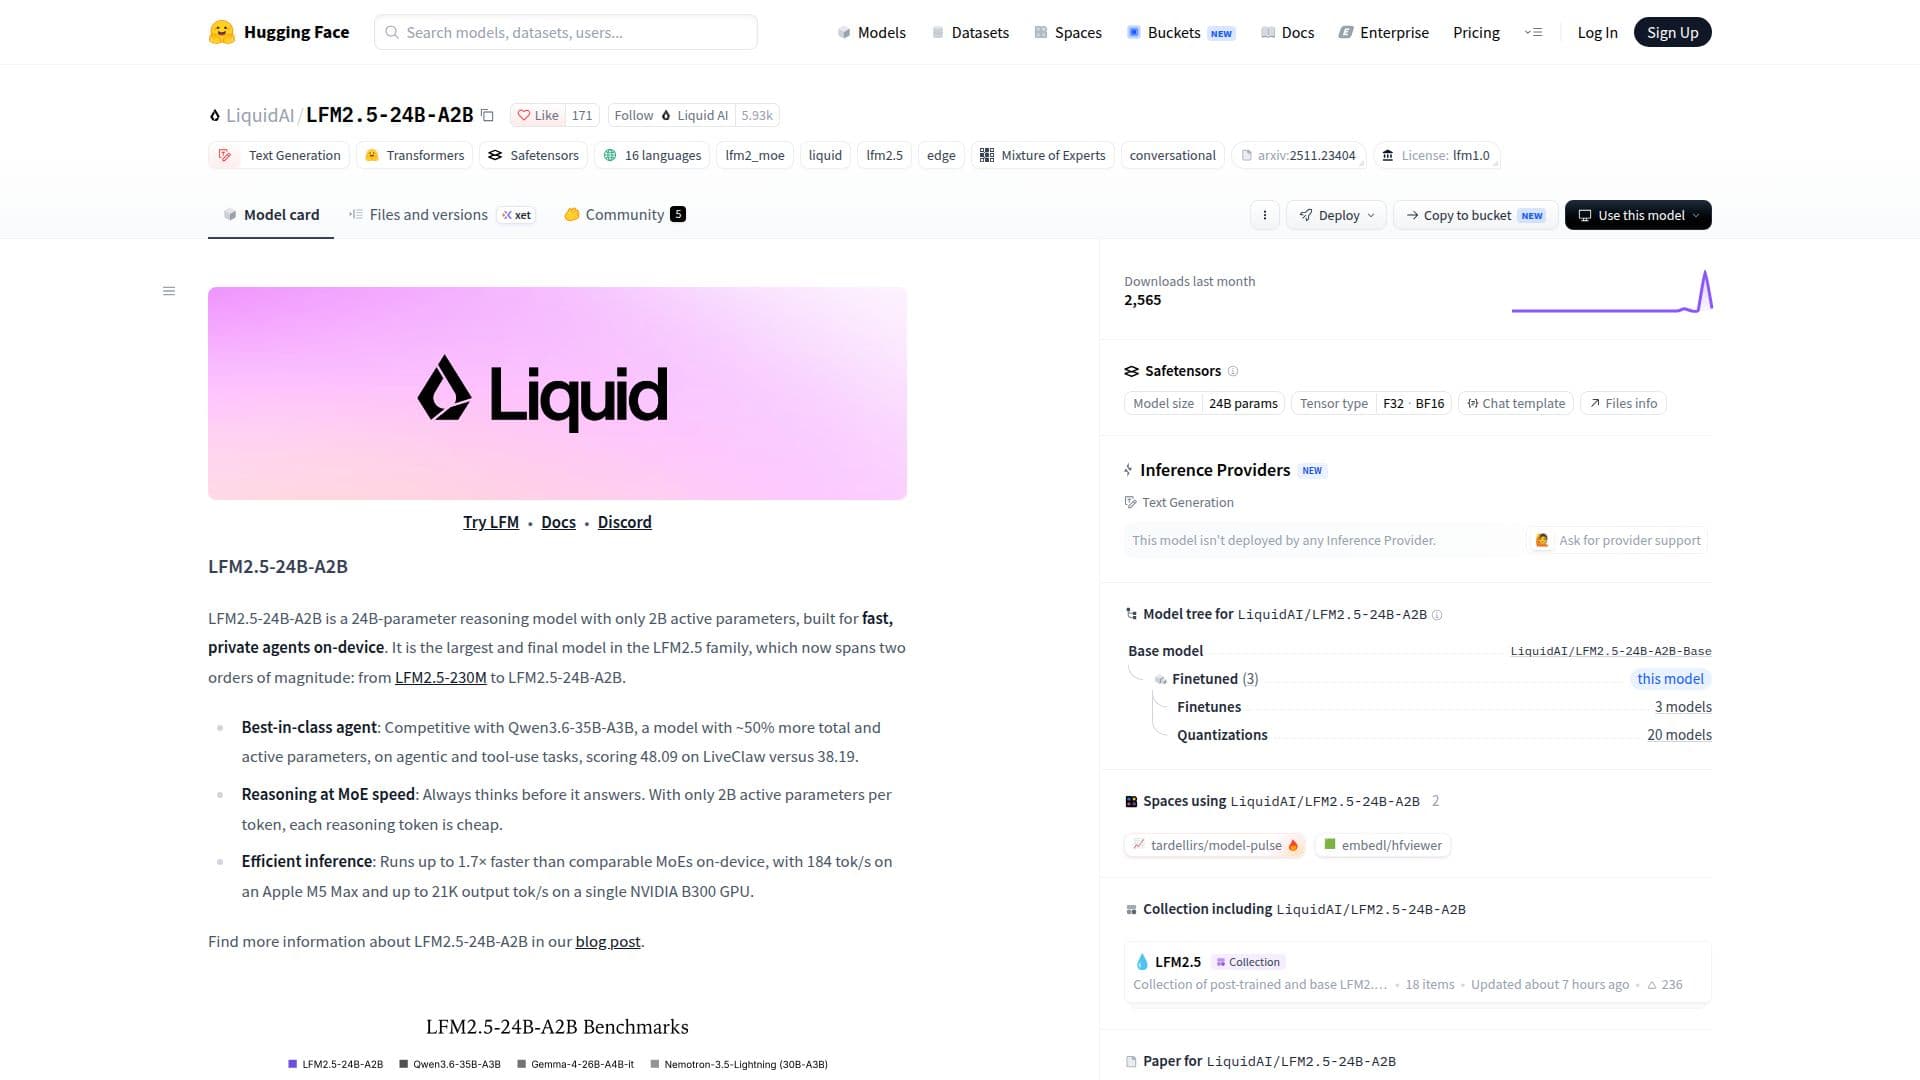
LiquidAI LFM2.5-24B-A2B est un modèle de raisonnement à la pointe de la technologie, conçu pour fonctionner efficacement avec seulement 2B de paramètres actifs sur un total de 24B. Ce modèle fait partie de la famille LFM2.5 et est adapté aux applications rapides et privées sur appareil. Il excelle dans les tâches agentiques et d'utilisation d'outils, montrant des performances compétitives par rapport à des modèles plus grands comme Qwen3.6-35B-A3B.
Lire la suite
Le modèle est conçu pour une inférence efficace, fonctionnant jusqu'à 1,7 fois plus vite que des modèles comparables sur des appareils tels que l'Apple M5 Max et le GPU NVIDIA B300. Il prend en charge un large éventail de langues, y compris l'anglais, l'arabe, le chinois, et plus encore, ce qui le rend polyvalent pour des applications multilingues.
LFM2.5-24B-A2B est disponible dans divers formats, y compris FP8 pour un service GPU à haut débit, GGUF pour l'inférence CPU, et ONNX pour un déploiement multiplateforme. Cette flexibilité permet de l'intégrer dans des environnements divers, du cloud à l'edge en passant par le mobile.
Le modèle est particulièrement adapté aux applications nécessitant des capacités de raisonnement et d'appel d'outils. Il prend en charge l'appel de fonctions dans un processus structuré en quatre étapes, améliorant son utilité dans les flux de travail agentiques. Cependant, il n'est pas recommandé pour des tâches lourdes en connaissances sans capacités de récupération ou de recherche sur le web supplémentaires.
Pour les développeurs, LFM2.5-24B-A2B offre de nombreuses options de fine-tuning, y compris le fine-tuning supervisé et l'optimisation directe des préférences à l'aide de frameworks comme Unsloth et TRL. Les performances du modèle ont été évaluées sur diverses tâches, montrant systématiquement une grande efficacité et rapidité.
Dans l'ensemble, LiquidAI LFM2.5-24B-A2B est un choix robuste pour les développeurs à la recherche d'un modèle de raisonnement puissant et efficace pour des applications sur appareil.
- CatégorieModèles d'IA et LLM
- Modèle tarifaireOpen source
- DéploiementCloud, Sur site
- PlateformesWeb, Windows, macOS
Points forts de LiquidAI LFM2.5-24B-A2B
24B de paramètres au total
2B de paramètres actifs
Inférence efficace sur appareil
Prend en charge plusieurs langues
Capacités d'appel d'outils
Disponible dans plusieurs formats
Support de fine-tuning
Inférence GPU à grande vitesse
Premiers pas avec LiquidAI LFM2.5-24B-A2B
Accéder à la page du modèle : Visitez la page du modèle Hugging Face
Authentifier : Connectez-vous à votre compte Hugging Face
Configurer : Configurez le modèle pour votre cas d'utilisation spécifique
Envoyer des invites : Utilisez le modèle pour des tâches de raisonnement
Fine-tuner : Personnalisez le modèle avec vos données
Cas d'utilisation de LiquidAI LFM2.5-24B-A2B
- Support Multilingue
- Agents sur Appareil
- Flux de Travail d'Appel d'Outils
- Déploiement Multiplateforme
- Applications de Fine-Tuning