Description
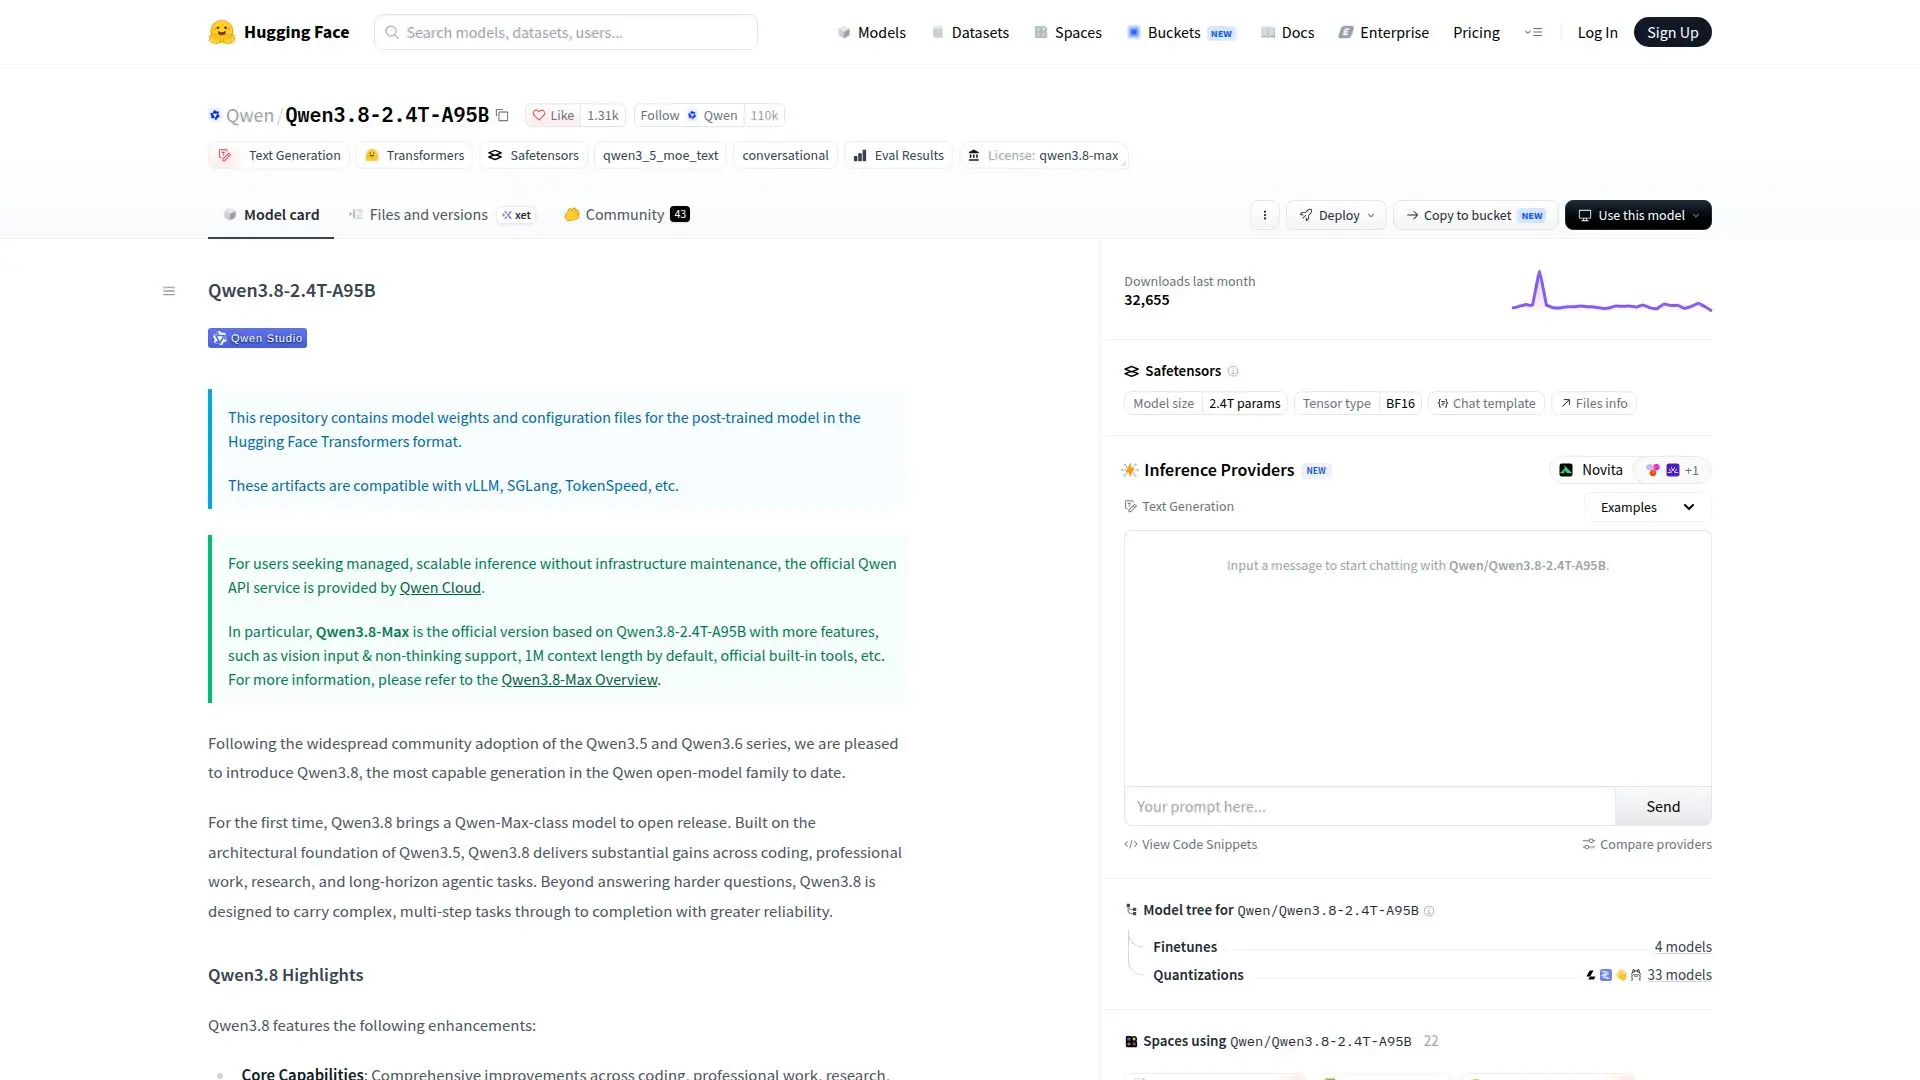
Qwen3.8-2.4T-A95B est un modèle de langage causal de pointe développé par Hugging Face. Il fait partie de la famille de modèles ouverts Qwen, reconnue pour ses capacités avancées en codage, travail professionnel, recherche et tâches agentiques à long terme. Basé sur l'architecture de Qwen3.5, Qwen3.8 offre des améliorations substantielles dans la planification autonome et la gestion des retours d'environnement, garantissant l'achèvement fiable des tâches de bout en bout.
Lire la suite
Le modèle dispose d'un total de 2,4 trillions de paramètres avec 95 milliards activés, et prend en charge une longueur de contexte native de 262 144 tokens, extensible jusqu'à 1 010 000 tokens. Il est compatible avec des frameworks d'inférence populaires tels que vLLM, SGLang et TokenSpeed, facilitant son intégration dans des systèmes existants. Qwen3.8 offre également un contrôle de pensée flexible, permettant aux utilisateurs d'ajuster la profondeur de raisonnement et de préserver le contexte historique.
Pour les utilisateurs recherchant une inférence gérée et évolutive sans maintenance d'infrastructure, Qwen Cloud propose un service API officiel. Le modèle prend en charge des ajustements d'effort de raisonnement pour équilibrer précision et rapidité, et la préservation de la pensée est activée par défaut pour des performances optimales. Qwen3.8 est idéal pour des tâches complexes et multi-étapes, conçu pour les mener à bien avec une plus grande fiabilité.
Les résultats des benchmarks montrent que Qwen3.8-Max surpasse les versions précédentes et les modèles concurrents dans diverses tâches de codage et d'agent général. Il est recommandé d'utiliser les dernières versions des frameworks pour des performances et une compatibilité optimales. Qwen3.8 est un outil puissant pour les développeurs et chercheurs cherchant à tirer parti des capacités avancées des modèles de langage dans leurs projets.
- CatégorieModèles d'IA et LLM
- DéploiementCloud
- PlateformesWeb
Points forts de Qwen3.8-2.4T-A95B
Modèle de Langage Causal
2.4T Paramètres
95B Paramètres Activés
Longueur de Contexte jusqu'à 1 010 000 Tokens
Contrôle de Pensée Flexible
Ajustement de l'Effort de Raisonnement
Préserver le Contexte Historique
API Disponible via Qwen Cloud
Premiers pas avec Qwen3.8-2.4T-A95B
Accéder à la page du modèle : Visitez le dépôt Qwen de Hugging Face
Authentifier : Assurez-vous que la clé API et l'URL de base sont configurées
Configurer : Définissez les paramètres d'échantillonnage pour des performances optimales
Envoyer des invites : Utilisez une entrée uniquement textuelle avec le mode de pensée activé
Ajuster : Modifiez la profondeur de raisonnement en utilisant l'effort_de_raisonnement
Cas d'utilisation de Qwen3.8-2.4T-A95B
- Tâches de Codage
- Travail Professionnel
- Projets de Recherche
- Tâches à Long Terme
- Intégration API