Descripción
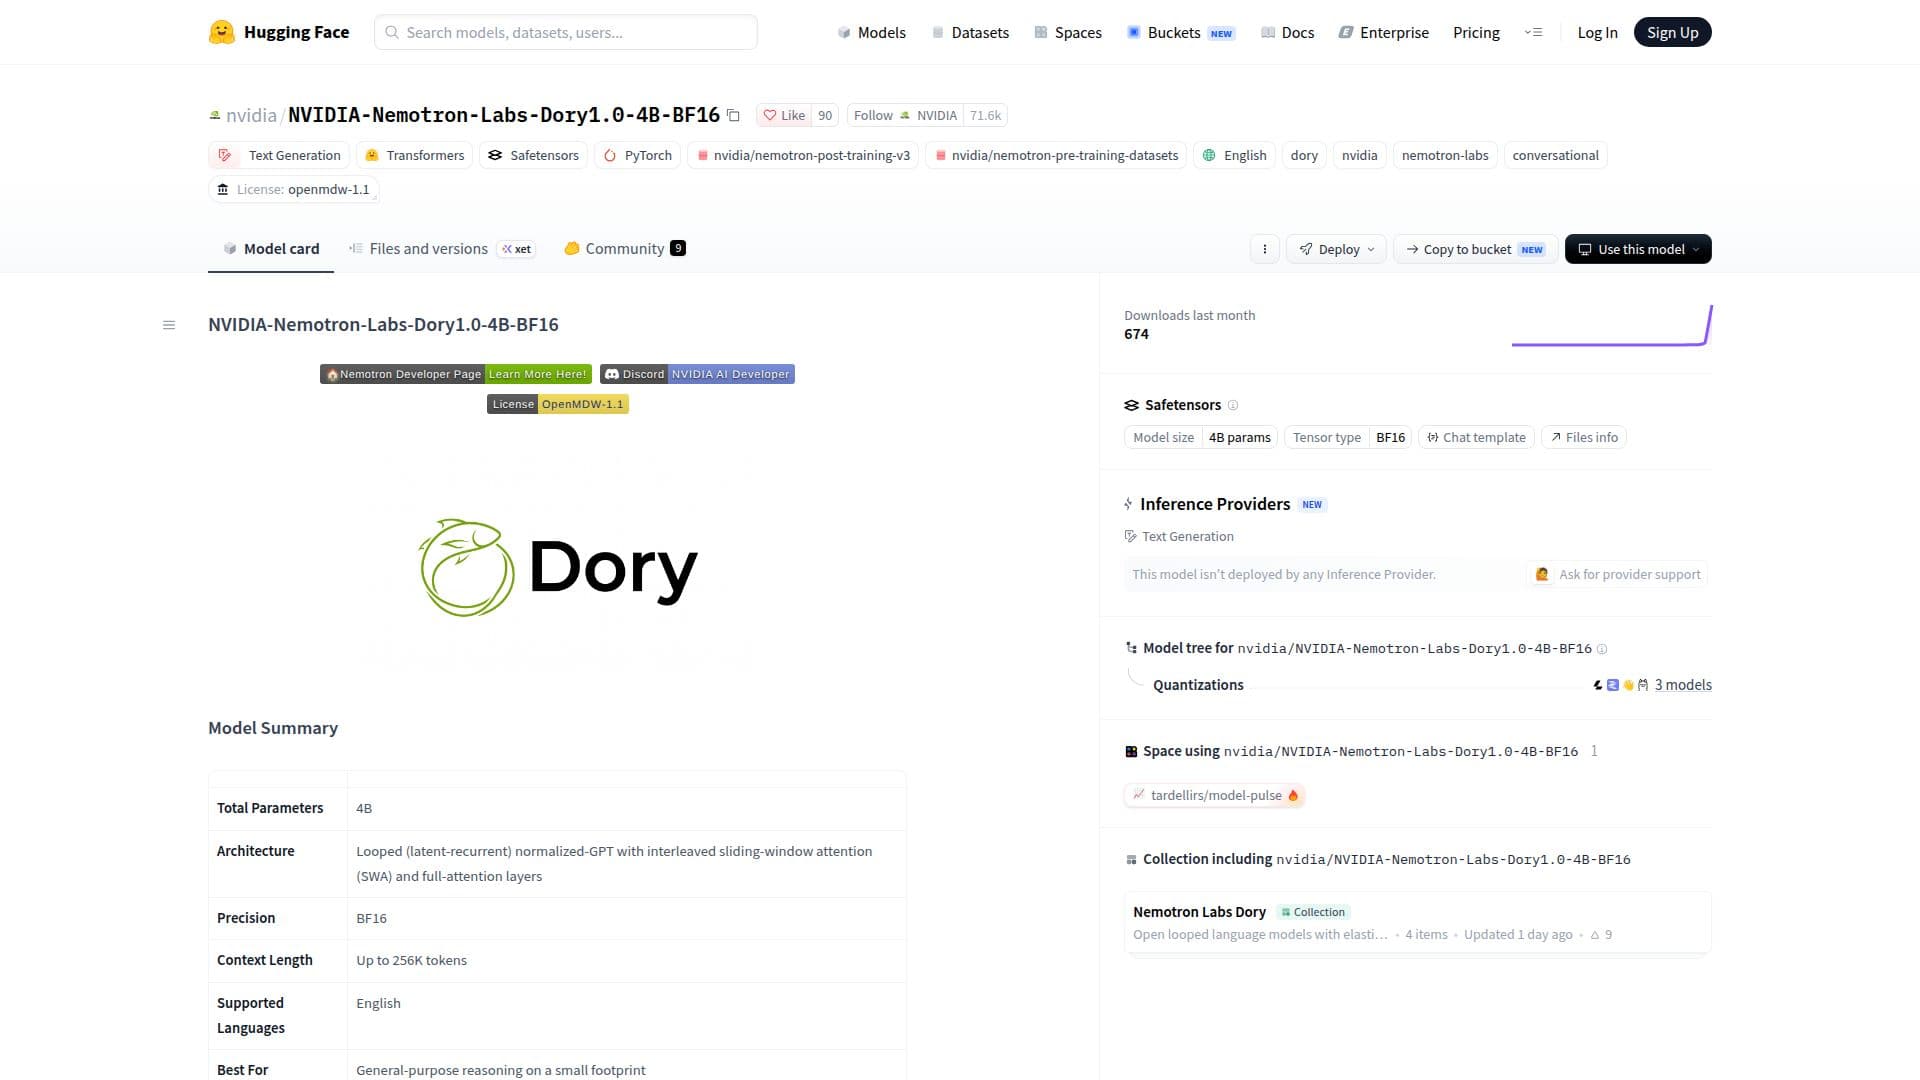
NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16 es un modelo de lenguaje grande desarrollado por NVIDIA, utilizando una arquitectura normalizada-GPT en bucle (latente-recurrente). Este modelo está diseñado para manejar tareas de razonamiento de propósito general mientras mantiene una pequeña huella computacional. Presenta atención de ventana deslizante entrelazada (SWA) y capas de atención completa, lo que le permite procesar eficientemente hasta 256K tokens en longitud de contexto.
Leer más
El modelo está construido con 4 mil millones de parámetros y emplea precisión BF16, lo que lo hace adecuado tanto para aplicaciones comerciales como no comerciales. Soporta el procesamiento del idioma inglés y es más adecuado para tareas que requieren capacidades de razonamiento general. La arquitectura del modelo permite un cómputo de inferencia elástico, lo que permite a los usuarios ajustar el número de bucles para equilibrar entre eficiencia computacional y precisión sin necesidad de reentrenamiento.
Dory1.0-4B-BF16 se preentrena utilizando el formato NVFP4 de NVIDIA antes de continuar en BF16, asegurando un alto rendimiento en sistemas acelerados por GPU de NVIDIA. Está disponible en múltiples formatos, incluyendo BF16, MXFP8, NVFP4 y Q5_K_M, proporcionando flexibilidad en el despliegue a través de diferentes configuraciones de hardware.
El entrenamiento del modelo involucró 6 billones de tokens, con un enfoque en dominios diversos como matemáticas, ciencia y conocimiento general. Pasó por un ajuste fino supervisado y aprendizaje por refuerzo para mejorar su rendimiento en el uso de herramientas de múltiples pasos, seguimiento de instrucciones y entornos de salida estructurada. Los benchmarks del modelo demuestran un rendimiento competitivo en varias tareas, incluyendo codificación, razonamiento y seguimiento de instrucciones.
NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16 está regido por el Acuerdo de Licencia OpenMDW, versión 1.1, y fue lanzado el 16 de octubre de 2026. Está diseñado para funcionar de manera óptima en las arquitecturas Hopper y Blackwell de NVIDIA, con soporte para sistemas operativos Linux.
- CategoríaModelos de IA y LLM
- Modelo de preciosCódigo abierto
- ImplementaciónNube
- PlataformasLinux
Aspectos destacados de NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16
Arquitectura latente-recurrente en bucle
Atención de ventana deslizante entrelazada
Longitud de contexto de 256K tokens
Precisión BF16
Cómputo de inferencia elástico
Pre-entrenamiento nativo NVFP4
Bucle eficiente en memoria
Acuerdo de Licencia OpenMDW
Primeros pasos con NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16
Acceder a la página del modelo: Visite la página del modelo en Hugging Face para NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16.
Autenticarse: Asegúrese de tener las credenciales necesarias para acceder al modelo.
Configurar: Configure los parámetros del modelo, incluyendo el conteo de bucles y la configuración de caché KV.
Enviar solicitudes: Ingrese secuencias de texto al modelo para su procesamiento.
Ajustar: Ajuste la configuración del modelo para tareas específicas si es necesario.
Casos de uso de NVIDIA-Nemotron-Labs-Dory1.0-4B-BF16
- Razonamiento General
- Tareas de Codificación
- Seguimiento de Instrucciones
- Procesamiento de Contexto Largo
- Investigación Científica