Descripción
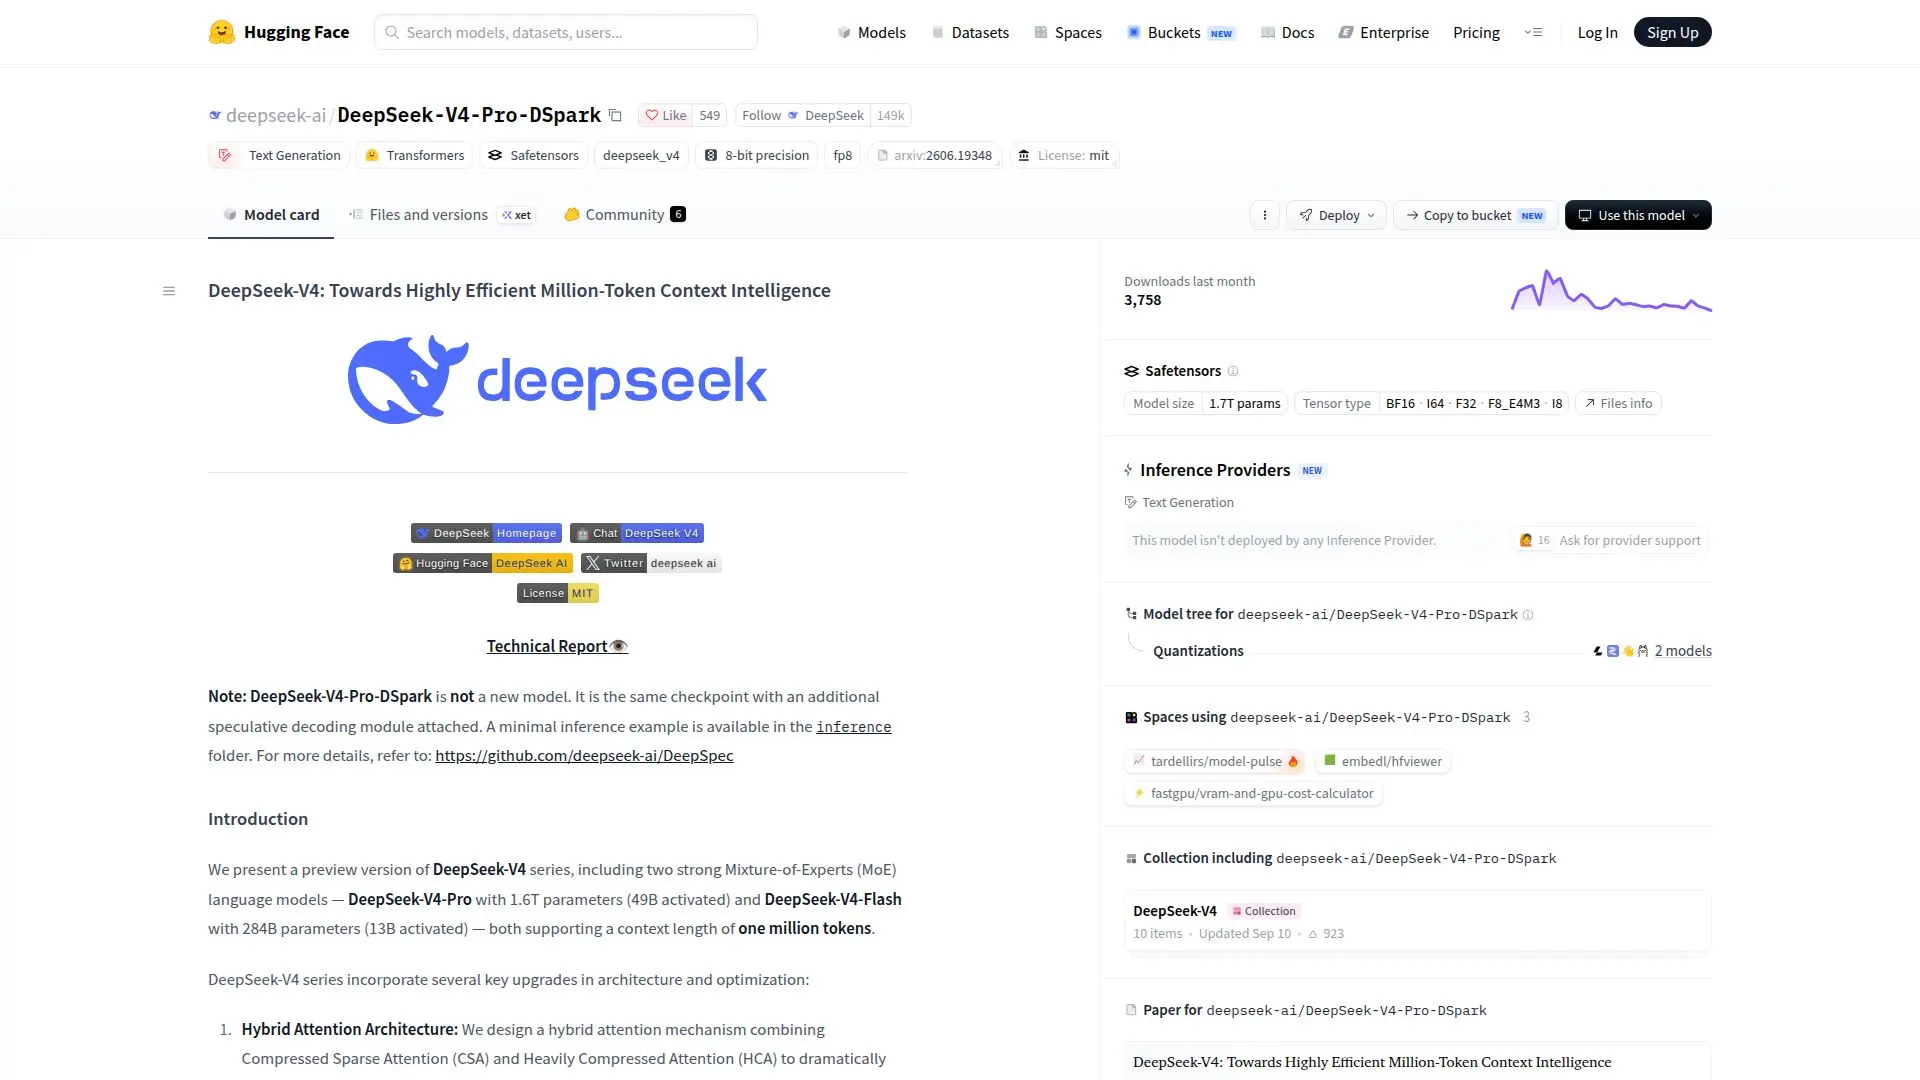
DeepSeek-V4-Pro-DSpark es parte de la serie DeepSeek-V4, que incluye modelos de lenguaje de Mezcla de Expertos (MoE) altamente eficientes. Este modelo está diseñado para manejar longitudes de contexto extensas de hasta un millón de tokens, lo que lo hace adecuado para tareas lingüísticas complejas. La arquitectura de atención híbrida combina Atención Escasa Comprimida (CSA) y Atención Comprimida en Gran Medida (HCA) para mejorar la eficiencia en contextos largos. Además, el modelo incorpora hiperconexiones restringidas por variedades (mHC) para mejorar la estabilidad de la propagación de señales a través de las capas.
Leer más
El modelo DeepSeek-V4-Pro-DSpark está preentrenado en más de 32 billones de tokens diversos y de alta calidad, seguido de un pipeline de post-entrenamiento integral. Este pipeline incluye el cultivo independiente de expertos específicos de dominio a través de ajuste fino supervisado (SFT) y aprendizaje por refuerzo con optimización de políticas guiadas (GRPO), seguido de la consolidación del modelo unificado a través de destilación en política.
DeepSeek-V4-Pro-DSpark sobresale en varios benchmarks, logrando un rendimiento de primer nivel en tareas de codificación y razonamiento. Cierra significativamente la brecha con los modelos cerrados líderes en tareas de razonamiento y agentes. El modelo soporta tres modos de esfuerzo de razonamiento: No pensar, Pensar Alto y Pensar Máximo, atendiendo a diferentes casos de uso desde tareas rutinarias hasta la resolución de problemas complejos.
El modelo está disponible para descarga en plataformas como Hugging Face y ModelScope, y está licenciado bajo la Licencia MIT. Los usuarios pueden ejecutar el modelo localmente con instrucciones detalladas proporcionadas en la carpeta de inferencia, que incluye la conversión de pesos del modelo y demostraciones de chat interactivas.
- CategoríaModelos de IA y LLM
- Modelo de preciosGratis
- ImplementaciónNube, Autoalojado
- PlataformasWeb
Aspectos destacados de DeepSeek-V4-Pro-DSpark
Arquitectura de Atención Híbrida
Hiperconexiones Restringidas por Variedades
Optimizador Muon
Longitud de Contexto de un Millón de Tokens
Modelo de Mezcla de Expertos
Código Abierto
Tres Modos de Esfuerzo de Razonamiento
Pipeline de Post-entrenamiento Integral
Primeros pasos con DeepSeek-V4-Pro-DSpark
Acceder a la página del modelo: Visita la página del modelo en Hugging Face
Autenticarse: Inicia sesión en tu cuenta de Hugging Face
Configurar: Configura el modelo con los parámetros deseados
Enviar indicaciones: Introduce tus indicaciones de texto para su procesamiento
Ajustar: Ajusta la configuración del modelo para tareas específicas
Casos de uso de DeepSeek-V4-Pro-DSpark
- Procesamiento de Contextos Largos
- Resolución de Problemas Complejos
- Tareas Rutinarias
- Benchmarks de Codificación
- Tareas de Razonamiento