Descripción
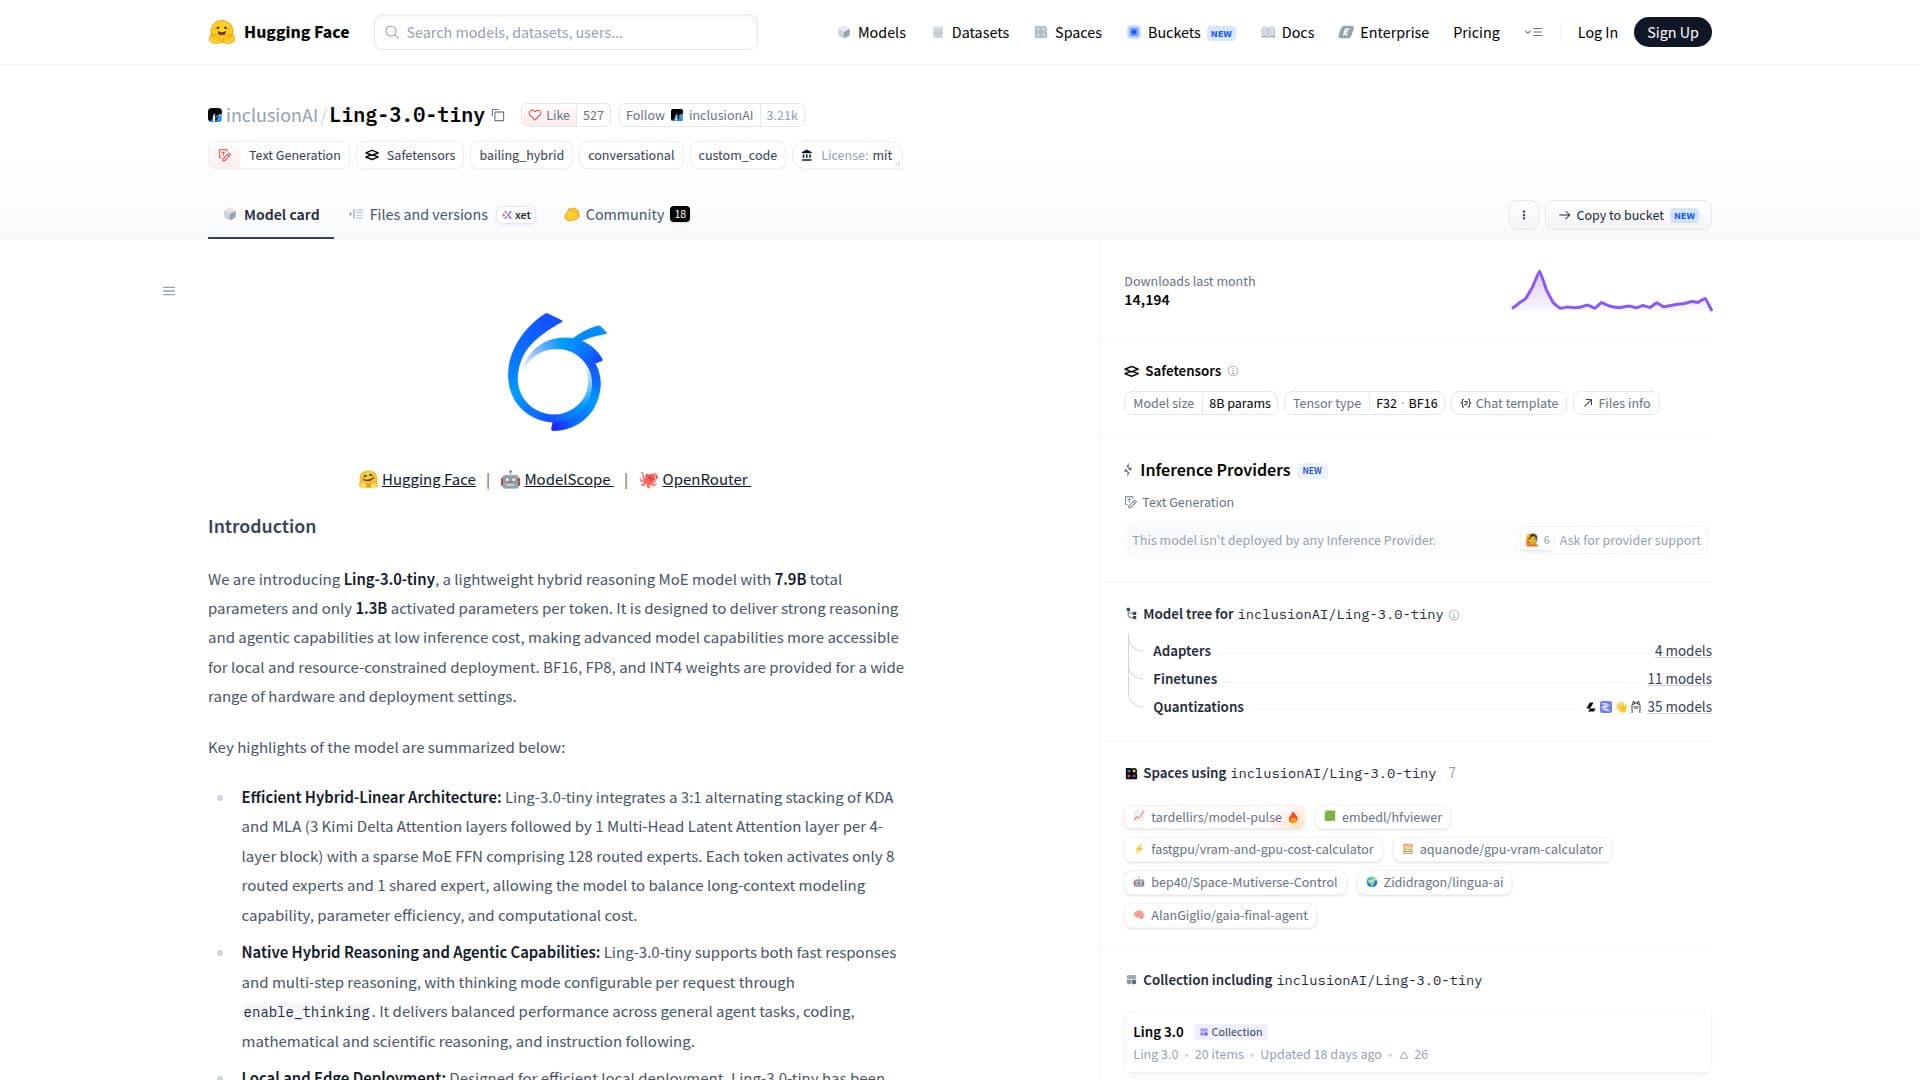
Ling-3.0-tiny es un modelo de razonamiento híbrido ligero desarrollado por inclusionAI, alojado en Hugging Face. Cuenta con un total de 7.9 mil millones de parámetros, con solo 1.3 mil millones activados por token, lo que lo hace eficiente para despliegues locales y con recursos limitados. El modelo integra un apilamiento alternante 3:1 de capas de Kimi Delta Attention (KDA) y Multi-Head Latent Attention (MLA), junto con una red de avance (FFN) de Mezcla de Expertos (MoE) escasa que comprende 128 expertos enrutados. Esta arquitectura permite al modelo equilibrar la capacidad de modelado de contexto largo, la eficiencia de parámetros y el costo computacional.
Leer más
Ling-3.0-tiny está diseñado para ofrecer fuertes capacidades de razonamiento y agentic a un bajo costo de inferencia. Soporta tanto respuestas rápidas como razonamiento en múltiples pasos, con un modo de pensamiento configurable. El modelo ha sido validado en diversos hardware, incluyendo NVIDIA DGX Spark y Apple Silicon MacBook, permitiendo razonamientos capaces y cargas de trabajo agentic sin necesidad de GPUs de clase datacenter. Con FP8, logra alrededor de 100-105 tokens por segundo en DGX Spark y 86-90 tokens por segundo en un MacBook M4 Pro, con aproximadamente 8.34 GiB de uso máximo de memoria a una longitud de contexto de 8K.
La eficiencia del modelo se destaca por su rendimiento en el Índice de Inteligencia de Análisis Artificial v4.1.1, con una puntuación de 25, y en el Índice Agentic de Análisis Artificial, con una puntuación de 16. Alcanzando una velocidad de salida de más de 160 tokens por segundo, con aproximadamente 18 segundos de latencia de extremo a extremo para una respuesta de 500 tokens. Ling-3.0-tiny es adecuado para una amplia gama de tareas, incluyendo tareas agentic, codificación, comprensión de contexto largo, fiabilidad del conocimiento, razonamiento matemático y científico, y seguimiento de instrucciones.
- CategoríaModelos de IA y LLM
- Modelo de preciosFreemium
- ImplementaciónSe ejecuta en local
- PlataformasWeb
Aspectos destacados de Ling-3.0-tiny
7.9B parámetros totales
1.3B parámetros activados por token
Capacidades de razonamiento híbrido
Despliegue local eficiente
Arquitectura KDA-MLA 3:1
FFN MoE escasa con 128 expertos
Soporta respuestas rápidas y razonamiento en múltiples pasos
Validado en NVIDIA DGX Spark y Apple Silicon
Primeros pasos con Ling-3.0-tiny
Acceder a la página del modelo: Visitar Hugging Face
Autenticarse: Iniciar sesión en su cuenta
Configurar: Establecer parámetros del modelo
Enviar solicitudes: Usar el modelo para inferencia
Ajustar: Modificar configuraciones para tareas específicas
Casos de uso de Ling-3.0-tiny
- Tareas Agentic
- Codificación
- Razonamiento Científico
- Seguimiento de Instrucciones
- Despliegue Local