

Descripción
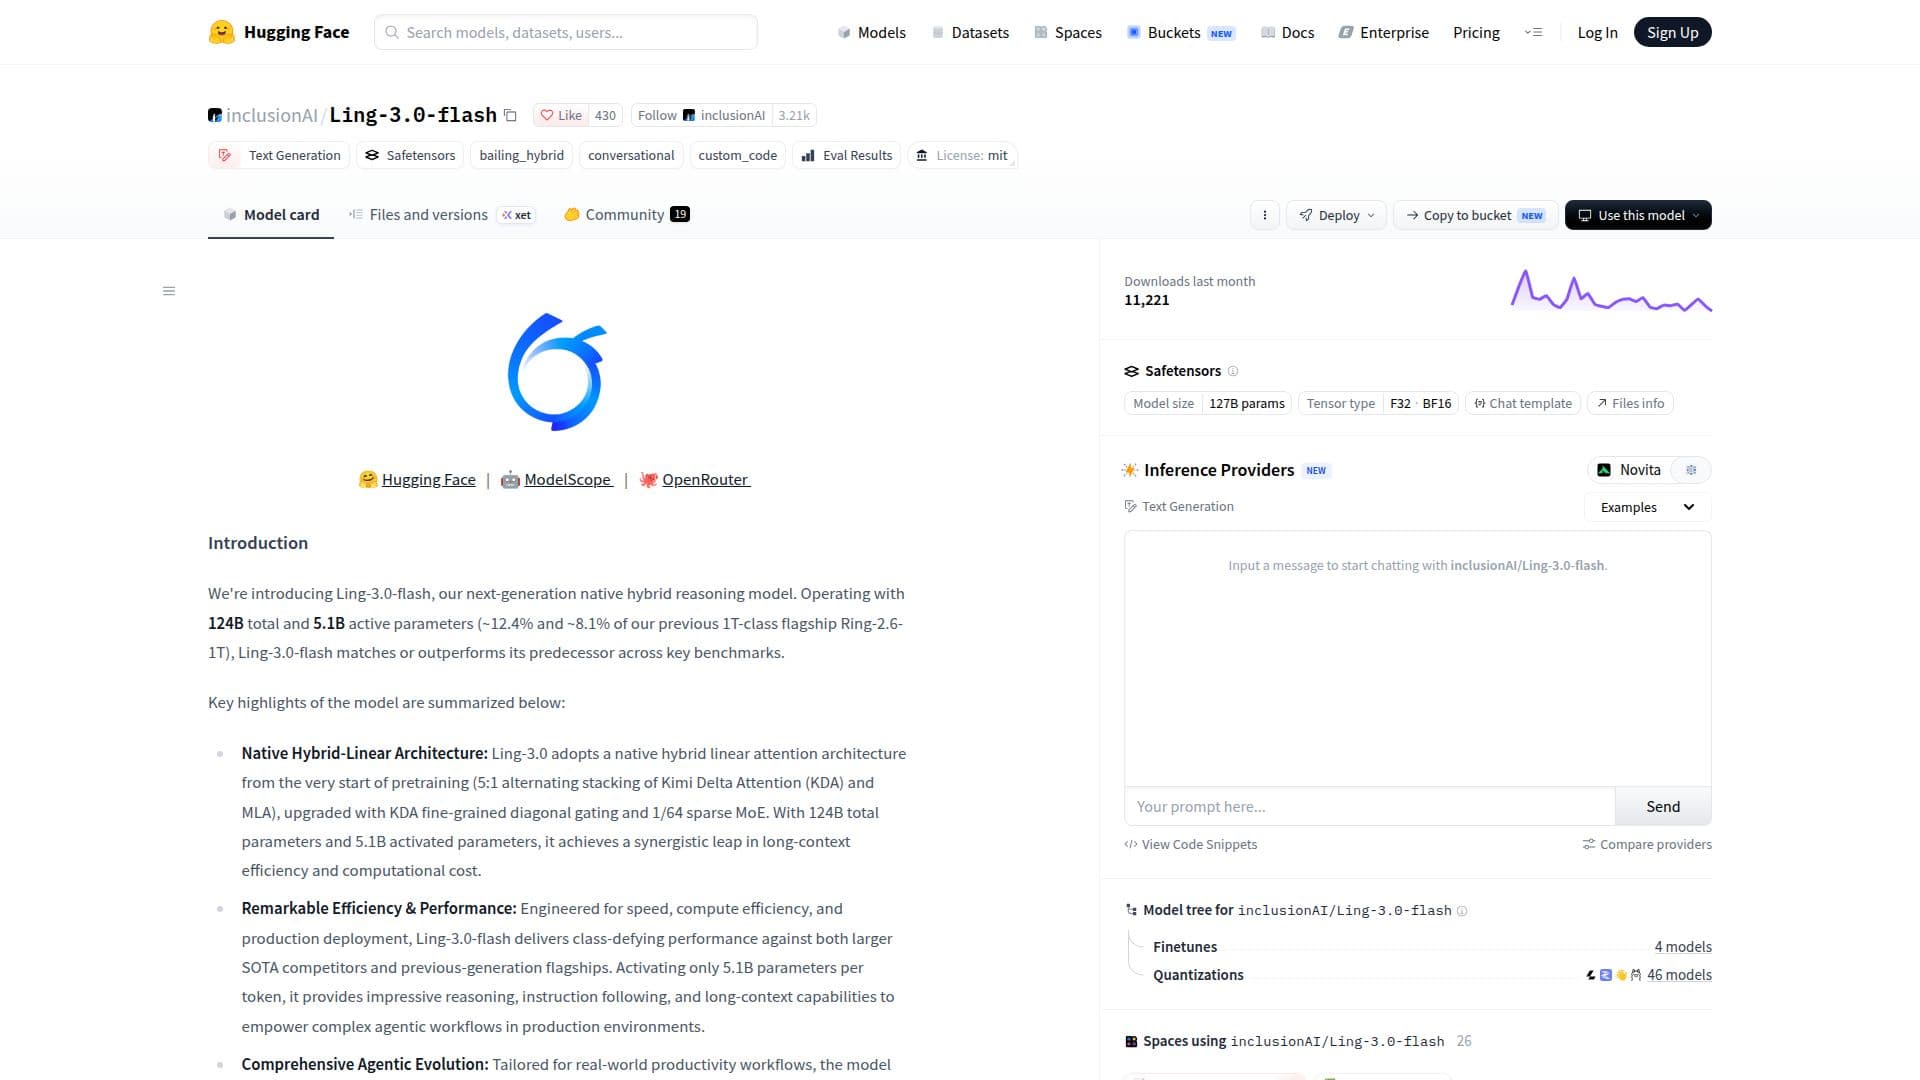
Ling-3.0-flash es un modelo de razonamiento híbrido de vanguardia desarrollado por inclusionAI y alojado en Hugging Face. Opera con un total de 124 mil millones de parámetros, con 5.1 mil millones activados por token, proporcionando una eficiencia y rendimiento notables. El modelo adopta una arquitectura de atención lineal híbrida nativa, con Kimi Delta Attention (KDA) y MLA, mejorada con un control diagonal de alta precisión y MoE disperso. Esta arquitectura permite que Ling-3.0-flash logre un salto sinérgico en la eficiencia de contextos largos y el costo computacional.
Leer más
Diseñado para velocidad y eficiencia computacional, Ling-3.0-flash ofrece un rendimiento que desafía las clases frente a competidores más grandes de última generación y buques insignia de generaciones anteriores. Potencia flujos de trabajo complejos en entornos de producción, activando solo 5.1 mil millones de parámetros por token. El modelo incorpora más de 10,000 entornos de entrenamiento interactivos para lograr una ejecución de bucle cerrado de extremo a extremo en tareas de codificación, generales y de investigación profunda.
Ling-3.0-flash integra la arquitectura de caché jerárquica SGLang HiCache + Mooncake, que presenta grupos duales físicos y una caché L3 compartida por clúster. Esta configuración elimina la recomputación redundante durante interacciones de largo horizonte, reduciendo el Tiempo hasta el Primer Token (TTFT) en un 60% a más del 80% en escenarios de entrada larga. El modelo se desempeña de manera sólida en múltiples benchmarks autorizados, incluidos SWE-Bench Pro, SWE-Bench Multilingual, Tau3-banking-AA, MCP-Atlas y SkillsBench.
El modelo está diseñado para flujos de trabajo de productividad en el mundo real, ofreciendo un rendimiento sólido en conocimiento general, razonamiento matemático, seguimiento de instrucciones y comprensión de contextos largos. Ling-3.0-flash está diseñado para implementación en producción, ofreciendo capacidades de razonamiento impresionantes y eficiencia en contextos largos, lo que lo hace adecuado para flujos de trabajo complejos.
- CategoríaModelos de IA y LLM
- Modelo de preciosFreemium
- ImplementaciónNube
- PlataformasWeb
Aspectos destacados de Ling-3.0-flash
Arquitectura Híbrida-Lineal Nativa
Eficiencia y Rendimiento Notables
Evolución Agente Integral
Caché SGLang HiCache + Mooncake
Ejecución de Bucle Cerrado de Extremo a Extremo
Eficiencia en Contextos Largos
Seguimiento de Instrucciones
Razonamiento Matemático
Primeros pasos con Ling-3.0-flash
Acceder a la página del modelo: Visitar Hugging Face
Autenticarse: Iniciar sesión en su cuenta
Configurar: Establecer parámetros y preferencias
Enviar solicitudes: Ingresar sus consultas
Ajustar: Modificar la configuración del modelo
Casos de uso de Ling-3.0-flash
- Tareas de Codificación
- Agentes de Investigación
- Seguimiento de Instrucciones
- Comprensión de Contextos Largos
- Razonamiento Matemático







