Beschreibung
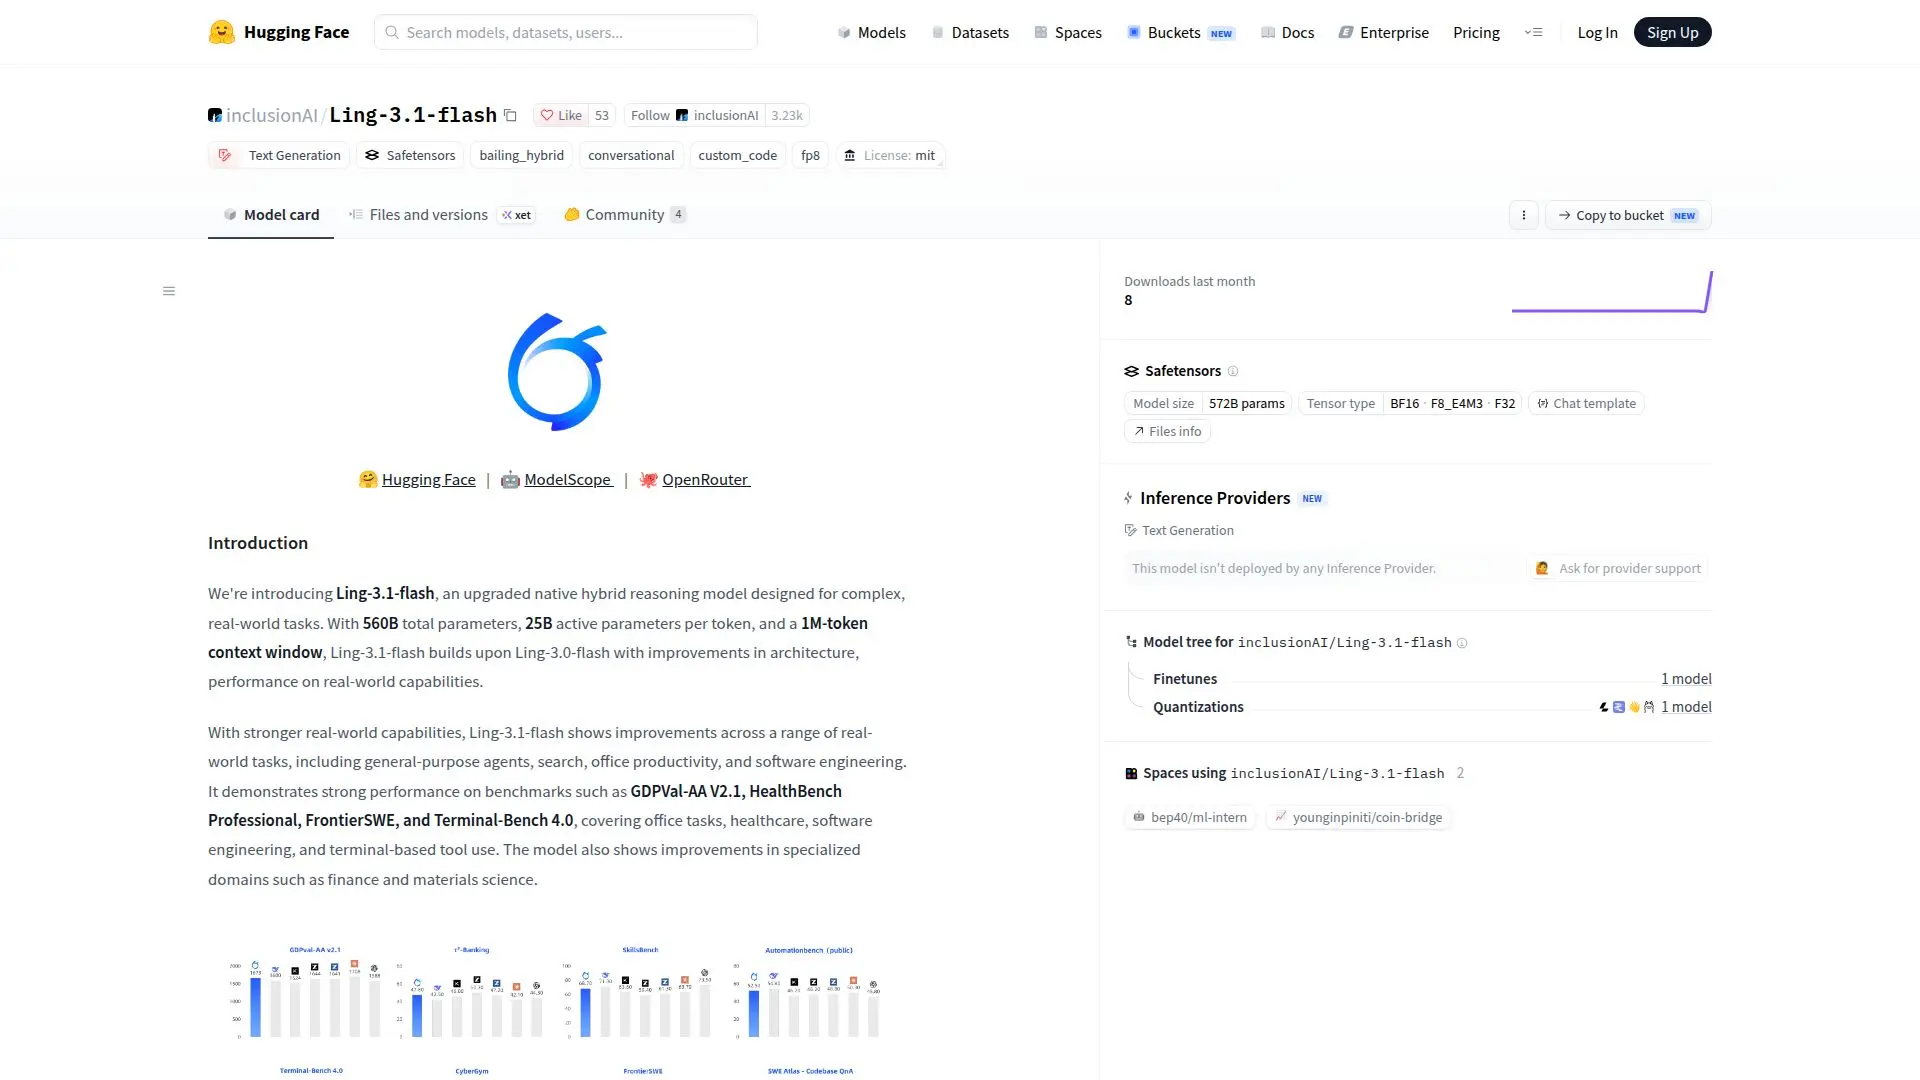
Ling-3.1-flash ist ein verbessertes natives hybrides Denkmodell, das von inclusionAI auf der Hugging Face-Plattform eingeführt wurde. Es wurde entwickelt, um komplexe, reale Aufgaben zu bewältigen, und verfügt über insgesamt 560 Milliarden Parameter, mit 25 Milliarden aktiven Parametern pro Token und einem Kontextfenster von 1 Million Token. Diese Verbesserungen bauen auf seinem Vorgänger, Ling-3.0-flash, auf und bieten eine verbesserte Architektur und Leistung.
Weiterlesen
Das Modell glänzt in einer Vielzahl von realen Anwendungen, wie z.B. allgemeinen Agenten, Suche, Büroproduktivität und Softwareentwicklung. Es hat starke Leistungen in Benchmarks wie GDPVal-AA V2.1, HealthBench Professional, FrontierSWE und Terminal-Bench 4.0 gezeigt. Diese Benchmarks decken ein breites Spektrum an Aufgaben ab, einschließlich Büroaufgaben, Gesundheitswesen, Softwareentwicklung und terminalbasierte Werkzeugnutzung. Darüber hinaus zeigt Ling-3.1-flash bemerkenswerte Verbesserungen in spezialisierten Bereichen wie Finanzen und Materialwissenschaften.
Die Architektur von Ling-3.1-flash basiert auf einem hybriden linearen Mischmodell von Experten (MoE), das 63 KDA- und 9 Gated MLA-Transformator-Schichten, 4 dichte Schichten und 512 geroutete Experten umfasst. Das Modell beinhaltet auch 64 Aufmerksamkeitsköpfe und eine versteckte Größe von 4096, mit einer Wortschatzgröße von 157.184.
Ling-3.1-flash wurde in mehreren autoritativen Benchmarks bewertet und zeigt starke Leistungen in Programmier- und agentischen Aufgaben. Es unterstützt Frameworks wie Claude Code, Kilo Code, Qwen Code, Hermes Agent und OpenClaw. Das Modell führt auch LingCode ein, ein Werkzeug, das auf dem Open-Source-Coding-Agenten Pi basiert und die Leistung bei komplexen, langfristigen Programmieraufgaben verbessert.
Für Benutzer, die anfangen möchten, enthält das empfohlene SGLang-Image Unterstützung für Ling-3.1-flash, MTP spekulative Dekodierung und Hopper-Dekodierungsoptimierungen. Das Modell ist für Inferenz auf verschiedenen Serverkonfigurationen verfügbar, und verifizierte Rezepte werden für unterschiedliche Hardware-Setups bereitgestellt.
- KategorieKI-Modelle & LLMs
- PreismodellOpen Source
- BereitstellungCloud
- PlattformenWeb
Ling-3.1-flash im Überblick
560B Gesamtparameter
1M-Token Kontextfenster
Hybride lineare MoE-Architektur
63 KDA + 9 Gated MLA-Schichten
512 geroutete Experten
64 Aufmerksamkeitsköpfe
Unterstützt mehrere Frameworks
Starke Benchmark-Leistung
Erste Schritte mit Ling-3.1-flash
Zugriff auf die Modellseite: Besuchen Sie Hugging Face
Authentifizieren: Melden Sie sich bei Ihrem Konto an
Konfigurieren: Richten Sie die Server- oder Client-Umgebung ein
Eingabeaufforderungen senden: Verwenden Sie verifizierte Rezepte für die Inferenz
Ling-3.1-flash's Anwendungsfälle
- Allzweck-Agenten
- Büroproduktivität
- Softwareentwicklung
- Gesundheitsanwendungen
- Finanzanalyse