Beschreibung
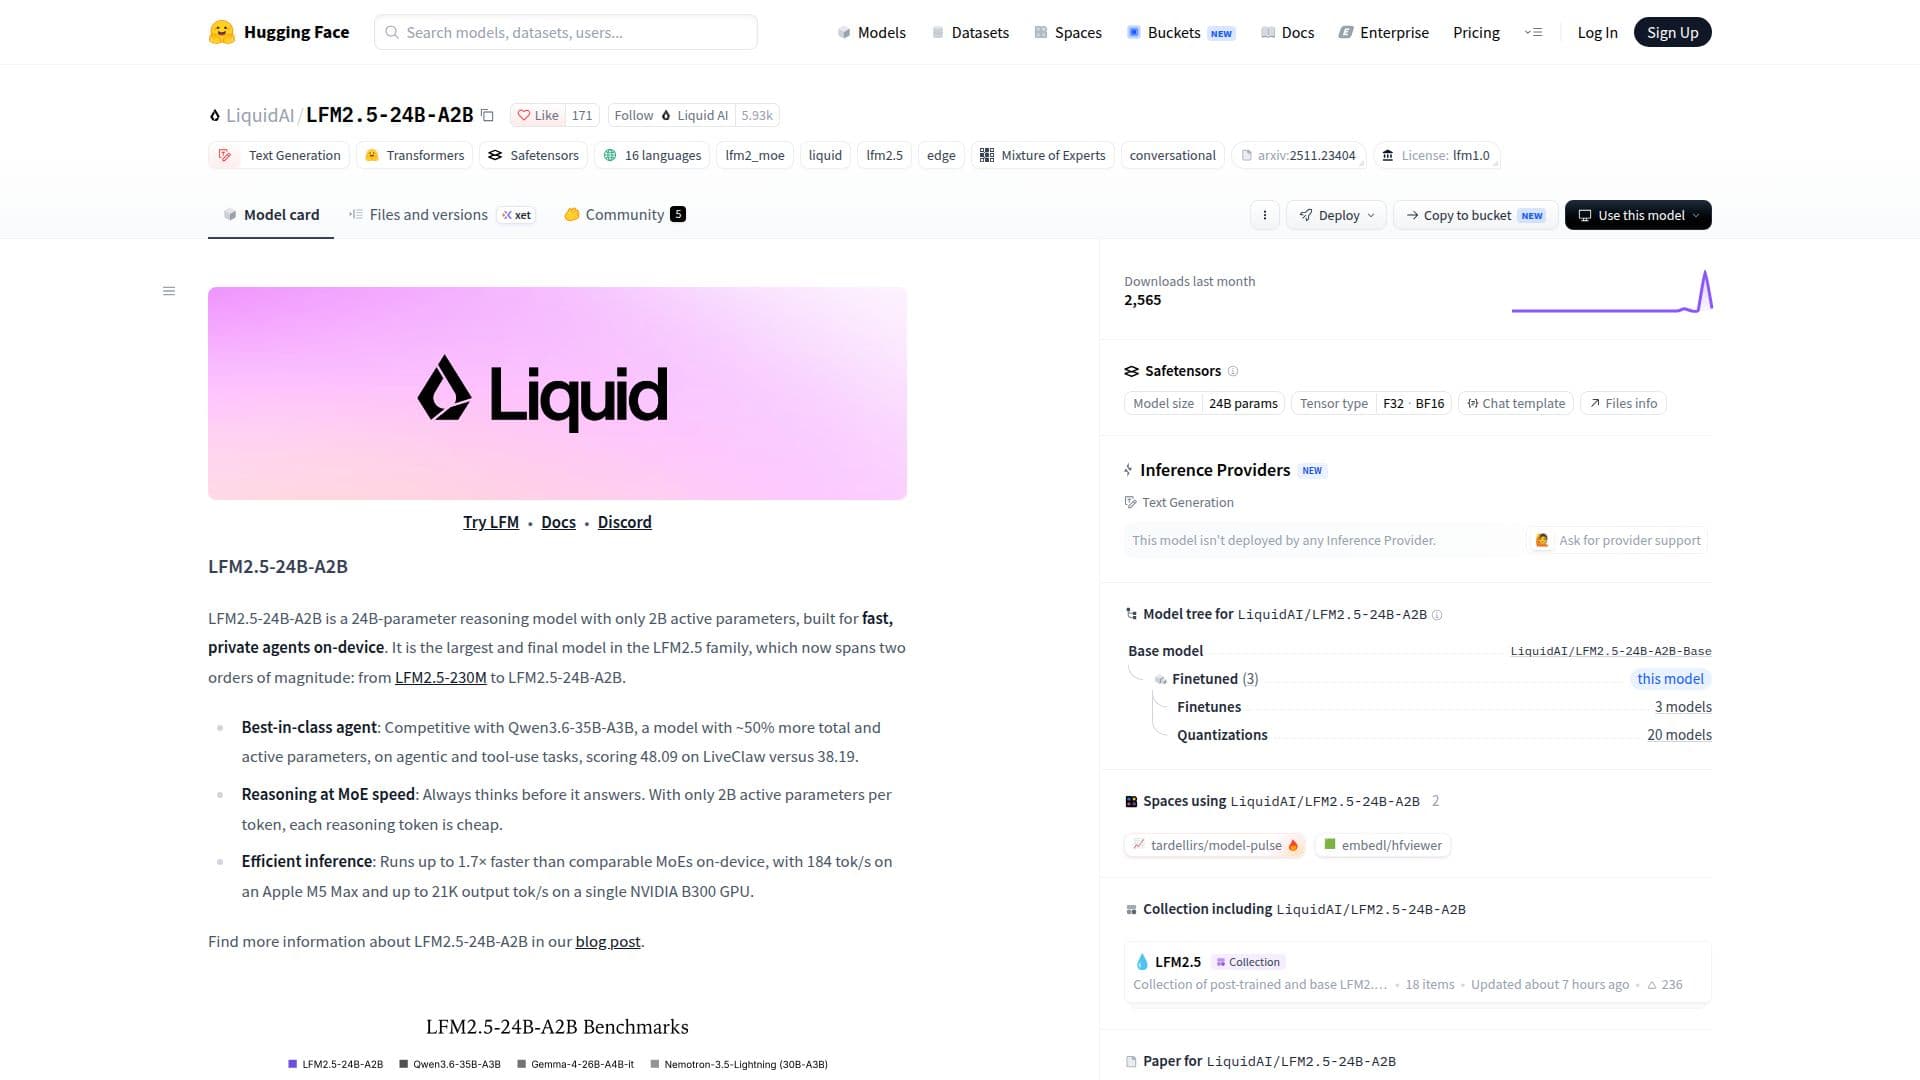
LiquidAI LFM2.5-24B-A2B ist ein hochmodernes Reasoning-Modell, das darauf ausgelegt ist, effizient mit nur 2B aktiven Parametern von insgesamt 24B zu arbeiten. Dieses Modell gehört zur LFM2.5-Familie und ist für schnelle, private On-Device-Anwendungen maßgeschneidert. Es glänzt in agentischen und werkzeugbasierten Aufgaben und zeigt eine wettbewerbsfähige Leistung im Vergleich zu größeren Modellen wie Qwen3.6-35B-A3B.
Weiterlesen
Das Modell ist für effiziente Inferenz konzipiert und läuft bis zu 1,7-mal schneller als vergleichbare Modelle auf Geräten wie dem Apple M5 Max und der NVIDIA B300 GPU. Es unterstützt eine breite Palette von Sprachen, darunter Englisch, Arabisch, Chinesisch und mehr, was es vielseitig für mehrsprachige Anwendungen macht.
LFM2.5-24B-A2B ist in verschiedenen Formaten erhältlich, darunter FP8 für hochdurchsatzfähige GPU-Bereitstellung, GGUF für CPU-Inferenz und ONNX für plattformübergreifende Bereitstellung. Diese Flexibilität ermöglicht die Integration in unterschiedliche Umgebungen, von Cloud über Edge bis hin zu Mobilgeräten.
Das Modell eignet sich besonders für Anwendungen, die Reasoning- und Werkzeugaufruf-Funktionen erfordern. Es unterstützt den Funktionsaufruf in einem strukturierten vierstufigen Prozess, was seine Nützlichkeit in agentischen Workflows erhöht. Es wird jedoch nicht empfohlen, es für wissensintensive Aufgaben ohne ergänzende Abruf- oder Websuchfunktionen zu verwenden.
Für Entwickler bietet LFM2.5-24B-A2B umfangreiche Optionen zur Feinabstimmung, einschließlich überwachter Feinabstimmung und direkter Präferenzoptimierung mit Frameworks wie Unsloth und TRL. Die Leistung des Modells wurde in verschiedenen Aufgaben benchmarked und zeigt durchgehend hohe Effizienz und Geschwindigkeit.
Insgesamt ist LiquidAI LFM2.5-24B-A2B eine robuste Wahl für Entwickler, die ein leistungsstarkes, effizientes Reasoning-Modell für On-Device-Anwendungen suchen.
- KategorieKI-Modelle & LLMs
- PreismodellOpen Source
- BereitstellungCloud, On-Premises
- PlattformenWeb, Windows, macOS
LiquidAI LFM2.5-24B-A2B im Überblick
24B Gesamtparameter
2B aktive Parameter
Effiziente On-Device-Inferenz
Unterstützt mehrere Sprachen
Werkzeugaufruf-Funktionen
Verfügbar in mehreren Formaten
Unterstützung für Feinabstimmung
Hochgeschwindigkeits-GPU-Inferenz
Erste Schritte mit LiquidAI LFM2.5-24B-A2B
Zugriff auf die Modellseite: Besuchen Sie die Hugging Face Modellseite
Authentifizieren: Melden Sie sich bei Ihrem Hugging Face-Konto an
Konfigurieren: Richten Sie das Modell für Ihren spezifischen Anwendungsfall ein
Eingabeaufforderungen senden: Verwenden Sie das Modell für Reasoning-Aufgaben
Feinabstimmen: Passen Sie das Modell mit Ihren Daten an
LiquidAI LFM2.5-24B-A2B's Anwendungsfälle
- Mehrsprachige Unterstützung
- On-Device-Agenten
- Werkzeugaufruf-Workflows
- Plattformübergreifende Bereitstellung
- Feinabstimmungsanwendungen