Описание
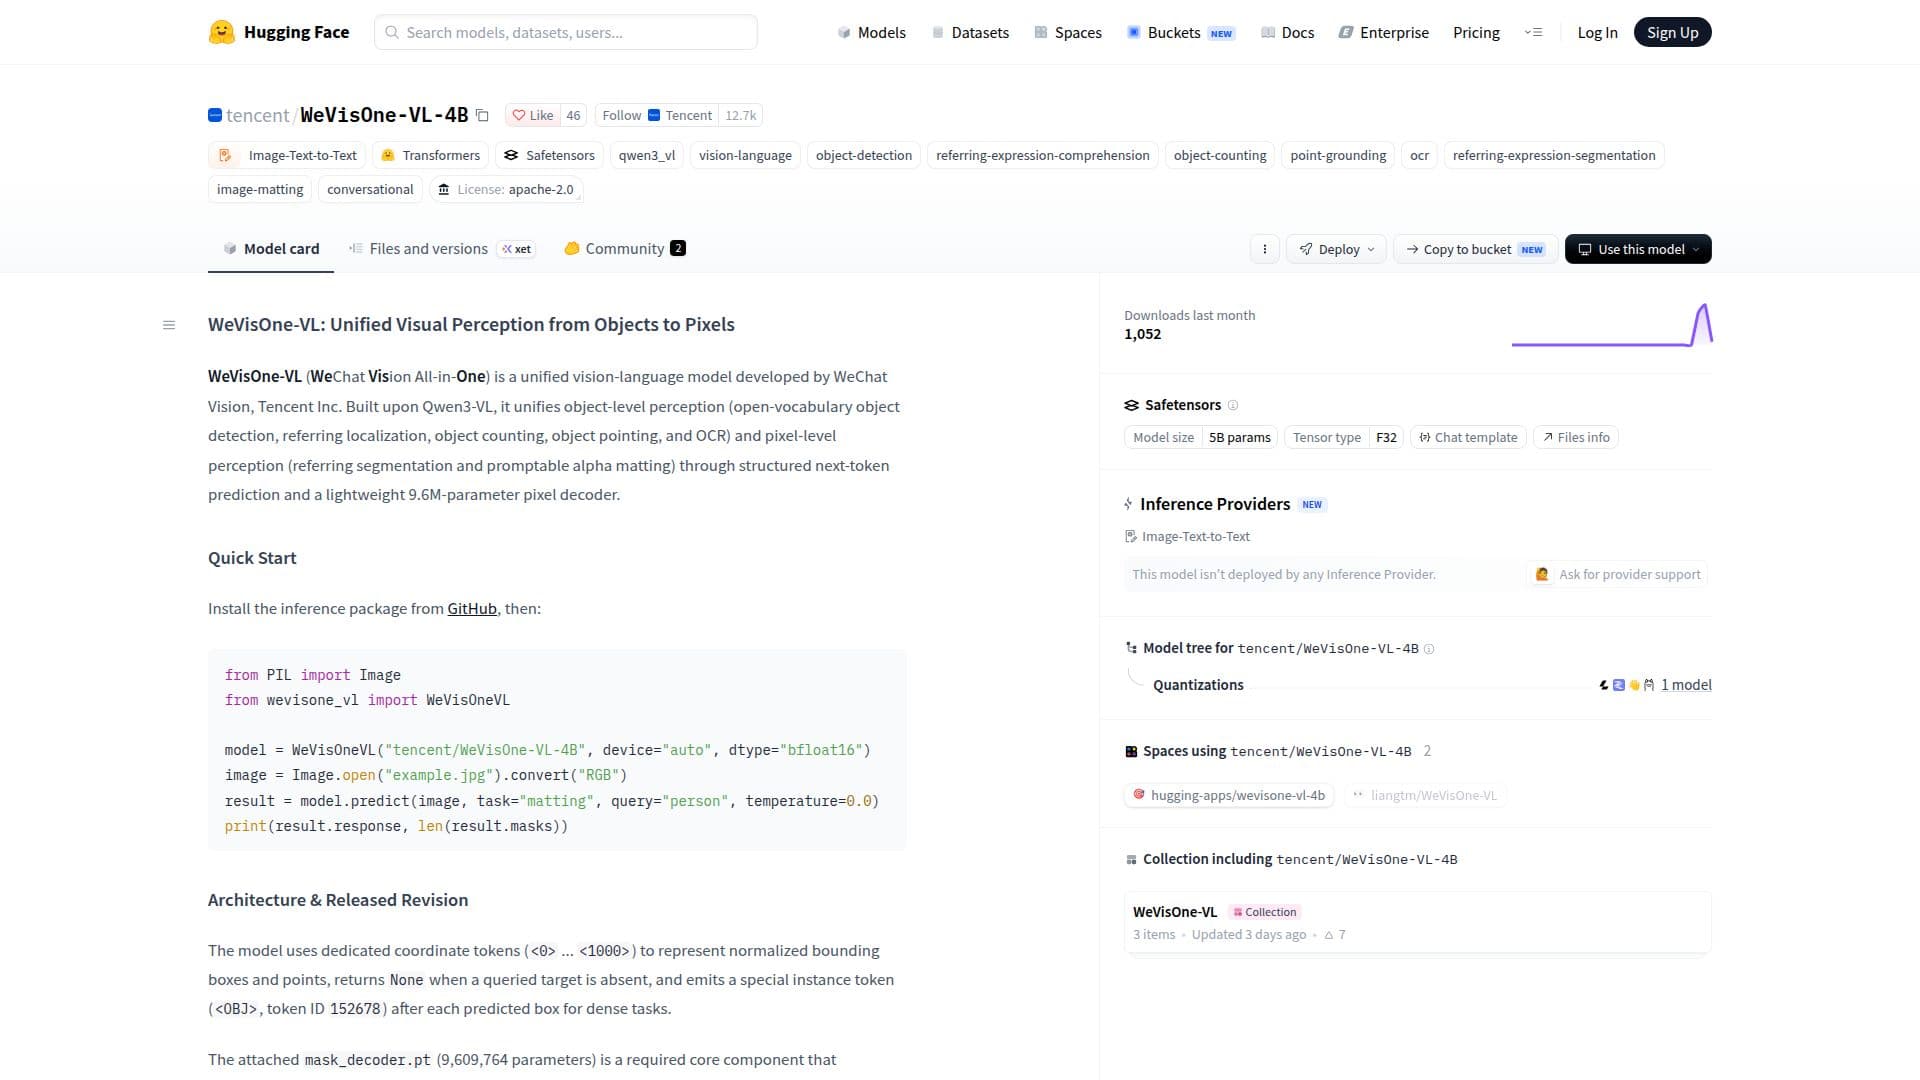
WeVisOne-VL — это модель визуального языка, разработанная WeChat Vision, частью компании Tencent Inc. Она предназначена для объединения задач восприятия на уровне объектов и пикселей. Построенная на основе фреймворка Qwen3-VL, WeVisOne-VL поддерживает ряд визуальных задач, включая обнаружение объектов с открытым словарем, локализацию по ссылкам, подсчет объектов, указание объектов и оптическое распознавание символов (OCR). Кроме того, она обрабатывает задачи на уровне пикселей, такие как сегментация по ссылкам и матирование с возможностью задания. Модель использует структурированное предсказание следующего токена и включает легковесный декодер пикселей с 9,6 миллиона параметров.
Читать далее
Архитектура WeVisOne-VL включает специальные токены координат для представления нормализованных ограничивающих рамок и точек. Она использует специальный токен экземпляра для плотных задач и интегрирует декодер масок как основной компонент. Этот декодер сочетает в себе адаптер визуальных признаков, декодер запросов с направляющими рамками и голову плотного предсказания, зависящую от экземпляра, для уточнения предсказаний и вывода альфа-матов в полном разрешении.
WeVisOne-VL предназначена для исследовательских целей в области визуального закрепления, локализации по ссылкам, указания, подсчета, локализации OCR, сегментации по ссылкам и матирования изображений. Она не предназначена для автономного принятия решений с высоким воздействием или индивидуальной идентификации. Модель эффективна в генерации структурированных выходных данных, но не поддерживает явное рассуждение и в настоящее время ограничена восприятием изображений в одном цикле.
Модель выпущена под лицензией Apache 2.0, при этом компоненты третьих сторон сохраняют свои оригинальные лицензии. Она была загружена более 1000 раз за последний месяц, что свидетельствует о растущей популярности в исследовательском сообществе.
- КатегорияИИ-модели и LLM
- Модель ценообразованияБесплатно
- РазвёртываниеОблако
- ПлатформыВеб
Главное о WeVisOne-VL
Унифицированная модель визуального языка
Восприятие на уровне объектов
Восприятие на уровне пикселей
Декодер пикселей с 9,6 миллиона параметров
Структурированное предсказание следующего токена
Специальные токены координат
Специальный токен экземпляра для плотных задач
Лицензия Apache 2.0
Начало работы с WeVisOne-VL
Доступ к странице модели: посетите страницу WeVisOne-VL на Hugging Face
Аутентификация: убедитесь, что у вас есть необходимые разрешения для доступа к модели
Настройка: настройте параметры модели в соответствии с вашими исследовательскими потребностями
Отправка запросов: введите ваши визуальные задачи для обработки
Тонкая настройка: при необходимости отрегулируйте модель для конкретных задач
Варианты использования WeVisOne-VL
- Обнаружение объектов
- Локализация по ссылкам
- Подсчет объектов
- Локализация OCR
- Матирование изображений