Перейти к основному содержимому
ToolPotion
ИИ-советник
Отправить

WeVisOne-VL

WeVisOne-VL — это унифицированная модель визуального языка, разработанная WeChat Vision, Tencent Inc. Она интегрирует восприятие на уровне объектов и пикселей для задач, таких как обнаружение объектов и матирование изображений, и предназначена для исследовательских целей.

Посетить URL
Поделиться
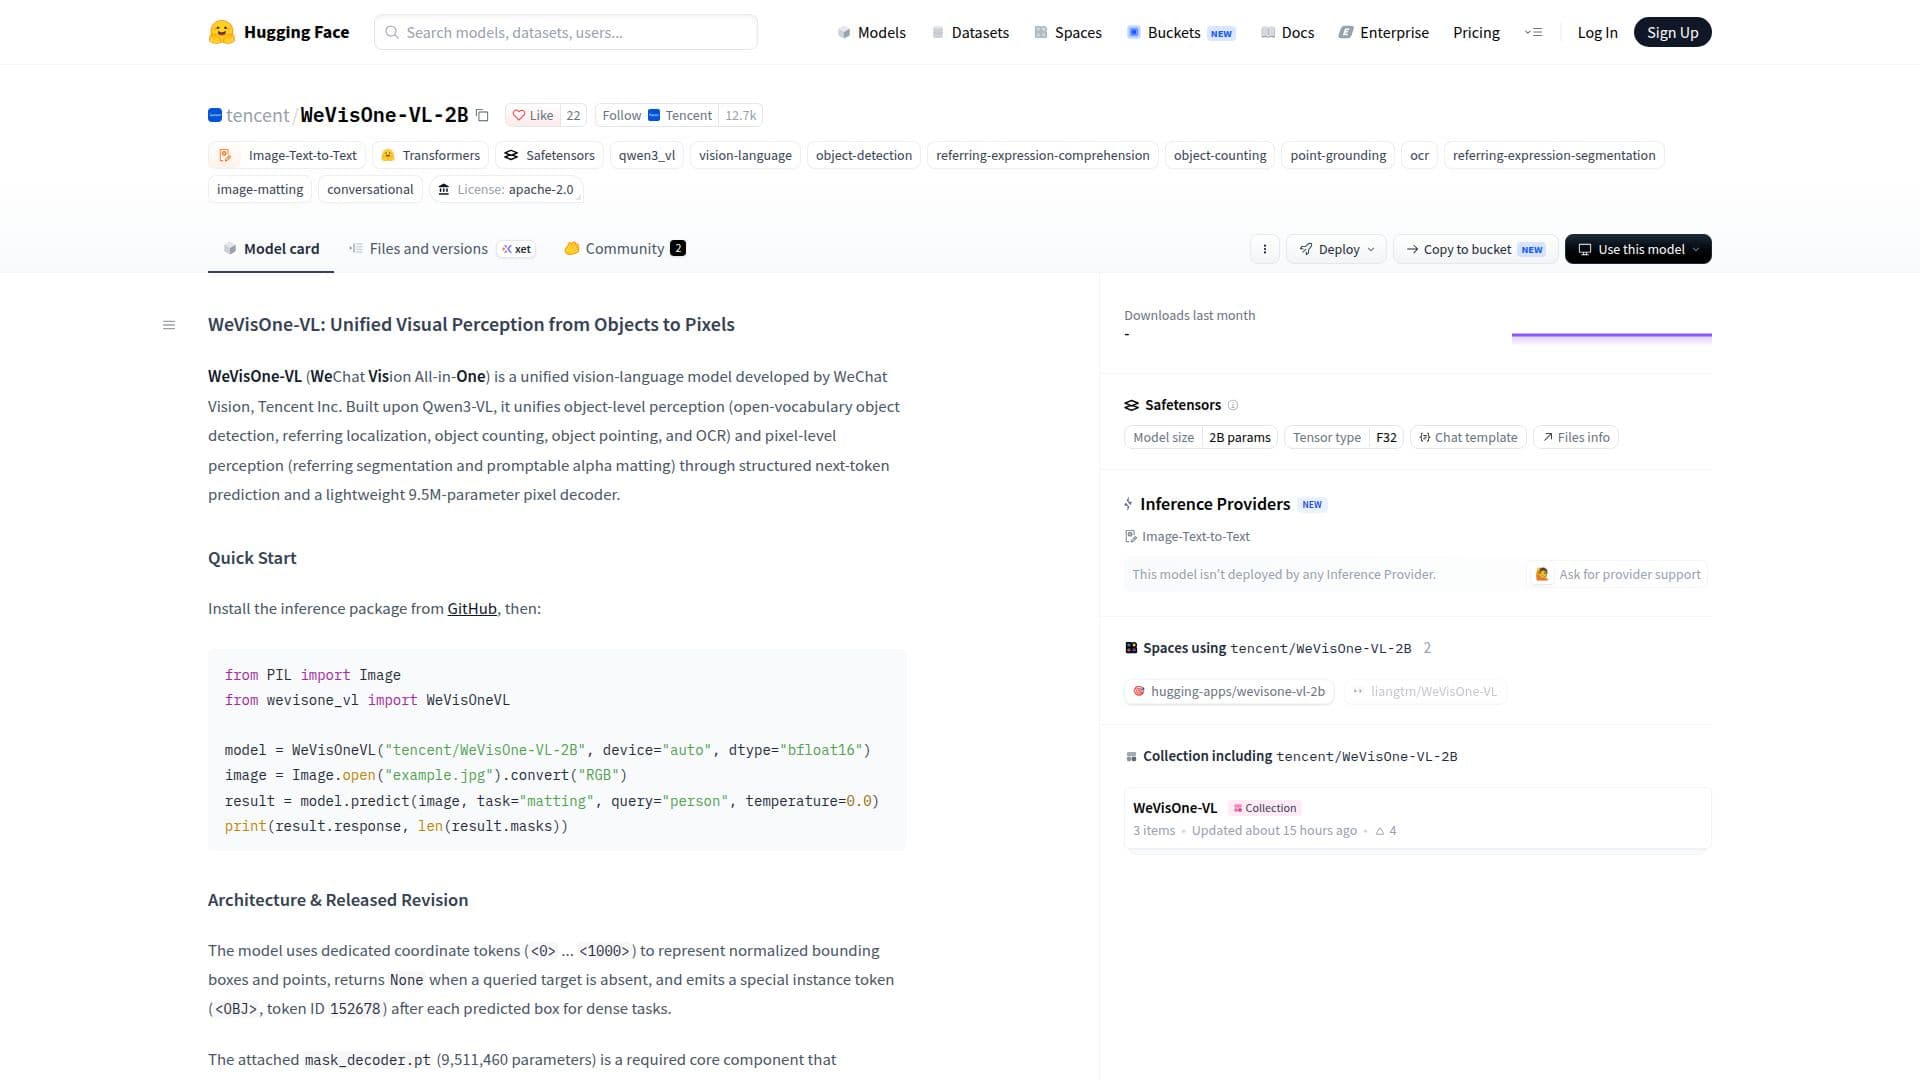
Скриншот WeVisOne-VL

WeVisOne-VL — это сложная модель визуального языка, разработанная WeChat Vision, подразделением Tencent Inc. Эта модель основана на фреймворке Qwen3-VL и предназначена для объединения задач восприятия на уровне объектов и пикселей. Она способна обрабатывать обнаружение объектов с открытым словарем, локализацию по ссылке, подсчет объектов, указание объектов и оптическое распознавание символов (OCR).

Читать далее

Кроме того, она поддерживает задачи на уровне пикселей, такие как сегментация по ссылке и матирование альфа-канала по запросу.

Модель использует структурированное предсказание следующего токена и имеет легковесный декодер пикселей с 9,5 миллиона параметров. Ключевым компонентом WeVisOne-VL является mask_decoder.pt, который интегрирует адаптер визуальных признаков, декодер запросов с направляющей рамкой и голову плотного предсказания, зависящую от экземпляра. Эти компоненты работают вместе, чтобы уточнять предсказания и выводить альфа-каналы высокого разрешения.

WeVisOne-VL предназначена для исследовательских приложений в области визуального закрепления, локализации, указания, подсчета, OCR, сегментации и матирования изображений. Она не предназначена для автономного принятия решений или индивидуальной идентификации. Модель оптимизирована для восприятия изображений в одном цикле и не поддерживает видеосетки.

Модель выпущена под лицензией Apache 2.0, при этом сторонние компоненты сохраняют свои оригинальные лицензии. Пользователям рекомендуется ознакомиться с исходными файлами для получения конкретных деталей лицензирования.

  • КатегорияИнструменты компьютерного зрения
  • Модель ценообразованияОткрытый код
  • РазвёртываниеОблако
  • ПлатформыВеб

  • Унифицированная модель визуального языка

  • Восприятие на уровне объектов

  • Восприятие на уровне пикселей

  • Обнаружение объектов с открытым словарем

  • Сегментация по ссылке

  • Матирование альфа-канала по запросу

  • Структурированное предсказание следующего токена

  • Легковесный декодер пикселей

  1. Доступ к странице модели: посетите страницу модели Hugging Face

  2. Аутентификация: войдите в свою учетную запись Hugging Face

  3. Настройка: настройте модель с необходимыми параметрами

  4. Отправка запросов: введите ваши визуальные данные для обработки

  5. Тонкая настройка: настройте параметры модели для конкретных задач

  • Визуальное закрепление
  • Обнаружение объектов
  • Матирование изображений
  • Локализация OCR
  • Сегментация по ссылке

Популярные ИИ-инструменты, похожие на WeVisOne-VL

Qwen2-VL-7B-Instruct

AI-модели

Qwen2-VL-7B-Instruct — это продвинутая модель ИИ, разработанная для визуального понимания и многоязычной поддержки. Она превосходно обрабатывает изображения и видео, демонстрируя…

Инструменты компьютерного зрения
Открыть инструмент

AI-модели

Продвинутая модель ИИ, разработанная для визуального понимания и многоязычной поддержки. Она превосходно обрабатывает изображения и видео, демонстрируя…Qwen2-VL-7B-Instruct — это продвинутая модель ИИ, разработанная для визуального понимания и многоязычной поддержки. Она превосходно обрабатывает изображения и видео, демонстрируя…

Инструменты компьютерного зрения
Топ-5: AI-модели

CLIP ViT-B/32

AI-модели

Модель clip-vit-base-patch32 от OpenAI предназначена для задач классификации изображений без предварительного обучения. Она использует архитектуру Vision Transformer для повышения…

Инструменты компьютерного зрения
Открыть инструмент

AI-модели

Модель clip-vit-base-patch32 от OpenAI предназначена для задач классификации изображений без предварительного обучения. Она использует архитектуру Vision Transformer для повышения…

РекомендованоИнструменты компьютерного зрения
Топ-5: AI-модели

Florence-2 — это продвинутая модель визуального фундамента от Microsoft, предназначенная для выполнения различных задач в области визуального восприятия и языка. Она использует…

ИИ-модели и LLM
Открыть инструмент

Florence-2 — это продвинутая модель визуального фундамента от Microsoft, предназначенная для выполнения различных задач в области визуального восприятия и языка. Она использует…

ИИ-модели и LLM
Топ-5: AI-модели

Qwen-VL

AI-репозитории на GitHub

Qwen-VL — это крупная языковая модель с визуальными возможностями, разработанная Alibaba Cloud. Она предлагает продвинутые возможности для задач общения и визуализации,…

ИИ-модели и LLM
Открыть инструмент

AI-репозитории на GitHub

Крупная языковая модель с визуальными возможностями, разработанная Alibaba Cloud. Она предлагает продвинутые возможности для задач общения и визуализации,…Qwen-VL — это крупная языковая модель с визуальными возможностями, разработанная Alibaba Cloud. Она предлагает продвинутые возможности для задач общения и визуализации,…

ИИ-модели и LLM
Топ-250: AI-репозитории на GitHub

Инструментарий компьютерного зрения предоставляет алгоритмы и приложения для проектирования и тестирования систем компьютерного зрения, включая визуальный контроль, обнаружение…

Инструменты компьютерного зрения
Открыть инструмент

Предоставляет алгоритмы и приложения для проектирования и тестирования систем компьютерного зрения, включая визуальный контроль, обнаружение…Инструментарий компьютерного зрения предоставляет алгоритмы и приложения для проектирования и тестирования систем компьютерного зрения, включая визуальный контроль, обнаружение…

Инструменты компьютерного зрения
Топ-250: AI-приложения

Ultralytics YOLO

AI-репозитории на GitHub

Ultralytics YOLO включает YOLO26, YOLO11 и YOLOv8, предоставляя возможности для обнаружения объектов, сегментации экземпляров, семантической сегментации, классификации…

Инструменты компьютерного зрения

№18 в AI-репозитории на GitHub

Открыть инструмент

AI-репозитории на GitHub

Ultralytics YOLO включает YOLO26, YOLO11 и YOLOv8, предоставляя возможности для обнаружения объектов, сегментации экземпляров, семантической сегментации, классификации…

РекомендованоИнструменты компьютерного зрения
№18 в AI-репозитории на GitHub

Qwen2-VL-72B-Instruct

AI-модели

Qwen2-VL-72B-Instruct — это продвинутая модель ИИ, разработанная для достижения передового визуального понимания и многоязычной поддержки. Она превосходно обрабатывает…

ИИ-модели и LLM
Открыть инструмент

AI-модели

Продвинутая модель ИИ, разработанная для достижения передового визуального понимания и многоязычной поддержки. Она превосходно обрабатывает…Qwen2-VL-72B-Instruct — это продвинутая модель ИИ, разработанная для достижения передового визуального понимания и многоязычной поддержки. Она превосходно обрабатывает…

ИИ-модели и LLM
Топ-5: AI-модели

Ultralytics

AI-приложения

Платформа компьютерного зрения полного цикла для аннотирования данных, обучения моделей YOLO и их глобального развертывания, основанная на широко используемом открытом фреймворке…

Инструменты компьютерного зренияПроизводство и промышленность

№6 в Производство и промышленность

Открыть инструмент

AI-приложения

Платформа компьютерного зрения полного цикла для аннотирования данных, обучения моделей YOLO и их глобального развертывания, основанная на широко используемом открытом фреймворке…

РекомендованоИнструменты компьютерного зренияПроизводство и промышленность
№6 в Производство и промышленность
1 из 8