Pular para o conteúdo principal
ToolPotion
Consultor de IA
Enviar

WeVisOne-VL

WeVisOne-VL é um modelo unificado de visão-linguagem desenvolvido pela WeChat Vision da Tencent. Ele integra percepção em nível de objeto e pixel para tarefas como detecção de objetos e matização de imagens, utilizando um decodificador de pixel leve.

Visitar URL
Compartilhar
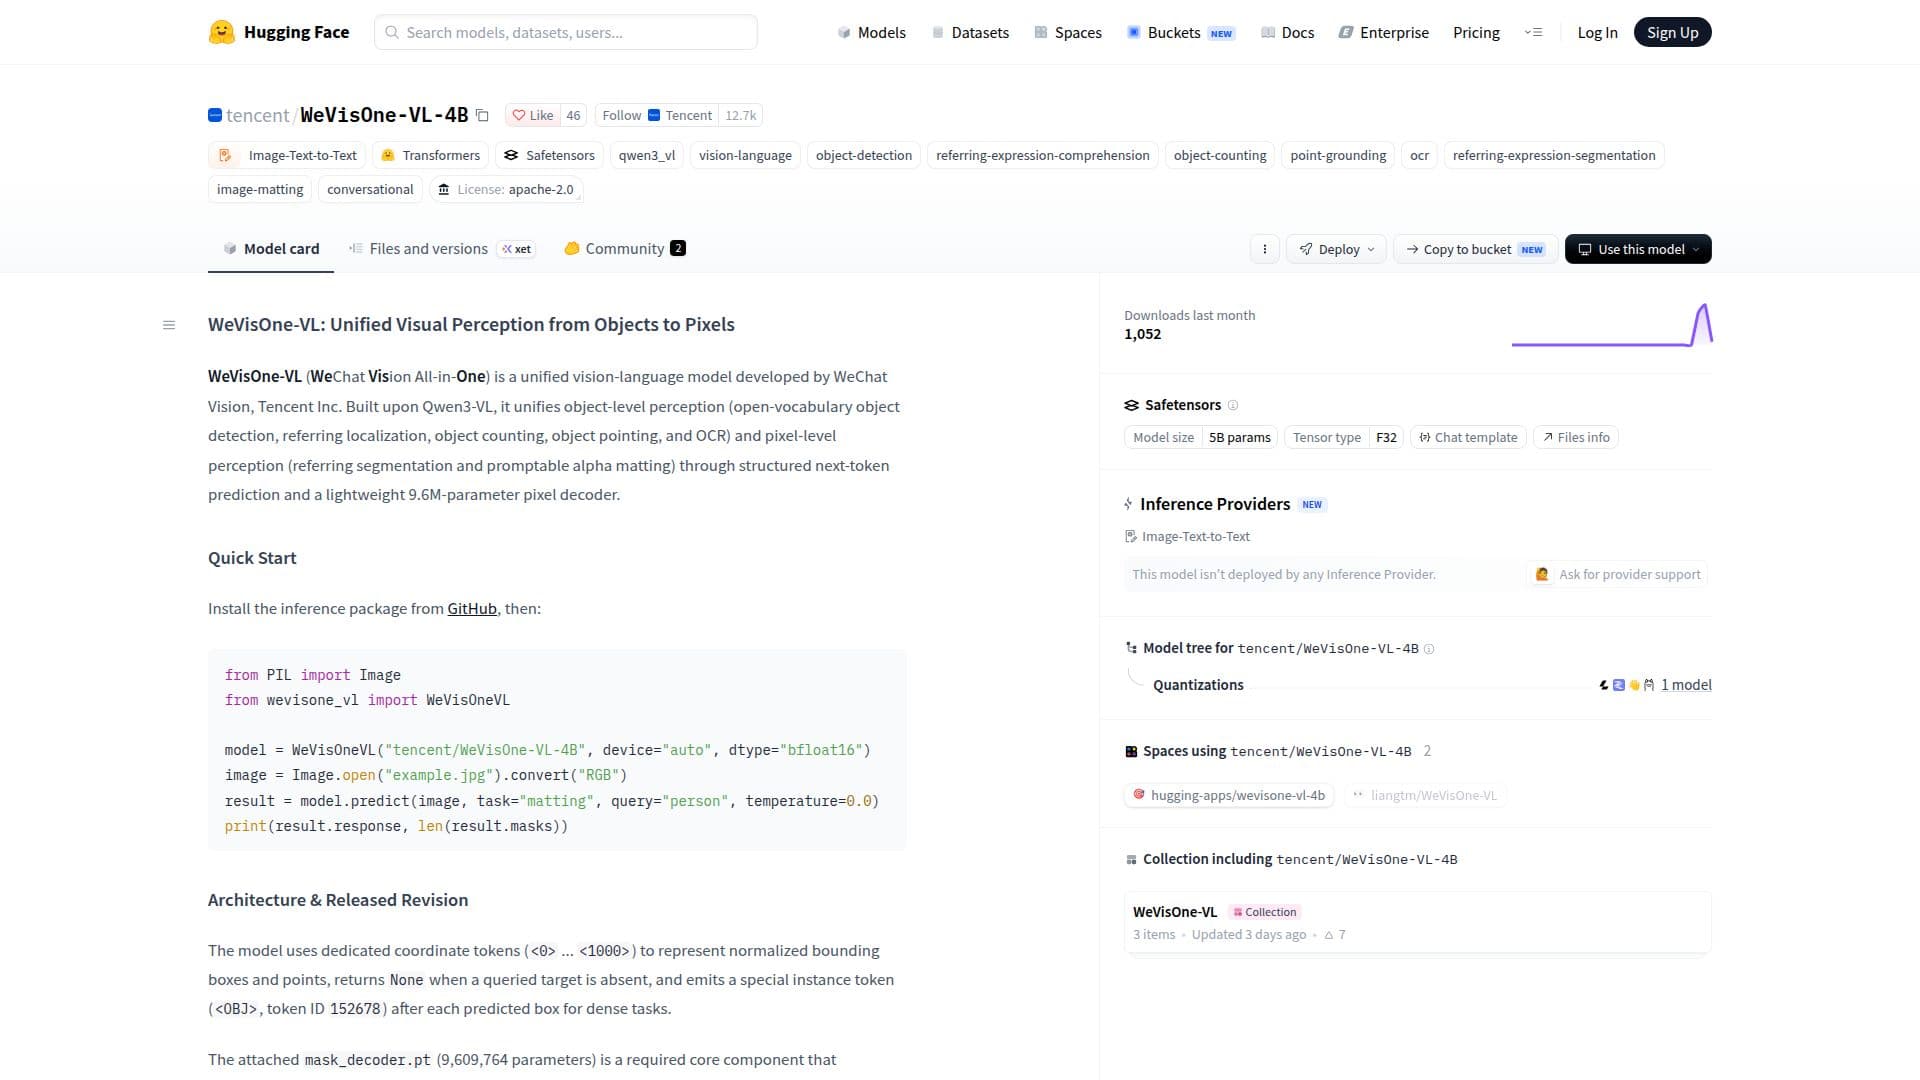
Captura de tela do WeVisOne-VL

WeVisOne-VL é um modelo de visão-linguagem desenvolvido pela WeChat Vision, parte da Tencent Inc. Ele foi projetado para unificar tarefas de percepção em nível de objeto e pixel. Baseado na estrutura Qwen3-VL, o WeVisOne-VL suporta uma variedade de tarefas visuais, incluindo detecção de objetos com vocabulário aberto, localização referencial, contagem de objetos, apontamento de objetos e reconhecimento óptico de caracteres (OCR). Além disso, ele lida com tarefas em nível de pixel, como segmentação referencial e matização alfa acionável. O modelo emprega previsão estruturada do próximo token e possui um decodificador de pixel leve com 9,6 milhões de parâmetros.

Ler mais

A arquitetura do WeVisOne-VL inclui tokens de coordenadas dedicados para representar caixas delimitadoras normalizadas e pontos. Ele utiliza um token de instância especial para tarefas densas e integra um decodificador de máscara como componente central. Este decodificador combina um Adaptador de Recursos Visuais, um Decodificador de Consulta Guiada por Caixa e uma Cabeça de Predição Densa Condicionada por Instância para refinar previsões e gerar matizes alfa em resolução total.

O WeVisOne-VL é destinado a fins de pesquisa em ancoragem visual, localização referencial, apontamento, contagem, localização OCR, segmentação referencial e matização de imagens. Não é projetado para tomada de decisão autônoma de alto impacto ou identificação individual. O modelo é eficiente na geração de saídas estruturadas, mas não suporta raciocínio explícito em cadeia e atualmente está limitado à percepção de imagem em uma única interação.

O modelo é lançado sob a Licença Apache 2.0, com componentes de terceiros mantendo suas licenças originais. Ele foi baixado mais de 1.000 vezes no último mês, indicando sua crescente popularidade na comunidade de pesquisa.

  • CategoriaModelos de IA e LLMs
  • Modelo de preçosGrátis
  • ImplantaçãoNuvem
  • PlataformasWeb

  • Modelo unificado de visão-linguagem

  • Percepção em nível de objeto

  • Percepção em nível de pixel

  • Decodificador de pixel com 9,6 milhões de parâmetros

  • Previsão estruturada do próximo token

  • Tokens de coordenadas dedicados

  • Token de instância especial para tarefas densas

  • Licença Apache 2.0

  1. Acesse a página do modelo: Visite a página do WeVisOne-VL no Hugging Face

  2. Autentique-se: Certifique-se de ter as permissões necessárias para acessar o modelo

  3. Configure: Defina os parâmetros do modelo conforme suas necessidades de pesquisa

  4. Envie prompts: Insira suas tarefas visuais para processamento

  5. Ajuste: Ajuste o modelo para tarefas específicas, se necessário

  • Detecção de Objetos
  • Localização Referencial
  • Contagem de Objetos
  • Localização OCR
  • Matização de Imagens

Ferramentas de IA populares como WeVisOne-VL

WeVisOne-VL é um modelo unificado de visão-linguagem desenvolvido pela WeChat Vision, Tencent Inc. Ele integra percepção em nível de objeto e em nível de pixel para tarefas como…

Ferramentas de visão computacional
Ver ferramenta

Modelo unificado de visão-linguagem desenvolvido pela WeChat Vision, Tencent Inc. Ele integra percepção em nível de objeto e em nível de pixel para tarefas como…WeVisOne-VL é um modelo unificado de visão-linguagem desenvolvido pela WeChat Vision, Tencent Inc. Ele integra percepção em nível de objeto e em nível de pixel para tarefas como…

Ferramentas de visão computacional
Ver o Top 50 de LLMs

Qwen2-VL-7B-Instruct é um modelo de IA avançado projetado para compreensão visual e suporte multilíngue. Ele se destaca no processamento de imagens e vídeos, oferecendo desempenho…

Ferramentas de visão computacional
Ver ferramenta

Modelo de IA avançado projetado para compreensão visual e suporte multilíngue. Ele se destaca no processamento de imagens e vídeos, oferecendo desempenho…Qwen2-VL-7B-Instruct é um modelo de IA avançado projetado para compreensão visual e suporte multilíngue. Ele se destaca no processamento de imagens e vídeos, oferecendo desempenho…

Ferramentas de visão computacional
Ver o Top 5 de Modelos de IA

Qwen-VL

Repositórios de IA no GitHub

Qwen-VL é um grande modelo de linguagem visual desenvolvido pela Alibaba Cloud. Ele oferece capacidades avançadas para tarefas de chat e visão, proporcionando uma plataforma…

Modelos de IA e LLMs
Ver ferramenta

Repositórios de IA no GitHub

Grande modelo de linguagem visual desenvolvido pela Alibaba Cloud. Ele oferece capacidades avançadas para tarefas de chat e visão, proporcionando uma plataforma…Qwen-VL é um grande modelo de linguagem visual desenvolvido pela Alibaba Cloud. Ele oferece capacidades avançadas para tarefas de chat e visão, proporcionando uma plataforma…

Modelos de IA e LLMs
Ver o Top 250 de Repositórios de IA no GitHub

Qwen2-VL-72B-Instruct é um modelo avançado de IA projetado para compreensão visual de ponta e suporte multilíngue. Ele se destaca no processamento de imagens, vídeos e tarefas de…

Modelos de IA e LLMs
Ver ferramenta

Modelo avançado de IA projetado para compreensão visual de ponta e suporte multilíngue. Ele se destaca no processamento de imagens, vídeos e tarefas de…Qwen2-VL-72B-Instruct é um modelo avançado de IA projetado para compreensão visual de ponta e suporte multilíngue. Ele se destaca no processamento de imagens, vídeos e tarefas de…

Modelos de IA e LLMs
Ver o Top 5 de Modelos de IA

Ultralytics YOLO

Repositórios de IA no GitHub

Ultralytics YOLO inclui YOLO26, YOLO11 e YOLOv8, oferecendo capacidades para detecção de objetos, segmentação de instâncias, segmentação semântica, classificação de imagens,…

Ferramentas de visão computacional

Nº 19 em Repositórios de IA no GitHub

Ver ferramenta

Repositórios de IA no GitHub

Ultralytics YOLO inclui YOLO26, YOLO11 e YOLOv8, oferecendo capacidades para detecção de objetos, segmentação de instâncias, segmentação semântica, classificação de imagens,…

DestaqueFerramentas de visão computacional
Nº 19 em Repositórios de IA no GitHub

CLIP ViT-B/32

Modelos de IA

O modelo clip-vit-base-patch32 da OpenAI é projetado para tarefas de classificação de imagens em zero-shot. Ele utiliza uma arquitetura de Vision Transformer para aumentar a…

Ferramentas de visão computacional
Ver ferramenta

Modelos de IA

O modelo clip-vit-base-patch32 da OpenAI é projetado para tarefas de classificação de imagens em zero-shot. Ele utiliza uma arquitetura de Vision Transformer para aumentar a…

DestaqueFerramentas de visão computacional
Ver o Top 5 de Modelos de IA

Ultralytics

Apps de IA

Uma plataforma de visão computacional de ponta a ponta para anotar dados, treinar modelos YOLO e implantá-los globalmente, construída em torno do amplamente adotado framework de…

Ferramentas de visão computacionalManufatura e indústria

Nº 5 em Manufatura e indústria

Ver ferramenta

Apps de IA

Uma plataforma de visão computacional de ponta a ponta para anotar dados, treinar modelos YOLO e implantá-los globalmente, construída em torno do amplamente adotado framework de…

DestaqueFerramentas de visão computacionalManufatura e indústria
Nº 5 em Manufatura e indústria
1 de 8