Descrição
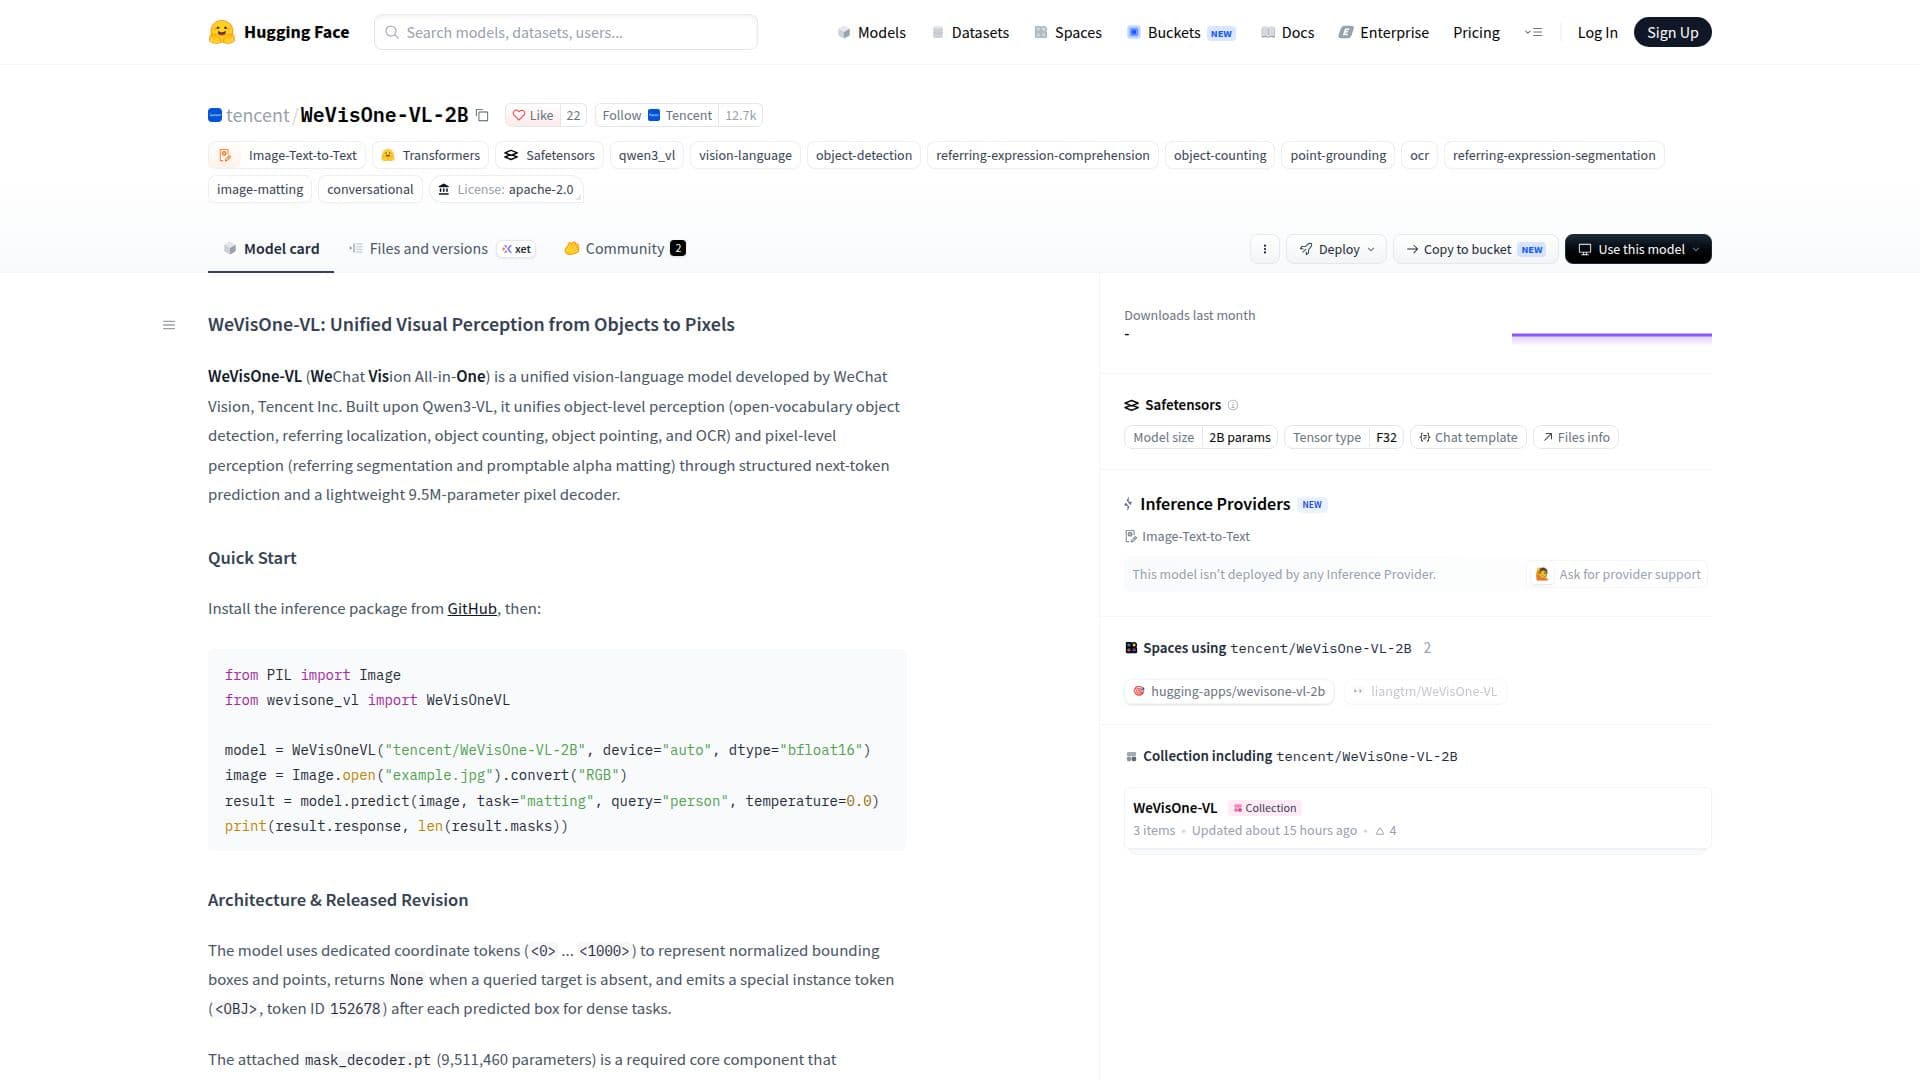
WeVisOne-VL é um sofisticado modelo de visão-linguagem desenvolvido pela WeChat Vision, uma divisão da Tencent Inc. Este modelo é construído sobre a estrutura Qwen3-VL e é projetado para unificar tarefas de percepção em nível de objeto e em nível de pixel. Ele é capaz de lidar com detecção de objetos de vocabulário aberto, localização referencial, contagem de objetos, apontamento de objetos e reconhecimento óptico de caracteres (OCR).
Ler mais
Além disso, suporta tarefas em nível de pixel, como segmentação referencial e matização alfa acionável.
O modelo emprega previsão estruturada do próximo token e apresenta um decodificador de pixel leve com 9,5 milhões de parâmetros. Um componente chave do WeVisOne-VL é o mask_decoder.pt, que integra um Adaptador de Recursos Visuais, um Decodificador de Consulta Guiado por Caixa e uma Cabeça de Predição Densa Condicionada por Instância. Esses componentes trabalham juntos para refinar previsões e gerar matizes alfa de alta resolução.
WeVisOne-VL é destinado a aplicações de pesquisa em ancoragem visual, localização, apontamento, contagem, OCR, segmentação e matização de imagens. Não é projetado para tomada de decisão autônoma ou identificação individual. O modelo é otimizado para percepção de imagem em uma única interação e não suporta grades de vídeo.
O modelo é lançado sob a Licença Apache 2.0, com componentes de terceiros mantendo suas licenças originais. Os usuários são incentivados a revisar os arquivos de origem para detalhes específicos de licenciamento.
- CategoriaFerramentas de visão computacional
- Modelo de preçosCódigo aberto
- ImplantaçãoNuvem
- PlataformasWeb
Destaques de WeVisOne-VL
Modelo unificado de visão-linguagem
Percepção em nível de objeto
Percepção em nível de pixel
Detecção de objetos de vocabulário aberto
Segmentação referencial
Matização alfa acionável
Previsão estruturada do próximo token
Decodificador de pixel leve
Primeiros passos com WeVisOne-VL
Acesse a página do modelo: Visite a página do modelo no Hugging Face
Autentique-se: Faça login na sua conta do Hugging Face
Configure: Configure o modelo com os parâmetros necessários
Envie prompts: Insira seus dados visuais para processamento
Ajuste: Ajuste as configurações do modelo para tarefas específicas
Casos de uso de WeVisOne-VL
- Ancoragem Visual
- Detecção de Objetos
- Matização de Imagens
- Localização de OCR
- Segmentação Referencial