설명
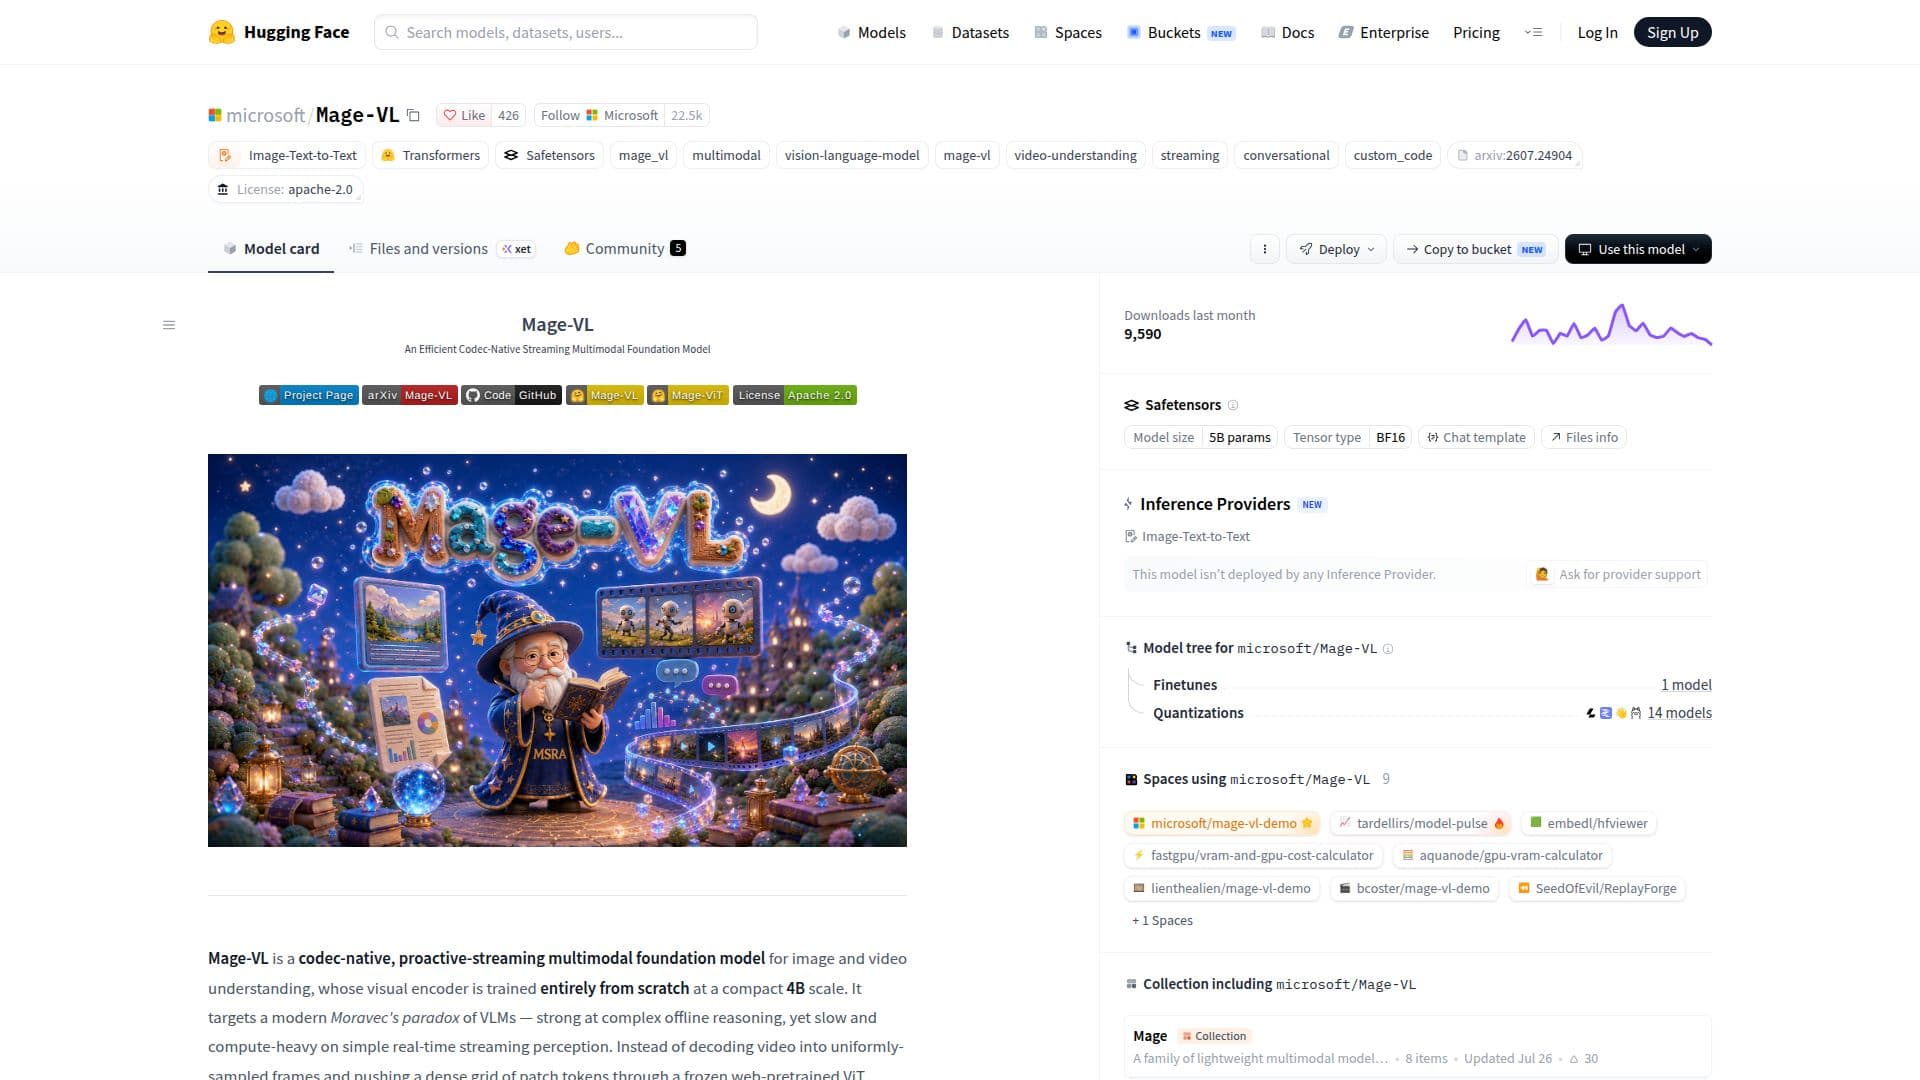
Mage-VL은 이미지 및 비디오 이해의 문제를 해결하기 위해 개발된 혁신적인 다중 모달 기초 모델입니다. 이 모델은 시각 데이터를 효율적으로 처리하는 코덱 네이티브, 능동 스트리밍 모델로 설계되었습니다. 모델의 시각 인코더인 Mage-ViT는 처음부터 훈련되었으며, 컴팩트한 4B 스케일에서 작동합니다. 이 인코더는 코덱에서 파생된 시공간 중요도에 따라 토큰을 할당할 수 있는 독특한 기능을 가지고 있어, 동일한 계산 예산 하에서 최대 8배 더 긴 비디오를 처리할 수 있습니다.
더 읽기
Mage-VL의 아키텍처에는 유일한 사전 훈련된 구성 요소인 Qwen3-4B 인과 디코더가 포함되어 있습니다. 이 디코더는 Mage-ViT와 함께 작동하여 가변 길이의 토큰 스트림을 처리하며, 다양한 길이의 이미지와 비디오에 대한 통합 인터페이스를 지원합니다. 모델의 이중 프로세스 설계는 콘텐츠를 모니터링하고 필요할 때만 전체 시각 언어 모델을 활성화하는 능동 스트리밍을 가능하게 하는 인지 게이트를 포함합니다.
모델의 코덱 네이티브 접근 방식은 시각 토큰 소비를 75% 이상 줄여 전통적인 방법에 비해 3.5배의 속도 향상을 가져옵니다. 이러한 효율성은 정확성을 저하시키지 않으면서 달성되어, Mage-VL은 실시간 비디오 분석 및 이해를 위한 강력한 도구가 됩니다.
Mage-VL은 비디오 이해 및 공간 지능에서 특히 강력하며, 여러 벤치마크에서 유사한 모델보다 우수한 성능을 보입니다. 능동 스트리밍 기능은 SoccerNet 스트리밍 작업에서 낮은 지연 시간의 이벤트 기반 해설을 제공함으로써 입증됩니다.
전반적으로 Mage-VL은 복잡한 시각 작업을 위한 데이터 효율적인 솔루션을 제공하는 다중 모달 AI 모델의 중요한 발전을 나타냅니다. 그 개방형 소스 특성과 포괄적인 기능은 인공지능 분야의 개발자와 연구자에게 귀중한 자원이 됩니다.
- 카테고리AI 모델 및 LLM
- 요금제오픈소스
- 배포클라우드
- 플랫폼웹
Mage-VL 하이라이트
코덱 네이티브 시각 인코더
능동 스트리밍 게이트
Qwen3-4B 인과 디코더
3.5배 추론 속도 향상
데이터 효율적인 토크나이저
가변 해상도 사전 훈련
이미지와 비디오를 위한 통합 모델
이벤트 기반 해설
Mage-VL 시작하기
모델 페이지에 접근: Hugging Face 리포지토리 방문
인증: Hugging Face 계정 자격 증명 사용
구성: 모델 매개변수 및 환경 설정
프롬프트 전송: 처리할 이미지 또는 비디오 데이터 입력
미세 조정: 특정 작업을 위한 모델 설정 조정
Mage-VL의 사용 사례
- 실시간 비디오 분석
- 공간 지능
- 이벤트 기반 해설
- 이미지 이해
- 능동 스트리밍