설명
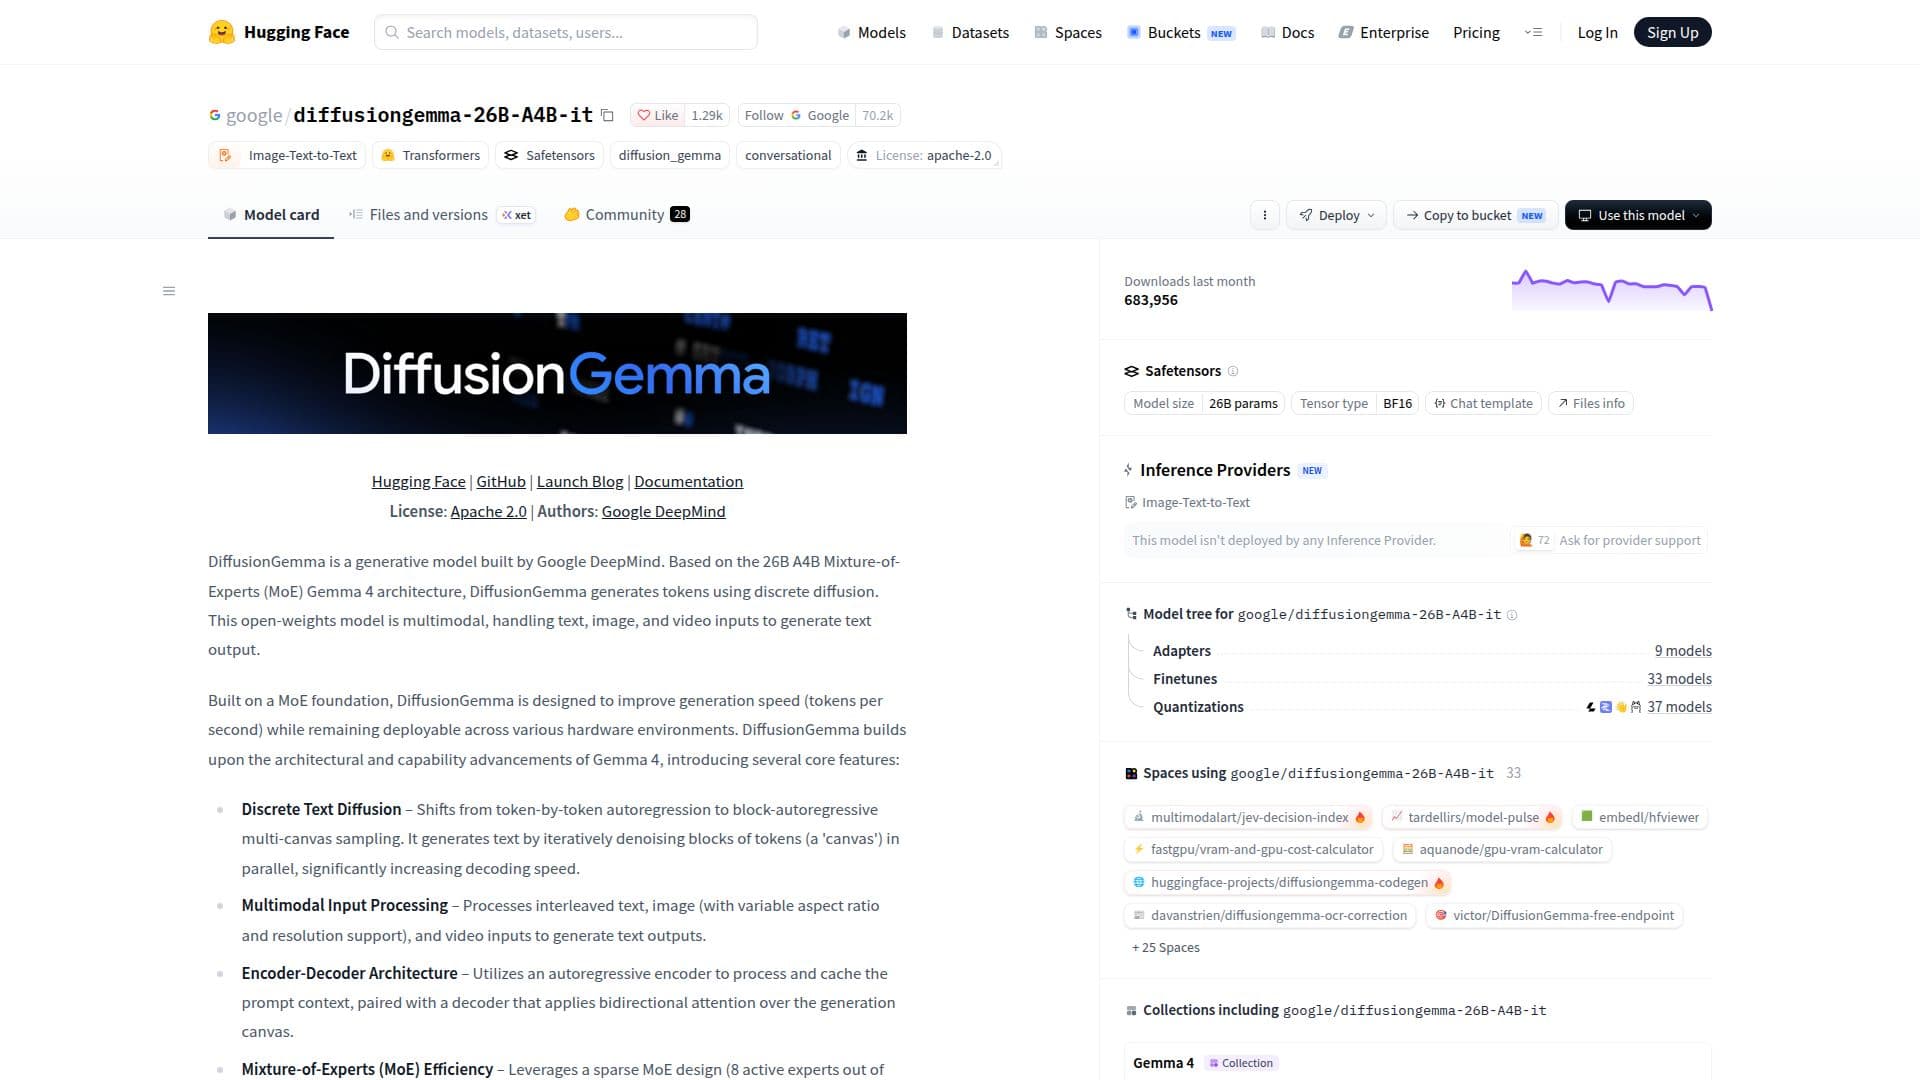
DiffusionGemma는 Google DeepMind에서 개발한 생성 모델로, 26B A4B Mixture-of-Experts (MoE) Gemma 4 아키텍처를 활용합니다. 이 모델은 텍스트, 이미지 및 비디오를 포함한 다중 모드 입력에서 텍스트 출력을 생성하도록 설계되었습니다. 모델은 토큰 생성 속도를 향상시키기 위해 이산 확산을 사용하여 다양한 하드웨어 환경에서 배포에 적합합니다.
더 읽기
모델의 아키텍처는 블록 자가 회귀 다중 캔버스 샘플링 방법을 특징으로 하며, 이는 토큰 블록을 병렬로 디노이즈하여 디코딩 속도를 크게 증가시킵니다. 이 접근 방식은 DiffusionGemma가 전통적인 자가 회귀 모델에 비해 더 높은 속도로 텍스트를 생성할 수 있게 합니다. 인코더-디코더 아키텍처는 프롬프트 컨텍스트를 처리하고 캐시하기 위해 자가 회귀 인코더를 사용하며, 디코더는 생성 캔버스에 대해 양방향 주의를 적용합니다.
DiffusionGemma의 희소 MoE 설계는 128개 중 8개의 활성 전문가를 포함하여 강력한 추론 능력을 제공하면서도 낮은 메모리 사용량을 유지합니다. 이러한 효율성 덕분에 로컬 실행에 적합하며, 소규모 배치 크기 추론에 최적화되어 단일 유능한 가속기에서 고속 생성을 달성합니다.
이 모델은 구조적이고 제어 가능한 대화를 가능하게 하는 네이티브 시스템 프롬프트 업데이트를 지원합니다. 또한 향상된 추론 능력을 위한 구성 가능한 사고 모드를 포함합니다. 최대 256K 토큰의 컨텍스트 창을 통해 DiffusionGemma는 긴 컨텍스트 작업을 효과적으로 처리할 수 있습니다.
DiffusionGemma는 다양한 벤치마크에 대해 평가되었으며, 텍스트 생성 및 추론 작업에서 경쟁력 있는 성능을 보여주었습니다. 140개 이상의 언어로 사전 훈련되어 다국어 기능을 지원하며, 객체 탐지, 문서 파싱 및 비디오 콘텐츠 분석을 포함한 강력한 이미지 및 비디오 이해 기능을 제공합니다.
전반적으로 DiffusionGemma는 고속 다중 모드 텍스트 생성을 위해 설계된 다재다능한 모델로, 콘텐츠 제작, 연구 및 교육 등 다양한 응용 분야에 적합합니다.
- 카테고리AI 모델 및 LLM
- 요금제Open Weights
- 배포클라우드
- 플랫폼웹
DiffusionGemma 하이라이트
이산 텍스트 확산
다중 모드 입력 처리
인코더-디코더 아키텍처
Mixture-of-Experts 효율성
사고 모드
소규모 배치 크기 추론 최적화
네이티브 시스템 프롬프트 지원
긴 컨텍스트 처리
DiffusionGemma 시작하기
모델 페이지에 접근: Hugging Face 모델 페이지 방문
인증: 로그인하거나 계정 생성
구성: 모델 매개변수 설정
프롬프트 전송: 텍스트, 이미지 또는 비디오 프롬프트 입력
미세 조정: 특정 작업에 대한 설정 조정
DiffusionGemma의 사용 사례
- 텍스트 생성
- 이미지 데이터 추출
- 비디오 이해
- 다국어 지원
- 연구 및 교육