

멀티모달 파이프라인이 실패하는 이유는 모델이 환각을 일으켜서가 아닙니다. Sora의 다운로드 URL이 렌더링 완료 후 61분 만에 만료되거나, 90분짜리 팟캐스트가 OpenAI의 25 MB 전사 한도에 걸리는 반면 AssemblyAI는 최대 5 GB 파일을 한 번의 요청으로 처리할 수 있기 때문입니다.
모델 간 각 단계에는 계약이 존재합니다: 정확한 파일 형식, 해당 형식을 사용할 수 있는 플랜 등급, 만료 창, 그리고 벤더가 모델을 종료했을 때의 폴백입니다. 대부분의 가이드는 이 네 가지를 모두 건너뜁니다.
이 글에서는 계약 내용, 세 가지 실제 파이프라인 예제, 그리고 OpenAI가 Videos API와 Sora 2 모델 두 종류를 2026년 9월 24일에 종료하기 전에 필요한 대체 계획을 제공합니다. 대체 모델 목록은 없습니다. 지금으로부터 19일 후입니다.
멀티모달 파이프라인이 모델이 아닌 핸드오프에서 실패하는 이유
파이프라인의 모든 모델은 각자의 역할을 합니다. 전사는 정확하고, 이미지는 맞고, 음성은 자연스럽고, 영상도 렌더링됩니다. 문제는 한 모델의 출력이 다음 모델의 입력이 되는 순간에 발생하며, 아무도 그 출력이 어떤 형태여야 하는지 기록해 두지 않았기 때문입니다.
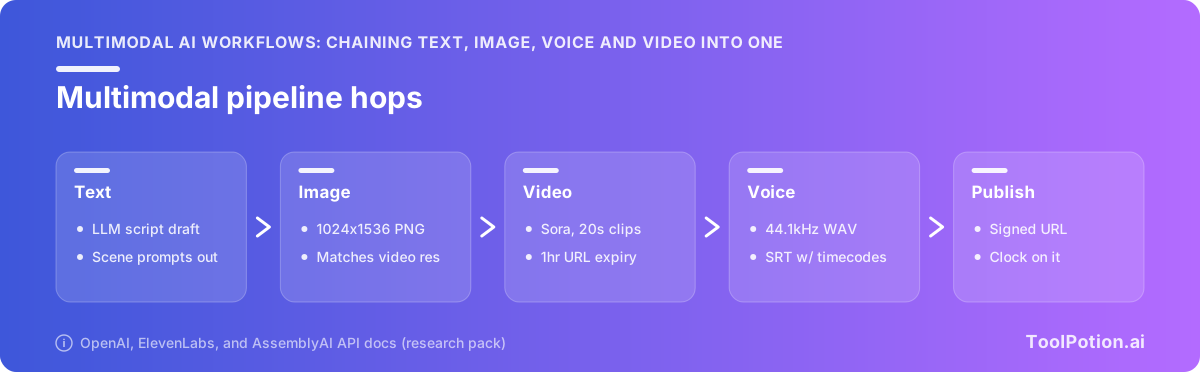
구체적인 예시: Sora의 생성된 에셋 다운로드 URL은 생성 후 최대 1시간 동안만 유효하며, 출력물은 MP4와 WebP 썸네일, JPG 스프라이트시트로 구성됩니다 (OpenAI). 파이프라인이 렌더링을 큐에 넣고 90분 후에 복사 단계에 도달하면, 렌더링 결과물은 사라집니다. 모델은 자신의 역할을 완벽하게 수행했습니다.
핸드오프 계약: 형식, 등급, 만료, 폴백
모든 단계를 네 가지 조건이 있는 계약으로 취급하고, 빌드를 시작하기 전에 기록해 두십시오.
형식은 다음 단계가 요구하는 정확한 파일 사양입니다. 종횡비와 막연한 기대가 아닌 샘플레이트와 픽셀 치수까지 포함합니다. 등급은 해당 형식을 사용할 수 있는 플랜 수준 또는 단일 API 파라미터입니다. 필요한 형식 중 상당수가 유료 구독이나 레거시 모델명 뒤에 잠겨 있기 때문입니다. 만료는 아티팩트가 벤더 스토리지에서 얼마나 오래 검색 가능한지, 즉 손실 책임이 누구에게 있는지를 나타냅니다. 폴백은 벤더가 모델을 종료했을 때 대체할 것으로, 지금은 가상의 이야기가 아닙니다.
각 단계마다 이 네 줄을 기록하면 대부분의 디버깅이 시작 전에 사라집니다.
파이프라인을 중단시키는 네 가지 실패 유형
- 상위 단계가 하위 단계에서 조용히 다운그레이드하거나 완전히 거부하는 형식으로 출력을 내보냅니다.
- API에 있다고 가정했던 기능이 더 높은 플랜 등급이나 이전 모델 버전 뒤에 있는 경우입니다.
- 작업이 아직 큐에 있는 동안 벤더의 스토리지에서 아티팩트가 만료됩니다.
- 구축한 모델의 종료 날짜가 공지되었지만, 벤더가 권장 대체 모델을 제시하지 않습니다.
이어지는 세 가지 파이프라인은 모두 동일한 계약의 인스턴스입니다: 팟캐스트에서 쇼노트로, 스크립트에서 내레이션 영상으로, 그리고 제품 사진에서 캠페인 세트로. 각각은 모든 단계에서 형식, 등급, 만료, 폴백을 명시합니다.
이 글은 아키텍처를 비교하는 사람이 아닌 결과물을 출시하는 실무자를 위해 작성되었습니다. 개별 도구는 디렉토리에 등록된 18,982개의 활성 AI 도구에서 선택할 수 있습니다. 이를 연결하는 부분이 아무도 문서화하지 않는 영역입니다.
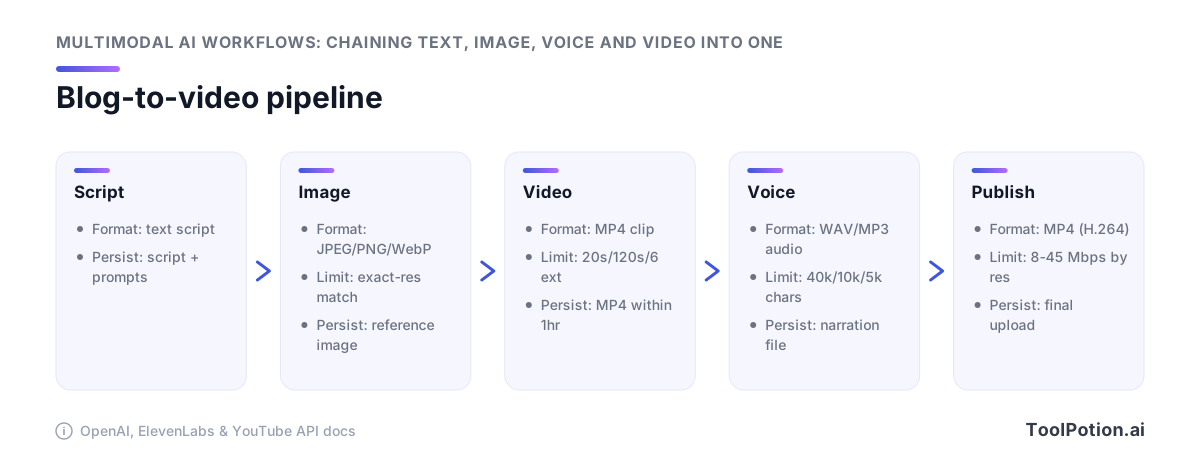
파이프라인 1: 블로그 포스트에서 내레이션 영상으로
1,200단어 기사로 2분짜리 내레이션 영상을 만들고자 합니다. 네 단계: 텍스트 분할, 스틸 이미지 생성, 애니메이션, 음성 추가. 각 단계에는 이전 단계가 충족해야 하는 사양이 있으며, 이 사양의 대부분은 API 호출을 하기 전에 설정해야 합니다.
생성 호출 전 스크립트 분할
분할은 마지막에 하는 서식 작업이 아닙니다. 이는 하위의 모든 것이 상속하는 파라미터입니다. 선택한 음성 모델이 요청당 전송할 수 있는 양을 제한하기 때문입니다. Eleven Flash v2.5는 40,000자, Multilingual v2는 10,000자, v3는 5,000자 제한이 있습니다 (ElevenLabs). 표현력 있는 내레이션을 위해 v3를 선택하면 1,200단어 스크립트가 한 번의 호출로 들어갑니다. 9,000단어 해설 영상에 v3를 선택하면 두 덩어리로 나눠야 하고, 숨겨야 할 이음새가 생깁니다.
장면 경계를 기준으로 분할하고, 문장 수로 분할하지 마십시오. 각 세그먼트에는 하나의 시각적 아이디어, 초 단위 목표 시간, 그리고 메타데이터로 첨부된 목표 픽셀 해상도가 필요합니다. 마지막 필드가 이미지 단계에서 읽는 값입니다.
이미지 단계: 영상 단계의 정확한 픽셀 치수 맞추기
Sora의 이미지-영상 변환 경로는 참조 이미지가 목표 영상 해상도와 정확히 일치해야 하며, image/jpeg, image/png 또는 image/webp 형식이어야 합니다 (OpenAI). 정확하다는 것은 픽셀 수를 의미하며, '16:9'가 아닙니다. 와이드스크린 스틸을 생성하도록 지시받은 이미지 생성기는 영상 호출이 1280x720을 원할 때 기꺼이 1792x1024를 제공할 것이고, 작업은 렌더링 시간이 아닌 제출 시에 실패합니다. 따라서 이미지 프롬프트 템플릿은 영상 단계의 설정에서 가져온 너비와 높이를 정수 리터럴로 포함하며, 큐에 넣기 전에 반환된 파일의 치수와 MIME 타입을 검증합니다. 디렉토리에 등록된 324개의 AI 모델 중에서 이름이 지정된 프리셋 대신 임의의 픽셀 치수를 지정할 수 있는 모델이 여기에 연결할 가치가 있습니다.
영상 단계: 16초 및 20초 클립 연결
sora-2와 sora-2-pro 모두 16초 또는 20초 클립을 생성합니다. 각 확장은 최대 20초를 추가하며, 최대 6번 확장하여 총 120초까지 가능합니다 (OpenAI). 2분짜리 세그먼트는 6번의 연쇄 호출입니다.
이 6번에 걸친 연속성은 귀하의 문제입니다. 모델은 확장 3과 확장 4 사이의 내러티브 흐름을 기억하지 못하므로, 각 호출의 프롬프트에는 배경, 피사체, 카메라 움직임을 다시 명시해야 합니다. 이음새 부분의 재시도 비용을 예산에 포함하십시오.
음성 단계와 믹싱
영상 단위가 아닌 세그먼트 단위로 내레이션을 생성하면, 실패한 테이크 비용이 한 번의 호출로 줄어듭니다. 그런 다음 정렬합니다: 세그먼트 4의 오디오는 세그먼트 4용으로 렌더링한 20초 클립에 맞아야 하며, 이는 일반적으로 오디오를 시간 늘리기보다 스크립트 본문을 다듬는 것을 의미합니다. ffmpeg로 세그먼트 단위로 믹스한 다음 이어 붙입니다.
파이프라인 2: 팟캐스트 에피소드에서 클립과 쇼노트로
58분짜리 WAV 파일이 들어갑니다. 나오는 것은 트랜스크립트, 타임스탬프가 있는 챕터, 자막이 새겨진 세로형 클립 6개, 그리고 쇼노트 페이지입니다. 오디오는 첫 번째 단계 이후 형식이 변하지 않으며, 이것이 이 파이프라인을 영상 파이프라인보다 쉽게 만드는 이유입니다. 작동 여부를 결정하는 것은 어떤 전사 벤더로 라우팅하고 요청에 어떤 세 가지 파라미터를 설정하느냐입니다.
25 MB 장벽과 우회 방법
OpenAI의 전사 엔드포인트는 업로드를 25 MB로 제한하며 mp3, mp4, mpeg, mpga, m4a, wav, webm을 지원합니다 (OpenAI). 58분짜리 48kHz WAV는 약 300 MB입니다. 따라서 저비트레이트 MP3로 트랜스코딩하거나 파일을 분할해야 하는데, 임의의 바이트 경계에서 오디오를 분할하면 단어가 잘리고 이음새 이후의 모든 타임스탬프가 어긋납니다.
AssemblyAI는 /v2/transcript에서 요청당 최대 5 GB를 처리하며(로컬 파일을 /v2/upload로 업로드하는 경우 2.2 GB), 160ms에서 10시간까지 지원합니다 (AssemblyAI). 약 200배의 상한선입니다. 장시간 오디오의 경우 전체 에피소드를 그쪽으로 보내고, LLM 벤더는 하위 추론 단계에 사용하십시오.
단어 수준 타임스탬프가 클립 편집의 기본 단위
단락 경계만 있는 트랜스크립트에서는 클립을 자동으로 자를 수 없습니다. "anyway"라는 단어가 00:41:12.340에 시작한다는 것을 알아야 컷이 그 단어 이전에 정확하게 들어갑니다.
OpenAI 측에는 두 가지 주의사항이 있습니다. SRT 및 VTT 출력과 timestamp_granularities[] 파라미터는 gpt-transcribe 또는 gpt-4o-transcribe가 아닌 whisper-1에서만 작동합니다 (OpenAI). 파이프라인이 자막을 삽입하거나 타임코드로 클립을 자른다면, 기술적 부채로 여기지 말고 의도적으로 이전 모델을 파이프라인에 유지하십시오. ElevenLabs Scribe v2는 90개 이상의 언어에서 단어 수준 타임스탬프, 화자 분리, 엔티티 감지를 하나의 응답으로 제공합니다 (ElevenLabs). TTS 단계에서 이미 비용을 지불하고 있다면 더 깔끔한 선택입니다.
화자 분리는 명시적으로 요청해야 작동합니다
화자 레이블은 30초 이상의 오디오에서 chunking_strategy를 auto로 설정해야 하며, gpt-4o-transcribe-diarize는 화자 식별만 수행합니다 (OpenAI). 파라미터를 생략하면 요청은 성공합니다. 반환되는 것은 깔끔하고 유창하지만, 두 진행자의 인터뷰가 한 명의 목소리로 합쳐진 완전히 레이블 없는 텍스트 덩어리이며, 응답에는 이를 알려주는 내용이 없습니다. 화자 필드는 눈으로 확인하지 말고 유효성 검사 단계에서 확인하십시오.
트랜스크립트에서 쇼노트, 챕터, 소셜 카피로
단어 타이밍이 포함된 트랜스크립트 하나가 추가 오디오 처리 없이 네 가지 아티팩트로 분기됩니다: 주제 전환에서 나온 챕터 마커, 쇼노트 페이지용 요약 단락과 링크 목록, 인용 밀도를 기준으로 점수를 매긴 클립 후보 순위, 그리고 입출력 포인트에서 렌더링된 세로형 클립 자체. 동일한 트랜스크립트를 각각 다른 프롬프트로 병렬 처리하십시오. 구축 전 형식 참조가 필요하다면, 디렉토리에는 201개의 AI 팟캐스트가 대략 이 스택으로 게시하고 있습니다.
파이프라인 3: 제품 사진에서 광고 변형으로
신발의 스튜디오 사진 한 장이 브랜드에 맞는 스틸 12장이 되고, 이어서 유료 소셜용 8초 모션 광고 4개가 됩니다. 단계는 이미지 입력, 이미지 출력, 영상 출력이며, 흥미로운 엔지니어링은 두 번째와 세 번째 단계 사이에 있습니다. 비전 모델이 이미지 생성기가 만든 결과물을 보고 출시 가능 여부를 판단하는 곳입니다.
QA 게이트로서의 비전 모델 검토
생성된 제품 스틸은 평범한 방식으로 실패합니다. 잘못된 로고 위치, 아일릿 5개 대신 6개, 주광과 모순되는 그림자. 120개의 변형을 사람이 일일이 확인하고 싶지 않으므로, 소스 사진과 작성된 브랜드 스펙과 함께 비전 모델에 보내고 합격/불합격과 이유 문자열을 요청합니다.
Claude는 200k 컨텍스트 모델에서 요청당 최대 100개의 이미지를, 다른 모델에서는 600개를 처리하며, claude.ai에서는 메시지당 20개로 제한됩니다. 이미지당 최대 8000x8000px, 10 MB입니다 (Claude Docs). 이 수치가 문제가 되지는 않습니다.
문제가 되는 것은 32 MB 표준 요청 크기 제한입니다. 4K PNG 12개는 이미지 100개에 도달하기 훨씬 전에 이 제한을 초과합니다. 그래서 Anthropic은 base64를 인라인으로 넣는 대신 Files API를 통해 업로드하고 file_id로 각 이미지를 참조하도록 권장합니다 (Claude Docs). 처음부터 이 방식으로 검토 단계를 구축하십시오. 배치 크기가 커진 후에 수정하면 요청 빌더와 재시도 로직을 함께 다시 작성해야 합니다.
프레임 샘플링은 직접적인 비용 조절 수단
Claude는 이미지를 28x28 픽셀 시각 토큰으로 청구하며, ⌈width/28⌉ × ⌈height/28⌉로 계산합니다. 3840x2160 프레임은 고해상도 등급에서 4,784 시각 토큰이고, 표준 등급에서 다운스케일 후 1,560입니다. Claude Opus 5의 입력 단가 $5/M 기준으로 4K 프레임 1,000개당 약 $23.92입니다 (Claude Docs). QA 검사가 스티칭이나 소형 텍스트 같은 세부 사항에 의존하지 않는 한, 전송 전에 다운스케일하십시오.
같은 수학이 영상 분석 단계에도 적용됩니다. 24fps에서 8초짜리 광고 4개를 검토하면 단순하게 768 프레임입니다. 2fps로 샘플링하면 64개를 확인하며, 단 한 번의 장면 전환도 놓치지 않으면서 검토 비용이 12분의 1로 줄어듭니다.
요청 한도를 초과하지 않고 이미지 배치 처리
이미지 수가 아닌 페이로드 바이트 기준으로 묶으십시오. 참조의 약 25 MB 이내로 유지되는 그룹으로 변형을 정렬하고, 비교 앵커로 모든 배치에 소스 사진을 포함시키며, 이유 문자열이 의미 있도록 실패한 항목은 전체 해상도로 개별 재전송하십시오. 우리 디렉토리에는 AI 이미지 및 사진 도구 디렉토리에 727개의 이미지 생성기와 342개의 사진 편집기가 등록되어 있으며, 여기서 필요한 배치 메커니즘을 노출하는 것은 거의 없습니다. 그 부분은 귀하의 코드로 남습니다.
핸드오프 사양 시트: 각 단계에서 요구해야 할 것
코드를 작성하기 전에 계약을 작성하십시오. 체인의 각 단계에는 세 가지를 정확히 파악해야 합니다: 요청하는 정확한 출력 형식, 이를 가능하게 하는 플랜 등급 또는 파라미터, 그리고 아티팩트가 사라지기 전까지의 유효 시간. 이것을 잘못 파악하면 실패는 두 단계 후에 아무도 추적할 수 없는 품질 불만으로 나타납니다.
오디오: 방송 품질 출력을 잠금 해제하는 등급
ElevenLabs는 pcm_44100, pcm_48000, wav_44100, wav_48000을 Pro 구독 뒤에 놓고, mp3_44100_192는 Creator 뒤에 놓습니다 (ElevenLabs API reference). 따라서 무료 또는 입문 플랜에서는 음성 모델이 아무리 좋아도 영상 편집기는 128kbps 이하의 손실 MP3를 받게 됩니다. 그것은 추론이 아닌 청구에 의해 설정된 품질 상한선입니다.
결과물이 -16 LKFS, 트루 피크 -1 dBFS 이하를 충족해야 하는 팟캐스트라면 (Apple Podcasts), 무손실 입력과 마지막에 한 번의 인코딩이 필요합니다. 128kbps MP3를 정규화하고 재인코딩하면 두 번의 손실 생성이 쌓입니다. Pro 등급을 업그레이드가 아닌 제작 비용으로 예산에 반영하십시오.
영상: 만료되는 URL과 사이드카 에셋
Sora는 파일 하나를 제공하지 않습니다. 완료된 렌더링은 MP4, WebP 썸네일, JPG 스프라이트시트를 제공하며, 다운로드 URL은 최대 1시간 동안만 유효합니다 (OpenAI video guide). 해당 단계의 작업은 완료 이벤트에 의해 트리거되는 자체 오브젝트 스토어로의 복사이며, 야간 배치가 아닙니다. 창을 놓치면 렌더링은 복구 불가능합니다.
텍스트와 타이밍: 하위 단계가 요구하는 필드
하위 단계는 특정 필드를 필수로 요구하며, 타이밍이 필요한 필드가 조용히 실패합니다. SRT 및 VTT 출력과 timestamp_granularities[]는 최신 전사 모델이 아닌 whisper-1에서만 작동합니다 (OpenAI speech to text). 클립을 자르거나 자막을 삽입하는 모든 것은 계약에 단어 수준 타임스탬프가 필요합니다.
| 단계 | 요구할 출력 | 잠금 해제 조건 | 만료 |
|---|---|---|---|
| 텍스트 음성 변환 | wav_48000 또는 pcm_44100 | Pro 등급; mp3_44100_192는 Creator | 만료 없음, 쓰기 시 저장 |
| 음성 텍스트 변환 | 단어 수준 타임스탬프, 화자 레이블 | SRT/VTT는 whisper-1; 화자 분리는 30초 이상에서 chunking_strategy: auto | 만료 없음 |
| 이미지 영상 변환 | MP4와 썸네일 및 스프라이트시트 | 참조 이미지가 영상 해상도와 정확히 일치해야 함 | 다운로드 URL 1시간 |
| 영상 텍스트 변환 | 고정 속도로 샘플링된 프레임 | 표준 대 고해상도 등급이 시각 토큰 비용을 약 3배 변경 | 만료 없음 |
디렉토리에 등록된 128개의 AI 프레임워크 중 어떤 오케스트레이터를 선택하든, 먼저 바이너리 단계에 대해 테스트하십시오. 모델 간에 JSON을 전달하는 것은 쉬운 부분입니다.
자동화 플랫폼 또는 수동 연결
규칙은 간단합니다: 무엇이 언제 발생할지는 플랫폼이 결정하게 하고, 바이트 이동은 자체 코드가 담당하게 하십시오. 대용량 파일을 다루거나 만료 창과 경쟁하는 모든 것은 오브젝트 스토리지를 뒤에 두고 스크립트로 처리해야 합니다.
플랫폼이 유리한 경우
트리거, 저렴한 단계에서의 재시도, 승인 게이트, 그리고 마지막 팬아웃. Zapier는 Zaps, Tables, Forms, Zapier MCP에 연결된 9,000개 이상의 앱 통합을 제공하며, 이 카탈로그가 사용하는 실제 이유입니다. 완성된 쇼노트를 CMS에 넣고 클립 링크를 콘텐츠 캘린더에 올리는 것은 커넥터 작업이며, 이런 커넥터를 직접 작성한다고 얻을 것이 없습니다.
루프에 사람이 개입하는 것도 여기에 해당합니다. 광고 변형 4개를 Slack에 게시하고 승인을 기다린 후 게시 단계를 실행하는 Zap은 20분 설정으로, 환각된 제품 주장과 유료 소셜 예산 사이에 있는 유일한 방어선입니다.
바이너리 미디어가 플랫폼을 이기는 경우
노코드 노드는 JSON을 잘 전달하지만 파일은 그렇지 않습니다. 58분짜리 WAV는 OpenAI의 전사 엔드포인트가 수락하기 전에 25 MB 이하로 분할되어야 합니다 (OpenAI). 2분짜리 Sora 렌더링은 각 20초씩 최대 6번의 확장 호출입니다 (OpenAI), 다운로드 URL은 생성 후 최대 1시간 동안만 유효합니다 (OpenAI). 아티팩트에 카운트다운이 실행되는 동안 6번의 호출에 걸친 재시도 로직은 캔버스가 아닌 프로그램입니다.
미디어를 처리하는 플랫폼이 두 개 있습니다. n8n은 base64 왕복을 강제하는 대신 노드 간에 파일을 바이너리 데이터로 유지하며, 코드 노드가 에이전트 노드 바로 옆에 있습니다 (n8n). Descript는 GUI가 아닌 API를 통해 전사, 클립, 자막을 노출합니다 (Descript).
중간 경로: 제어 흐름은 플랫폼, 바이트는 코드
모든 단계는 자체 버킷에 쓰고 키를 반환합니다. 플랫폼은 파일이 아닌 키와 상태 코드를 전달합니다. 이렇게 작업을 스테이징하면 컴퓨팅도 절감됩니다: OnePiece 시스템은 모놀리식 파이프라인을 단계별 서비스로 분해하면 Wan2.1 이미지-영상 변환의 GPU 소비가 16배 감소한다고 보고합니다 (arXiv).
컴포넌트를 선택하는 경우, 우리 디렉토리는 301개의 오픈소스 AI 레포와 함께 550개의 AI 에이전트 및 오케스트레이션 도구를 추적합니다. 바이트 이동 글루는 보통 레포에 있습니다. 벤더가 그 부분을 판매하지 않기 때문입니다.
납품 사양: 플랫폼이 게시하는 곳에 맞추기
마지막 단계는 렌더링이 아닙니다. 업로드이며, 업로드에도 사양 시트가 있습니다.
영상: 업로드를 위한 비트레이트 및 오디오 목표
YouTube는 해상도별 권장 납품 비트레이트를 게시합니다: 1080p SDR은 8 Mbps, 1440p는 16 Mbps, 4K는 35~45 Mbps이며, 오디오는 48 kHz, 384 kbps 스테레오의 AAC-LC, Opus 또는 Eclipsa로 납품합니다 (YouTube Help). 영상 단계에서 해당 수치보다 훨씬 낮은 파일이 나온다면, 내보내기 시 비트레이트를 강제로 올리지 마십시오. 압축 아티팩트를 채우는 데 인코딩 시간을 낭비하게 됩니다. 해야 할 일은 인코딩 단계가 소스 해상도를 읽고 맞는 목표를 선택하게 하는 것입니다. 6개월 전에 누군가 설정에 하드코딩해 놓았다는 이유로 1080p Sora 렌더링이 4K 래더로 강제 처리되지 않도록 하십시오.
내레이션 콘텐츠에서는 영상보다 오디오 목표가 더 중요합니다. 44.1 kHz 소스의 48 kHz 384 kbps AAC 트랙은 어딘가에서 리샘플링을 의미하며, 그 리샘플링은 직접 볼 수 있는 자체 ffmpeg 호출에서 한 번만 발생하게 하십시오.
오디오: 인코딩 전 음량 전처리
Apple Podcasts는 ITU-R BS.1770-5 기준으로 측정된 -16 dB LKFS ±1 dB, 트루 피크 -1 dB FS 이하를 요구하며, 인코딩 전에 해당 목표로 오디오를 전처리해야 한다고 명시합니다 (Apple Podcasts for Creators). 선호도가 아닌 작업 순서입니다. 완성된 MP3를 정규화하면 다른 레벨에서 구워진 손실 아티팩트를 통해 게인을 밀어넣는 것이며, 디코딩된 MP3의 트루 피크는 이미 인코더가 본 값을 초과할 수 있습니다. WAV에 음량 처리를 적용한 다음 인코딩하십시오.
이것이 체인 앞부분의 TTS 형식 등급이 계속 중요한 이유입니다. 정규화기에 128 kbps MP3를 넘기는 것은 PCM을 넘기는 것보다 나쁜 출발점이며, 하위에서 아무리 주의를 기울여도 수정되지 않습니다.
생성된 에셋의 출처 및 레이블링
플랫폼이 요청한 후가 아닌 파이프라인을 설계할 때 출처를 결정하십시오. Google의 SynthID는 생성 시 미디어에 워터마크를 삽입하며, 파이프라인이 이를 제거하거나 재인코딩하지 않는 경우에만 에셋과 함께 전달됩니다. 생성과 업로드 사이의 모든 ffmpeg 처리는 그 신호를 잃을 기회이므로, 컨테이너가 이를 전달하도록 신뢰하기보다 어느 단계에서 파일이 도입되었는지 추적하고 모델, 프롬프트, 타임스탬프의 기록을 자체 메타데이터 저장소에 유지하십시오.
교체를 위한 설계: 모든 영상 단계 아래의 지원 종료 절벽
영상 단계에서 Sora를 호출한다면, 19일이 남았습니다. OpenAI는 2026년 3월 24일에 Videos API와 sora-2, sora-2-pro 모델(스냅샷 sora-2-2025-10-06, sora-2-2025-12-08, sora-2-pro-2025-10-06 포함)이 2026년 9월 24일에 종료된다고 발표했으며, 권장 대체 모델이 나열되어 있지 않습니다 (OpenAI deprecations). 대체 컬럼이 비어 있다는 것은 귀하가 직접 후계자를 선택해야 한다는 의미이며, 종료 후가 아닌 종료 전에 선택해야 합니다.
교체가 설정 변경이 되도록 단계 추상화
해결책은 생성 단계마다 얇은 어댑터를 두는 것입니다. 파이프라인은 어댑터에 정규화된 작업을 전달합니다: 프롬프트, 참조 이미지 경로, 목표 해상도, 초 단위 시간, 출력 버킷 키. 어댑터는 벤더에 특화된 모든 것을 담당합니다. 참조 이미지가 영상 해상도와 정확히 일치해야 한다는 Sora의 규칙, 20초 단계로 120초 상한까지 확장되는 16초 및 20초 클립, 1시간 다운로드 만료 (OpenAI video generation). 이 중 어느 것도 오케스트레이션 코드에 누출되지 않습니다.
그러면 공급자 교체는 재작성이 아닌 설정 값 변경이 됩니다. 지금 Runway의 모델 문서를 기준으로 두 번째 어댑터를 검증하고, 동일한 10개의 프롬프트로 두 가지를 실행한 후 패자도 준비 상태로 유지하십시오.
이미지와 오디오 패밀리도 자체적인 날짜를 가지고 있으므로, 이를 일회성 작업이 아닌 정기적인 유지보수로 취급하십시오. 우리 디렉토리는 부분적으로 등록된 324개 모델에서 모델 출시 및 종료를 추적할 수 있도록 존재합니다.
현재 실행 중인 파이프라인의 마이그레이션 체크리스트
- 모든 레포와 워크플로우 JSON에서
sora-2,sora-2-pro, Videos API 기본 경로를 검색하십시오. 잊힌 호출이 있는 크론 작업과 일회성 스크립트도 포함하십시오. - 공급자를 변경하기 전에 자체 작업 스키마를 가진 어댑터로 각 결과를 감싸십시오. 교체와 리팩터링이 같은 커밋이 되지 않도록 하십시오.
- 10개의 실제 프롬프트로 대체 공급자를 실행하고 해상도, 클립 길이, 모션 품질의 출력을 비교하십시오.
- 벤더별, 모델 패밀리별로 공개된 종료 날짜 2주 전에 캘린더 알림을 설정하십시오.
- 모델이 사라진 후에도 "이 에셋을 무엇이 생성했는가"에 답할 수 있도록 모든 렌더링에 모델 ID와 스냅샷을 로깅하십시오.
자주 묻는 질문
실용적인 의미에서 멀티모달 AI 워크플로우란 무엇입니까?
한 모델의 출력 파일이 다음 모델의 입력 파일이 되는 API 호출의 체인이며, 모든 단계에는 충족해야 하는 형식 계약이 있습니다. 일반적인 체인은 트랜스크립트→스크립트→스틸 이미지→영상→보이스오버→최종 렌더링이며, 각 화살표는 잘못된 해상도나 코덱이 실행을 중단시키는 지점입니다. Sora의 이미지-영상 단계는 그 계약이 얼마나 문자 그대로인지를 보여주는 좋은 예입니다: 참조 이미지가 목표 영상 해상도와 정확히 일치해야 하고 image/jpeg, image/png 또는 image/webp여야 하므로, 업스트림 이미지 단계에는 종횡비가 아닌 영상 단계의 픽셀 치수가 필요합니다 (OpenAI video generation docs). 파이프라인을 도구의 집합이 아닌 핸드오프의 집합으로 생각하십시오.
단계 간 품질 손실 없이 AI 도구를 연결하려면 어떻게 해야 합니까?
모든 단계의 출력 사양을 체인의 마지막 단계가 필요로 하는 것으로 고정하고, 역방향으로 작업하십시오. 품질 손실은 일반적으로 모델이 아닌 가격 등급이나 기본 파라미터에서 발생합니다: ElevenLabs는 pcm_44100, pcm_48000, wav_44100, wav_48000을 Pro 구독 뒤에, mp3_44100_192는 Creator 등급 뒤에 두므로, 입문 등급 계정은 원하든 원하지 않든 편집기에 손실 MP3를 전달합니다 (ElevenLabs create speech reference). Sora의 다운로드 URL은 생성 후 최대 1시간 동안만 유효하므로, 생성된 모든 아티팩트를 즉시 자체 오브젝트 스토어에 복사하십시오 (OpenAI video generation docs). 샘플링 레이트도 품질뿐 아니라 비용 조절 수단입니다: Claude는 4K 프레임을 고해상도 등급에서 4,784 시각 토큰으로, 표준에서 1,560으로 청구하며, Opus 5의 $5/M 입력 단가 기준으로 4K 프레임 1,000개당 약 $23.92입니다 (Claude vision docs).
텍스트 음성 변환 단계에서 영상 편집기로 어떤 오디오 형식을 전달해야 합니까?
압축되지 않은 48 kHz WAV 또는 PCM으로, ElevenLabs에서는 wav_48000 또는 pcm_48000이고 Pro 구독 이상이 필요합니다 (ElevenLabs create speech reference). 편집기에 128 kbps MP3를 넘기면 이후 모든 인코딩에서 살아남는 압축 아티팩트를 심게 됩니다. 납품 목적지가 YouTube라면 최종 납품 목표는 48 kHz, 384 kbps 스테레오의 AAC-LC, Opus 또는 Eclipsa이며 (YouTube upload encoding settings), 팟캐스트 피드라면 Apple은 ITU-R BS.1770-5로 측정된 -16 dB LKFS ±1 dB, 트루 피크 -1 dB FS 이하를 인코딩 전에 전처리하도록 요구합니다 (Apple Podcasts audio requirements). 손실 중간물에서는 어느 쪽 목표도 안정적으로 달성할 수 없습니다.
전체 길이 에피소드에서 팟캐스트 전사가 실패하는 이유는 무엇입니까?
OpenAI의 전사 엔드포인트는 업로드를 25 MB로 제한하며 mp3, mp4, mpeg, mpga, m4a, wav, webm을 수락하므로, 적당한 비트레이트에서 30분 이상인 모든 것은 25 MB 이하의 청크로 분할되어야 합니다 (OpenAI speech-to-text docs). 이것이 장시간 파이프라인이 보통 전사를 LLM 벤더에서 라우팅하는 이유입니다: AssemblyAI는 /v2/transcript에서 요청당 최대 5 GB(로컬 업로드는 2.2 GB)와 160ms에서 10시간짜리 파일을 처리하며, OpenAI의 상한보다 약 200배입니다 (AssemblyAI pre-recorded audio docs). 성공처럼 보이는 두 가지 실패 모드가 있습니다: 화자 분리는 30초 이상의 오디오에서 chunking_strategy를 'auto'로 설정하지 않으면 조용히 레이블 없는 텍스트를 반환하고, SRT/VTT 출력과 timestamp_granularities[]는 gpt-transcribe나 gpt-4o-transcribe가 아닌 whisper-1에서만 작동합니다 (OpenAI speech-to-text docs). 자동 클립 편집을 위한 단어 수준 타임스탬프가 필요하다면, ElevenLabs Scribe v2는 화자 분리와 함께 90개 이상의 언어에서 제공합니다 (ElevenLabs models).
AI 콘텐츠 파이프라인을 n8n이나 Zapier로 구축해야 합니까, 아니면 직접 코드로 작성해야 합니까?
바이너리 미디어를 이동하는 모든 단계는 코드로 작성하고, 트리거, 승인, 알림에는 자동화 플랫폼을 사용하십시오. Zapier의 강점은 Zaps, Tables, Forms, Zapier MCP에 연결된 벤더 공식 9,000개 이상의 앱 통합입니다 (Zapier developer platform). "Airtable에 새 행이 생기면 렌더링을 시작하고, 링크를 Slack에 게시"하는 것이 원하는 기능입니다. 1시간 만료 URL이 있는 200 MB MP4에는 맞지 않는 레이어입니다. n8n은 중간 어딘가에 있습니다. 에이전트 노드와 바이너리 패스스루 처리로 파일을 워크플로우 내에 유지할 수 있고 (n8n Tools Agent docs), 체인을 하나의 모놀리스가 아닌 단계로 분리하는 실질적인 인프라 근거가 있습니다: OnePiece 논문은 AIGC 파이프라인을 Wan2.1 이미지-영상 변환을 위한 단계별 마이크로서비스로 분해하면 GPU 소비가 16배 감소한다고 보고합니다 (arXiv).
2026년 9월 종료 후 영상 파이프라인에서 Sora를 무엇으로 대체합니까?
OpenAI는 2026년 3월 24일에 Videos API와 sora-2, sora-2-pro 모델(스냅샷 sora-2-2025-10-06, sora-2-2025-12-08, sora-2-pro-2025-10-06)이 2026년 9월 24일에 종료된다고 발표했으며, 권장 대체 모델이 없습니다 (OpenAI deprecations). 2026년 9월 5일 기준으로 19일 남았으므로, 실용적인 방법은 오늘 영상 단계를 얇은 인터페이스 뒤에 두고 다른 벤더로 연결하는 것입니다. Runway의 API가 가장 직접적인 대안입니다 (Runway models docs). Sora의 제한이 많은 파이프라인의 형태를 결정했기 때문에 청킹 로직 재작성도 예산에 포함하십시오: 16초 및 20초 클립, 확장당 최대 20초 추가, 최대 6번 확장에 걸쳐 최대 120초로, 2분짜리 내레이션 세그먼트는 6번의 연쇄 호출이었습니다 (OpenAI video generation docs). 대안을 찾고 있다면, 우리 디렉토리는 현재 AI 영상 생성기 카테고리에서 452개의 도구를 추적하고 있습니다.