

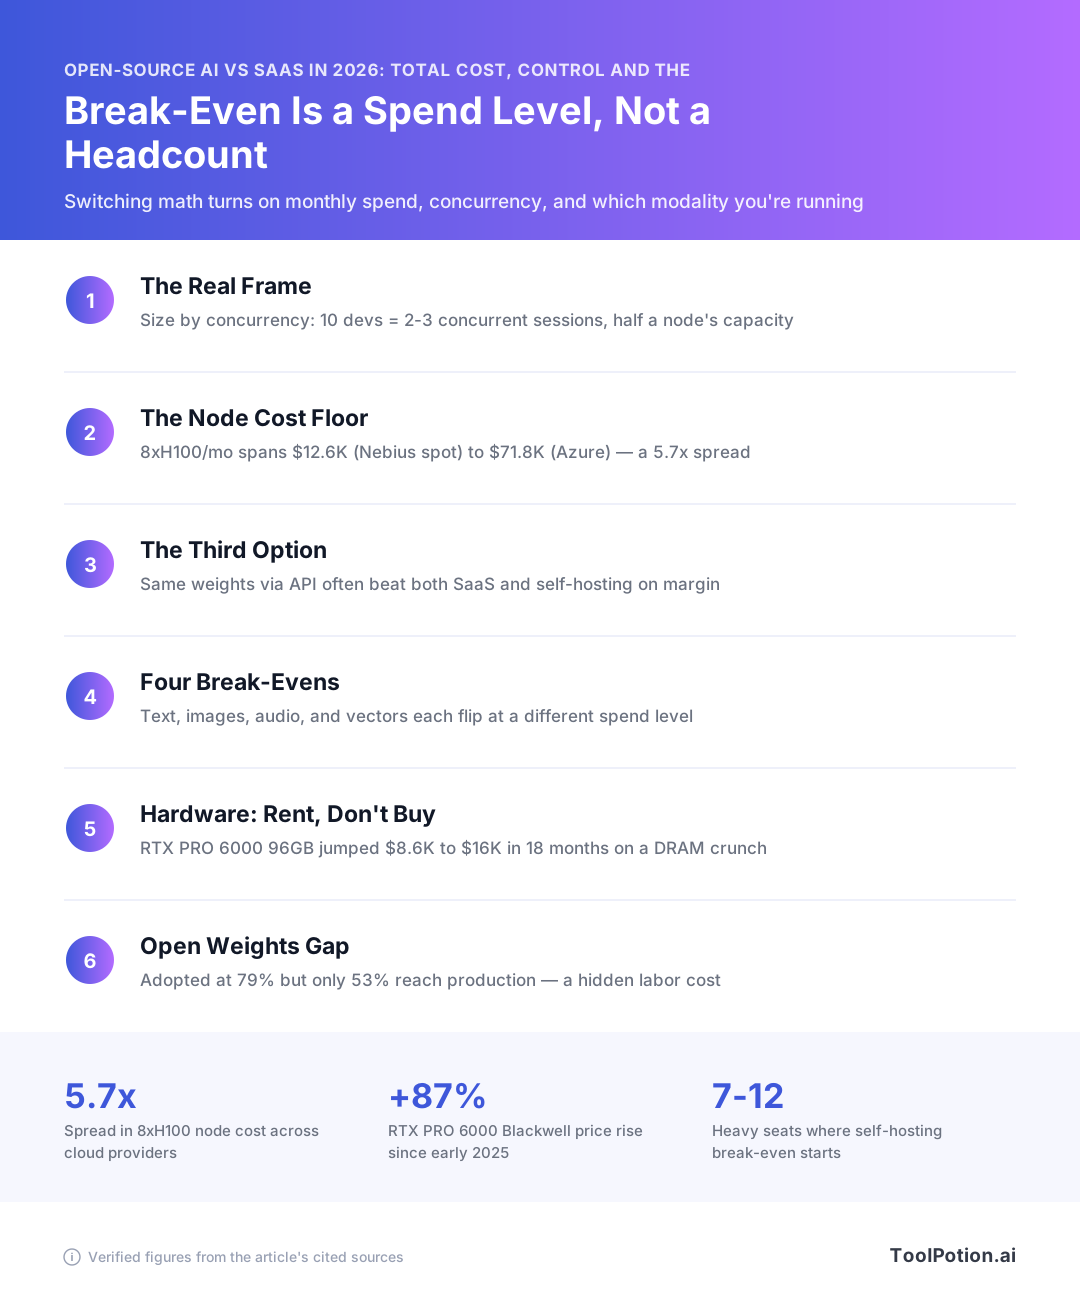
오픈소스 AI vs SaaS 결정은 두 가지 숫자에 달려 있습니다: 월 지출과 동시 요청 프로필. 인원수는 두 가지 모두의 적절한 대리 지표가 아닙니다. DoiT의 엔지니어들은 사용량 기반 Claude Code에서 개발자당 월 평균 $2,200을 지출하고 있으며, 이는 약 7~12명의 헤비 시트에서 월 $15K~$25K짜리 노드가 고려 대상이 된다는 뜻입니다. 하지만 팀에서 동시에 요청을 처리 중인 인원은 10~20%에 불과하므로, 개발자 10명은 동시 세션 2~3개에 해당하며 노드의 절반이 유휴 상태입니다.
GPU 가격을 따지기 전에, 아무도 벤치마크하지 않는 세 번째 옵션을 확인하세요: DeepInfra는 Llama-3.3-70B를 입력 $0.10 / 출력 $0.32 per million 토큰으로 제공합니다. 동일한 가중치, 여러분이 맞출 수 없는 멀티 테넌트 마진. 아래의 계산은 텍스트, 이미지, 전사(transcription), 벡터 레이어에 대해 네 번에 걸쳐 실행됩니다.
손익분기점은 지출 수준과 동시성 프로필의 문제입니다
셀프 호스팅 여부를 결정하는 숫자는 두 가지이며, 팀 규모는 그 중에 없습니다. 첫 번째는 현재 AI에 월 얼마를 지출하느냐입니다. 두 번째는 동시에 얼마나 많은 요청이 처리 중이냐입니다. 모델 선택을 포함한 모든 다른 요소는 이 두 가지의 하위 문제입니다.
모델 선택 전에 이 두 숫자가 결정합니다
GPU 노드는 풀 가동이든 새벽 3시에 유휴 상태이든 비용이 동일합니다. 이것이 전체 비교의 핵심 비대칭성입니다: SaaS는 토큰당 청구하고, 노드는 시간당 청구합니다. 따라서 핵심 질문은 월 청구 금액이 계속 사용 가능한 박스의 고정 비용을 초과했는지 여부입니다.
DoiT의 엔지니어링 팀은 사용량 기반 Claude Code Enterprise 가격에서 개발자당 월 약 $2,200을 지출하며, 이는 월 $15K~$25K의 셀프 호스팅 손익분기점이 약 7~12명의 헤비 AI 시트에서 달성된다는 것을 의미합니다. 이는 대부분의 TCO 가이드가 반복하는 "수백 명의 엔지니어가 필요하다"는 기준보다 훨씬 낮은 임계값입니다. 인원 임계값이 아니라 지출 임계값입니다. AI 어시스턴트를 거의 사용하지 않는 개발자 12명으로는 이 기준에 도달할 수 없지만, 하루 종일 에이전트를 실행하는 7명이라면 가능합니다.
동시성이 두 번째 숫자이며, 팀이 잘못 계산하는 부분입니다. DoiT의 주장은 어느 순간이든 개발자 팀의 10~20%만 요청을 처리 중이므로, 개발자 10명은 동시 세션 2~3개에 해당하며, 노드 용량의 절반에 불과하다는 것입니다. 즉, H100 8개에 비용을 지불하면서 3~4개만 사용하는 셈입니다. 피크 동시 요청 수와 목표 토큰 처리량 기준으로 계획하고, 가격을 산정하기 전에 노드 하나에 수용 가능한지 확인하세요.
'엔지니어가 50명이다'는 잘못된 트리거입니다
인원수는 1인당 사용량이 균일할 때만 지출과 상관관계가 있으며, 실제로 그런 경우는 없습니다. 8명이 코딩 에이전트를 지속적으로 실행하고 42명이 가끔 채팅을 사용하는 50인 팀은 8명의 헤비 유저 팀과 동일한 노드 요구 사항을 가지며 비용도 비슷합니다. 헤비 시트를 세어야 합니다.
디렉토리에 정리된 오픈웨이트 모델과 비교하기 전에 이 두 숫자를 먼저 확인하세요. 노드를 계속 바쁘게 유지할 수 있는지 파악한 후에 모델을 선택하세요. 프런티어보다 6포인트 뒤처진 모델은 포화 상태인 박스에서는 좋은 트레이드오프이지만, 25% 부하로 운영하는 박스에서는 비싼 실수입니다.
오픈소스 AI vs SaaS: 2026년 셀프 호스팅 비용
요율표부터 시작하세요. 이것이 조회할 수 있는 유일한 숫자입니다. 셀프 호스팅 예산의 다른 모든 항목은 스프레드시트에서 방어해야 하는 추정치입니다.
임대 GPU 요율표: 추론 가능한 실리콘에서 약 7배 차이
RunPod의 공개 가격은 H100 SXM 80GB를 Secure Cloud $3.29/hr, Community Cloud $2.69/hr, H200 141GB를 $4.59/$3.59, A100 PCIe 80GB를 $1.39/$1.19, L40S 48GB를 $0.99/$0.79, B200 180GB를 $6.79/$5.98로 책정합니다 (RunPod). 추론을 처리할 수 있는 카드 중 가장 저렴한 것과 가장 비싼 것 사이에 약 7배 차이가 납니다. 워크로드가 7B 또는 8B 모델이고 컨텍스트가 적당하다면, L40S 라인이 가격을 산정할 대상이며 대부분의 TCO 분석에서는 언급조차 되지 않습니다.
Lambda는 단일 H100 SXM 온디맨드를 $4.29/hr, 8x 노드에서 GPU당 $3.99/hr, H100 PCIe를 $3.29/hr, B200 SXM6를 $6.69~$6.99/hr로 청구합니다 (Lambda). 해당 요율의 8xH100 노드는 시간당 약 $31.92, 즉 100% 가동 시 730시간 기준 월 약 $23,300입니다. 아무도 100% 가동으로 운영하지 않는데, 바로 이것이 다음 수치의 핵심입니다.
약정 할인은 여러분이 직접 제어할 수 있는 가장 큰 단일 레버입니다. Together AI는 HGX H100 온디맨드를 GPU당 시간당 $3.99, 7일~180일 이상 예약 조건으로 $3.19~$3.69/GPU-hr로 청구합니다 (Together AI). 약 20% 할인이며, 부하에 충분히 자신이 있어 기간에 서명할 수 있을 때만 이용 가능합니다.
공급자 차이: 동일한 8xH100 월 비용이 $12,600에서 $71,800까지
DoiT는 730시간 기준 동일한 8xH100 노드 가격을 공급자별로 비교했습니다: Nebius 스팟 약 $12,600, Nebius 온디맨드 $22,500, AWS $40,200, GCP $64,100, Azure $71,800 (DoiT). 동일한 실리콘에 5.7배 차이입니다. 공급자 선택이 모델 선택보다 전환 손익 계산에 더 큰 영향을 미칩니다. 따라서 약정 지출이 있어서 하이퍼스케일러 정가 기준으로 평가를 진행한다면, 가장 불리한 버전의 셀프 호스팅을 SaaS와 비교하는 것입니다.
| 공급자 / 카드 | 시간당 요율 | 비고 |
|---|---|---|
| RunPod L40S 48GB | $0.99 / $0.79 | Secure vs Community Cloud |
| RunPod H100 SXM 80GB | $3.29 / $2.69 | Secure vs Community Cloud |
| Lambda H100 SXM (8x 노드) | GPU당 $3.99 | ~$23,300 / 730시간 월 |
| Together AI HGX H100 | 온디맨드 $3.99, 예약 $3.19–$3.69 | 7–180일 이상 조건 |
아무도 산정하지 않는 항목: 유휴 시간, 이중화, 유지보수 인건비
임대 노드는 실제 경과 시간을 기준으로 청구됩니다. API 청구서는 토큰을 추적하지만, GPU 청구서는 사용하지 않을 수도 있는 시간을 추적합니다. 트래픽이 업무 시간과 평일에 집중된다면, 730시간 중 약 168시간만 유효하게 사용하고 나머지는 낭비되므로, API 청구서와 비교하기 전에 유효 토큰 비용에 4를 곱해야 합니다. 서비스가 고객 대면이라면 두 번째 노드나 폴백 API 키를 추가하세요. 단일 노드에는 페일오버가 없습니다. vLLM을 패치하고, 모델 버전을 교체하고, KV 캐시 압력을 모니터링하고, 새벽 2시에 호출을 받는 엔지니어도 필요합니다. 머신러닝 플랫폼 디렉토리의 공급업체들이 마진을 받고 일부를 처리해 드릴 수 있으며, 이는 일반적으로 그렇지 않으면 지출하게 될 반인분 인건비보다 저렴합니다.
따라서 방어 가능한 월 금액은 다음과 같습니다: 실제 공급자 요율의 노드 시간을 실제 가동 시간으로 나누고, 이중화를 더하고, 로드된 엔지니어링 시간을 더합니다. 비교하기 전에 네 가지 모두를 실행하세요.
대부분의 셀프 호스팅 사례를 무력화하는 세 번째 옵션
오픈소스와 SaaS를 비교하는 거의 모든 글은 GPU 비용과 프런티어 API 비용을 나란히 놓고 승자를 선언합니다. 그 비교는 대부분의 팀이 선택해야 할 옵션을 건너뜁니다: 다른 누군가가 멀티 테넌트로 오픈 가중치를 실행하고 토큰당 요금을 청구합니다.
DeepInfra는 Llama-3.3-70B-Instruct-Turbo를 백만 토큰당 $0.10 입력 / $0.32 출력, Meta-Llama-3.1-8B를 $0.02/$0.04로 제공합니다 (DeepInfra). 다운로드할 수 있는 것과 동일한 체크포인트, 동일한 라이선스 조건. 차이점은 그들의 H100이 수천 명의 고객에 걸쳐 거의 최대 용량으로 운영된다는 것이고, 여러분의 것은 일요일 새벽 3시에 실제 트래픽이 어느 정도인지에 따라 다릅니다.
동일한 오픈 가중치, 다른 사람의 점유율 곡선
DeepInfra의 전용 티어와 비교하면 격차가 민망할 정도입니다. 전용 H100 80GB는 그곳에서 $2.20/hr입니다 (DeepInfra), 즉 730시간 기준 월 $1,606입니다. 출력 토큰 100만 개당 $0.32로 동일한 $1,606은 서버리스 엔드포인트에서 약 50억 개의 출력 토큰을 구매합니다. 그 달의 43,800분에 걸쳐 분산하면, 단일 H100이 가격 기준으로 API와 동등해지려면 분당 약 115,000개의 출력 토큰을 매 분 유지해야 합니다. 실제 배포에서는 그 시간의 상당 부분이 유휴 상태입니다.
단가 이외의 이유로 전용 용량을 구매합니다: 데이터 레지던시, 서드파티 보존 없음, 직접 제어하는 레이턴시 하한, 커스텀 LoRA, 아무도 호스팅하지 않는 모델. 이것들은 실제 이유입니다. 스프레드시트 이유가 아닌 조달 이유이며, 제안할 때 그렇게 명확히 말해야 합니다.
가중치 임대가 더 저렴하지 않은 시점
소규모 모델 시장은 자체적으로 붕괴되었습니다. GPT-5-nano는 백만 토큰당 $0.05/$0.40, GPT-5는 $1.25/$10.00입니다 (OpenAI), 즉 독점 모델이 이제 자체 하드웨어에서 8B 오픈 모델을 유지하는 비용보다 저렴합니다. 저렴한 오픈웨이트 API와 저렴한 독점 API가 동일한 축에서 경쟁하고 있으며, 셀프 호스팅은 둘 다에게 지고 있습니다.
벤치마크를 신중하게 선택하세요. 그것이 답을 결정합니다. Anthropic의 범위는 Fable 5.1의 백만 토큰당 $10/$50에서 Haiku 4.5의 $1/$5까지입니다 (Anthropic). 그 범위의 상단에 대해 셀프 호스팅을 벤치마크하면 저렴해 보입니다. Haiku 또는 DeepInfra의 Llama와 비교하면, GPU 노드는 비용이 아닌 제어권으로 정당화해야 합니다.
4가지 모달리티, 4가지 완전히 다른 손익분기점
전사(transcription)를 셀프 호스팅하는 팀이 텍스트 추론을 거의 셀프 호스팅하지 않는 이유는 산술 때문입니다. 각 워크로드에는 자체 SaaS 최저 가격, 자체 GPU 부하 패턴, 자체 라이선스 규칙이 있습니다. 네 가지 모두에 걸쳐 하나의 손익분기점 모델을 적용하면 세 번 잘못된 답을 얻게 됩니다.
텍스트 추론: 가장 넓고 예측하기 어려운 전환 포인트
이것이 전환 포인트가 가장 많이 변동하는 모달리티입니다. 비교하는 API 가격이 한 자릿수 차이로 다르기 때문입니다. Anthropic은 Sonnet 5에 대해 백만 입력/출력 토큰당 $2/$10, Haiku 4.5에 $1/$5를 청구합니다 (Claude 가격), OpenAI는 GPT-5-mini를 $0.25/$2.00, GPT-5-nano를 $0.05/$0.40으로 책정합니다 (OpenAI API 가격). 벤치마크 티어를 선택하면 손익분기점이 월 수억 토큰에서 수십억 토큰까지 크게 달라집니다.
DeepInfra에서 전용 H100은 $2.20/hr로 풀타임 가동 시 월 약 $1,606입니다 (DeepInfra 가격). GPT-5-nano의 혼합 요율과 비교하면 대부분의 팀이 결코 달성하지 못하는 볼륨이 필요합니다. 백만 토큰당 $10/$50인 Fable 5.1과 비교하면 (Claude 가격), 동일한 노드가 훨씬 빨리 비용을 회수합니다. 모델링하기 전에 워크로드에 필요한 티어를 결정하고, 오픈 가중치를 아직 선정 중이라면 모델 및 LLM 목록을 탐색하세요.
이미지 생성: GPU보다 라이선스가 먼저 결정합니다
여기서 GPU 계산은 쉬운 부분이고 라이선스가 함정입니다. FLUX.1 [dev] 가중치는 비상업적 라이선스로 제공된다고 널리 알려져 있으며, 이는 상업 제품과 여러분 사이에 유료 Black Forest Labs 라이선스가 있다는 것을 의미하므로, 하드웨어 예산을 세우기 전에 직접 조건을 읽어 보세요. 오픈 이미지 모델을 Midjourney와 비교하는 사람들 중 이 점을 언급하는 이는 없으며, 이것이 결정을 뒤집을 수 있는 항목입니다.
버스트한 이미지 작업이 테스트를 통과하지 못하는 이유입니다. 화요일에 일괄적으로 이미지를 생성하는 마케팅 팀은 나머지 주간 동안 카드를 유휴 상태로 두며, 유휴 시간도 사용 시간과 동일한 요율로 청구됩니다. RunPod Community Cloud에서 L40S를 $0.79/hr로 사용하면 (RunPod 가격) 안정적인 배치 작업은 기준을 충분히 충족하며, 예약된 파이프라인이 여기에 적합한 형태입니다. 디렉토리에는 727개의 이미지 생성 도구가 있으며, 라이선스 조건은 출력 품질보다 더 다양합니다.
전사(Transcription): 가장 빨리 전환되는 모달리티
실제로는 보통 그렇지 않으며, 이유는 AssemblyAI 때문입니다. OpenAI는 Whisper와 gpt-4o-transcribe에 분당 $0.006, gpt-4o-mini-transcribe에 $0.003을 청구합니다. 이는 오디오 시간당 $0.36과 $0.18입니다 (OpenAI API 가격). $0.36/시간 대비, $0.79/hr L40S는 실시간보다 빠른 배치 처리량을 가정할 때 월 수백 오디오 시간에서 손익분기점이 됩니다. 이것은 진정으로 낮은 임계값입니다. 그런 다음 AssemblyAI가 Universal-2를 $0.15/시간, Universal-3.5 Pro를 $0.21/시간으로 책정하면 (AssemblyAI 가격), 손익분기점이 2배 이상 올라갑니다.
셀프 호스팅이 여전히 명확히 이기는 곳은 스트리밍입니다. AssemblyAI는 유휴 연결 시간을 포함하여 WebSocket 세션 지속 시간당 스트리밍 요금을 청구합니다 (AssemblyAI 가격). 사람이 말하지 않는 회의에서 소켓을 열어 두면 침묵에 대해 비용을 지불하는 것입니다. 셀프 호스팅 엔드포인트는 실제 경과 시간이 아닌 GPU 초 단위로 청구합니다.
RAG와 벡터 레이어는 쿼리 볼륨에 달려 있습니다
벡터 검색 손익분기점은 월 쿼리 수로 계산되며, 통용되는 수치는 셀프 호스팅이 관리형 가격을 이기기 시작하는 약 6천만~8천만 쿼리 수준입니다. 인덱스 크기, 복제본 수, 감당할 레이턴시 예산에 따라 달라지므로 요율표가 아닌 참고 수치로 취급하세요. 그 범위 이하에서는 관리형 서비스가 급여보다 저렴하게 실행할 인덱스를 엔지니어가 관리하는 데 비용을 지불하는 셈입니다. 임베딩 생성은 별도의 계산이며, 여기서 논의된 어떤 것보다도 셀프 호스팅이 가장 저렴합니다. 모델이 작고 작업이 완벽하게 배치되기 때문입니다.
4가지 워크로드, 4가지 임계값, 한 번에 모두 이전할 이유 없음.
하드웨어 구매? 2026년 메모리 위기는 임대를 권고합니다
2026년 중반 이전에 작성된 모든 회수 계산은 더 이상 존재하지 않는 가격으로 실행됩니다. 당시 조언은 합리적이었습니다: 박스를 구매하고 3년에 걸쳐 상각하며, 14개월쯤에 임대 요율을 이깁니다. 그런 다음 메모리 시장이 붕괴되었습니다.
변경되지 않은 GPU에서 약 87% 가격 인상
NVIDIA의 RTX PRO 6000 Blackwell 96GB가 가장 명확한 사례입니다. 제품이 변경되지 않았기 때문입니다. 2025년 초 한 리테일러에서 $8,565에 등재되었고(사전 주문 최저가 $7,673), 2026년 6월에 $13,250, 2026년 8월에 $16,000에 달했습니다 (igor'sLAB). 약 18개월 만에 약 87% 상승이며, NVIDIA는 공식 설명을 발표하지 않았습니다.
이것을 2025년 스프레드시트로 계산하면 회수 월이 약 두 배가 됩니다. $12,000 올인으로 계획한 단일 카드 워크스테이션 구축이 이제 RAM도 구매하기 전에 $20,000에 가까워집니다.
HBM이 DRAM 공급을 잠식한 이유
GPU 수요는 이야기의 절반에 불과합니다. 중요한 것은 그 수요가 메모리 팹에 미친 영향입니다: HBM이 현재 글로벌 DRAM 웨이퍼 용량의 약 23%를 차지하며, 2024년의 8%에서 증가했습니다. HBM이 일반 DDR5보다 웨이퍼당 3~5배의 수익을 창출하기 때문입니다 (DatacenterDisk). 팹은 돈이 있는 곳으로 웨이퍼를 이동시켰습니다. 그 결과 서버 DDR5 ECC RDIMM 가격은 2025년 1분기에서 2026년 1분기 사이에 약 100~116% 상승했으며, GPU 주변의 호스트 메모리가 가속기만큼 타격을 받았습니다. 이를 하나의 구축에서 두 번 느끼게 됩니다: 카드와 그 아래에 있는 1TB의 시스템 RAM.
2026년에 작성된 감가상각 일정이 가정해야 할 것
이 왜곡이 구매 결정보다 오래 지속될 것이라고 가정하세요. Goldman Sachs는 2026년 5월에 연간 4.9% 글로벌 DRAM 부족, 15년 만에 가장 큰 부족분과 5.1% HBM 공급 부족을 예측했으며, 대부분의 분석가는 2027년 말 이전에 의미 있는 완화를 기대하지 않습니다 (Wccftech). 오늘 시작된 3년 감가상각 일정은 처음 2년을 공급 부족 상황에서 보냅니다.
따라서 순위 페이지에 아직 남아 있는 2025년 숫자가 아닌 2026년 8월 취득 비용으로 구매 사례를 가격 산정하고, 2년차에 저렴한 갱신을 가정하지 마세요. 숫자가 2025년 하드웨어 가격에서만 맞는다면 임대하세요. 임대는 2028년에 구매할 수 있는 옵션을 유지하는 방법입니다.
제어권과 컴플라이언스: 스프레드시트가 놓치는 부분
일부 보장은 가중치를 직접 실행해야만 얻을 수 있습니다. 팀이 셀프 호스팅 이유로 언급하는 대부분은 이제 구매할 수 있습니다.
셀프 호스팅이 실제로 제공하는 것과 제공하는 것처럼 보이는 것
자체 추론을 실행하면 어떤 계약 조항도 복제할 수 없는 네 가지를 얻습니다: 벤더의 지원 종료 일정에 따라 변경되지 않는 모델 가중치, VPC를 떠나지 않는 요청별 데이터, 다른 사람의 용량 계획에 의해 부과되는 속도 제한 없음, 허가 없이 파인튜닝하거나 양자화할 수 있는 능력. 감사 중에 모델 버전이 폐기될 것에 대한 위험 등록부 항목이 있다면, 이는 아티팩트 소유에 대한 실제 논거입니다.
셀프 호스팅이 제공하는 것처럼 보이는 것들의 목록은 더 깁니다. 데이터 레지던시, 저장 중 암호화, 데이터를 학습에 사용하지 않는다는 약속, SOC 2 증거, 감사 로그, 지역 처리: 이 모든 것들은 계약 조항과 지역 선택기로 구매할 수 있으며, 이미 꽤 오래전부터 그래왔습니다. GPU 프리미엄을 지불하는 것은 두 번 구매하는 것입니다. 이러한 논의를 이끄는 노출은 벌금 계산이며, 벌금 계산은 누가 하드웨어를 설치했는지 신경 쓰지 않습니다. 규제 기관은 2026년 초까지 2,245건의 GDPR 벌금으로 €71억을 부과했으며, GDPR 노출은 글로벌 매출의 4%, AI Act 노출은 최대 7%에 달합니다. 잘못 구성된 셀프 호스팅 모델은 호스팅된 모델만큼 빨리 감사에서 실패합니다.
2026년 규제 리셋으로 계획 마감일이 변경되었습니다
팀이 참고하는 컴플라이언스 일정의 날짜를 확인하세요. EU AI Act의 고위험 의무는 2026년 Digital Omnibus에 의해 연장되었으므로, 여러 널리 인용된 비교 페이지에서 여전히 출력하는 2026년 8월 2일 마감일은 대체되었으며, 지출 전에 현재 날짜를 직접 법무 담당자와 확인해야 합니다. 2026년 초에 그 날짜를 맞추기 위해 셀프 호스팅 예산을 승인했다면, 그 긴박감은 사라졌으며 지출에 대한 재검토가 필요합니다.
규제가 많은 수직 분야에서 가장 중요합니다. 의료 및 생명과학 AI 도구를 구매하는 팀이 이동된 마감일에 맞춰 프라이빗 배포 가격을 책정했을 가능성이 가장 높습니다.
소버린 관리형 클라우드는 중간 경로입니다
레지던시 논거는 2026년에 약해졌습니다. EU 내부에서 운영되고 관리되는 소버린 클라우드 리전은 이제 관리형 옵션으로 제공되며, 여러분이 찾을 수 있는 대부분의 오픈소스 vs SaaS 비교가 작성될 당시에는 존재하지 않았습니다. 따라서 노드 가격을 산정하기 전에 선호하는 하이퍼스케일러가 리전 내에서 제공하는 것을 확인하세요. 새벽 2시에 vLLM을 관리할 사람을 채용하지 않고도 EU 전용 데이터 처리를 받을 수 있습니다.
유지되는 순서는 다음과 같습니다. 요구사항이 레지던시라면 소버린 관리형을 구매하세요. 가중치 영속성 또는 제한 없는 파인튜닝이라면 셀프 호스팅하세요. 설문지에 "데이터가 통제 범위를 벗어나면 안 된다"는 항목이 있다면, 노드를 계약하기 전에 감사자가 무엇을 수용할지 읽어보세요.
오픈 가중치는 실제로 얼마나 뒤처져 있을까요?
4개월. 이것이 측정된 지연이며, 오픈 모델이 한 세대 뒤처진다는 기존 믿음을 대체해야 하는 숫자입니다.
4개월과 6 인덱스 포인트
Epoch AI는 2026년 1월 1일부터 5월 28일까지 Epoch Capabilities Index에서 최고의 오픈웨이트 릴리즈와 클로즈드 프런티어를 추적하여 4개월 지연, 또는 90% 신뢰 구간 7~11의 8 ECI 포인트를 측정했습니다. Artificial Analysis는 동일한 것을 다르게 측정하여 같은 결론에 도달합니다. 오픈 리더는 Intelligence Index에서 GPT-5.5의 60에 대해 52~54를 기록하며, 12개월 전에는 13포인트였던 격차가 6포인트로 좁혀졌습니다.
따라서 격차는 실재하며 좁혀지고 있습니다. 대부분의 프로덕션 워크로드(분류, 추출, 요약, 검색 강화 답변, 초고 코드)에서 4개월 된 프런티어는 충분합니다. 어려운 추론 영역에서는 그렇지 않으며, 어떤 프롬프트 작업도 8 ECI 포인트를 좁히지 못합니다. 논쟁의 어느 편을 선택하기 전에 워크로드를 선택하세요. 디렉토리에서 추적하는 오픈웨이트 릴리즈는 3월에 벤치마크한 모델이 오늘 배포할 모델이 아닐 만큼 빠르게 교체됩니다.
팀에 실제 비용을 발생시키는 도입-프로덕션 격차
오픈 모델은 능력이 아닌 출시에서 뒤집니다. 2026년 오픈소스 AI 현황 설문조사(N=1,410)에 따르면 AI 개발자의 79%가 오픈 모델을 도입하지만 프로덕션에 도달하는 것은 53%에 불과하며, 클로즈드 모델은 71% 도입에 63% 프로덕션입니다. 더 많이 시도되고 덜 출시됩니다.
이 26포인트 격차는 여러분이 지불하고 TCO 시트에 캡처하지 못하는 엔지니어링 시간입니다. 또한 규모가 커질수록 나아지는 것이 아니라 악화됩니다: 클로즈드 모델 프로덕션 비율은 소규모 회사의 54%에서 기업의 73%로 상승하지만, 오픈은 53%에서 57%로 거의 변화가 없습니다. 플랫폼 엔지니어가 가장 많은 조직이 오픈 배포를 가장 자주 포기하는데, 이는 셀프 호스팅 제안이 예측하는 것과 반대입니다. 출시되지 않는 시도에 대한 예산을 마련하세요.
마이그레이션 경로: 실제 전환에 필요한 것
전환 자체는 저렴합니다. 비용이 드는 것은 전환 전에 건너뛴 평가 작업이며, 이를 프로덕션 사고로 지불하게 됩니다.
기본 URL 교체와 언급할 가치 있는 문서화된 예외
vLLM은 OpenAI 호환 서버를 제공하므로, 일반 채팅 완성의 경우 마이그레이션은 기본 URL과 모델 별칭만 변경하면 됩니다. 기존 클라이언트를 엔드포인트로 연결하고, model을 gpt-5-mini에서 서빙 중인 것으로 변경하고, 나머지 코드는 그대로 유지합니다. 이것이 모든 경쟁사가 블랙박스로 취급하는 부분이며 솔직히 쉬운 절반입니다.
예외는 팀이 일주일을 잃는 곳입니다. 구조화된 출력과 엄격한 JSON 스키마 적용은 서빙 스택마다 다르게 동작하므로, 보장된 유효한 함수 인수에 의존하는 모든 것은 스모크 테스트가 아닌 실제 페이로드로 테스트해야 합니다. 병렬 도구 호출은 일반적인 격차입니다. 프롬프트 캐싱은 공급자별로 다르며, SaaS 측에서 캐시된 입력 요율을 가정한 비용 모델이 있다면 그 할인은 따라오지 않습니다. 장기 컨텍스트 동작은 컨텍스트 창이 광고하는 것과 다른 지점에서 저하되며, 토크나이저도 다릅니다. 이는 토큰 수 기반 예산과 절단 로직 모두 재보정이 필요하다는 의미입니다.
전환 후가 아닌 전환 전에 평가 하네스를 구축하세요
자체 트래픽의 품질을 측정할 수 없다면, 4개월 능력 지연이 사용 사례에 중요한지 여부를 알 수 없습니다. 실제 프로덕션 요청과 출력을 수백 건 캡처하고, 비즈니스에서 점수를 매기는 방식으로 점수를 매긴 다음, 후보 오픈 모델을 동일한 세트에 대해 실행하세요. GPU를 프로비저닝하기 전에 이 작업을 수행하세요.
- 이미 추적 중인 다운스트림 신호(추천, 편집, 재시도, 에스컬레이션)와 함께 실제 요청 200~500건과 응답을 로그합니다.
- 기존 SaaS 출력에 점수를 매겨 기준선을 설정합니다. 감각이 아닌 방어할 수 있는 숫자가 필요합니다.
- 먼저 API를 통해 오픈웨이트 후보를 실행합니다. DeepInfra가 Llama-3.3-70B를 백만 토큰당 $0.10 입력 / $0.32 출력으로 제공하므로 (DeepInfra) 인프라 비용 없이 테스트할 수 있습니다.
- 품질이 유지되고 볼륨이 정당화될 경우에만 전용 용량으로 이전합니다.
기본 하이브리드: 전체 교체 대신 요청 클래스별 라우팅
각 요청의 가치에 따라 트래픽을 분할합니다. 분류, 추출, 요약, 검색 재형성은 백만 토큰당 $0.02/$0.04의 8B 모델에서 잘 실행됩니다 (DeepInfra), 어려운 추론 영역은 $2/$10의 Sonnet 5로 처리합니다 (Anthropic). 호출의 80%가 저렴한 클래스에 속한다면, 단일 모델에 품질을 베팅하지 않고도 청구서의 대부분을 절감할 수 있습니다.
라우팅은 또한 전체 교체가 제공하지 않는 폴백 경로를 제공합니다. 서빙 스택과 라우터는 디렉토리의 AI 프레임워크 128개 중 상당 부분을 차지하며, 시작할 가치 있는 오픈소스 AI 레포는 OpenAI 호환 인터페이스가 있는 것들입니다. 그것이 롤백을 단일 구성 변경으로 유지하는 방법이기 때문입니다.
2026년에 전환해야 할 사람과 하지 말아야 할 사람
세 가지 프로필은 산술이 유리합니다. 세 가지는 그렇지 않으며, 플랫폼 팀의 어떤 열정도 그것을 고칠 수 없습니다.
셀프 호스팅이 명확히 이기는 세 가지 프로필
안정적인 부하의 대용량 전사(transcription). 일정에 따라 운영되는 파이프라인을 통해 월 수천 오디오 시간 이상을 처리한다면, 카드를 바쁘게 유지하고 AssemblyAI의 $0.15/시간 기준을 이길 수 있습니다 (AssemblyAI). 배치 작업이 이상적인 형태입니다. 대기열 소화 시점을 제어하므로 카드를 계속 먹이는 것이 희망이 아닌 스케줄링 문제가 됩니다.
경계를 벗어날 수 없는 규제 데이터, 요구사항이 선호가 아닌 계약적 조건인 경우. 그 경우 비용 최적화가 목표가 아닙니다. 감사 답변을 구매하는 것이며, GPU 청구서가 그 가격입니다.
사용량 기반 코딩 어시스턴트를 사용하는 50명 이상의 개발자. 약 50명의 개발자에서 청구서는 포화 상태를 유지할 수 있는 노드 대비 월 약 $110,000으로, 3~9배 프리미엄이며, 약 100명(~$220,000/월)에서는 자체 하드웨어가 약 1년 만에 회수됩니다 (DoiT).
산술만으로 뒤처지는 세 가지
약 10명 미만의 개발자 팀. 약 $22,000/월에서 어시스턴트 청구서는 10명이 바쁘게 유지할 수 없는 노드와 비슷합니다 (DoiT), 비슷한 비용은 온콜 로테이션의 가치가 없습니다.
버스트한 소비자 트래픽을 가진 팀. 유휴 GPU는 최대 요율로 청구되며, 급격한 일주기 곡선은 피크에 비용을 지불하면서 평균 약 20%만 활용한다는 의미입니다. 서버리스 오픈 모델 API가 이 프로필을 완전히 이깁니다.
품질 기준이 프런티어에 있는 팀. 백만 토큰당 $10/$50인 Fable 5.1에서만 평가를 통과한다면 (Anthropic), 셀프 호스팅 오픈 모델은 다른 품질 수준의 다른 제품이며, 절감액이 다운그레이드를 구매하는 것입니다.
자본 투입 전에 실행할 90일 테스트
- 1~2주차: 지출이 아닌 동시성을 측정합니다. 분당 처리 중인 요청을 로그하고 p95를 찾습니다. 4 미만이면 여기서 중단합니다.
- 3~6주차: 트래픽의 10%를 DeepInfra의 오픈웨이트 엔드포인트로 라우팅하고 기존 평가 스위트를 실행합니다. 대부분의 스택에서 기본 URL 변경과 모델 별칭입니다.
- 7~12주차: 구매하지 말고 임대합니다. DeepInfra에서 전용 H100 $2.20/hr (DeepInfra)는 월 $1,700 미만으로 실제 활용 수치를 제공하며, CFO가 요청할 숫자입니다.
그 결과 카드가 60% 이상 유휴 상태라면 답은 관리형 오픈웨이트 API이며, 3년간 상각하는 대신 1분기를 배워서 답을 얻은 것입니다.
자주 묻는 질문
오픈소스 AI 셀프 호스팅이 ChatGPT Business 또는 Claude Team 시트보다 실제로 더 저렴합니까?
정가 시트 가격으로는 아닙니다. Claude Team은 연간 청구 시 시트당 월 $20($25 월간), 프리미엄 시트는 $100/$125이며, Enterprise는 시트당 연간 $20에 API 요율 사용량이 추가됩니다 (Anthropic 가격). 임대 GPU는 인당 $20에 근접하지 않으므로, 정액 구독은 AI에서 자체 하드웨어로 이기기 가장 어려운 것입니다. 셀프 호스팅은 팀이 사용량 기반 청구를 사용할 때만 경쟁력이 생기며, DoiT의 엔지니어들이 개발자당 월 평균 약 $2,200을 지출하는 것처럼요 (DoiT).
2026년에 LLM 셀프 호스팅의 월 손익분기점은 얼마입니까?
사용량 기반 API 지출 월 약 $15,000~$25,000이며, DoiT의 관측된 개발자당 월 $2,200을 적용하면 약 7~12명의 헤비 시트에 해당합니다 (DoiT). 이 숫자는 모델보다 클라우드 공급자에 따라 더 크게 달라집니다: 730시간 기준 동일한 8xH100 노드가 Nebius 스팟에서 약 $12,600, Nebius 온디맨드에서 $22,500, AWS에서 $40,200, Azure에서 $71,800입니다 (DoiT). 어쨌든 인원수는 잘못된 단위입니다. 어느 순간이든 개발자 팀의 10~20%만 요청을 처리 중이므로, 개발자 10명은 동시 세션 2~3개, 최대 노드 용량의 절반에 해당합니다 (DoiT).
Whisper API의 오디오 시간당 $0.36을 이기려면 GPU 시간이 얼마나 필요합니까?
처리량이 이것을 결정하며, 시간은 청구 요율을 통해서만 중요합니다. OpenAI는 Whisper와 gpt-4o-transcribe에 분당 $0.006(오디오 시간당 $0.36), gpt-4o-mini-transcribe에 $0.003/분($0.18/시간)을 청구합니다 (OpenAI). RunPod Community Cloud의 L40S 48GB $0.79/hr에서 (RunPod) $0.36을 이기려면 실시간 대비 약 2.2배 이상의 처리량이 필요하고, 미니 티어를 이기려면 약 4.4배, AssemblyAI의 $0.15/시간 Universal-2 요율을 이기려면 약 5.3배가 필요합니다 (AssemblyAI). 유휴 GPU 시간은 불리하게 작용하므로, 배포는 버스트한 주간 트래픽이 아닌 안정적인 대기열에서만 이깁니다.
오픈소스 AI는 상업적으로 무료로 사용할 수 있습니까?
아니요, 이미지 모델이 팀이 걸려드는 곳입니다. FLUX.1 [dev] 가중치는 비상업적 라이선스를 가진 것으로 보고되어, 상업 배포와 여러분 사이에 유료 Black Forest Labs 라이선스가 있을 수 있으므로, 계획하기 전에 조건을 읽어보세요. 완전히 허용적인 가중치라도 컴퓨팅은 무료가 아닙니다: DeepInfra는 Llama-3.3-70B-Instruct-Turbo를 백만 토큰당 입력 $0.10, 출력 $0.32로, Meta-Llama-3.1-8B를 $0.02/$0.04로 제공하며 (DeepInfra), 이는 대부분의 팀이 $2.20/hr 전용 H100에서 동일한 가중치를 직접 실행하는 것보다 저렴합니다.
GDPR 및 EU AI Act를 준수하려면 셀프 호스팅을 해야 합니까?
아니요. 컴플라이언스는 데이터 위치, 처리 계약, 문서화에 관한 것이며, 어느 것도 추론 스택을 소유할 것을 요구하지 않습니다. 위험은 실재합니다(규제 기관은 2026년 초까지 2,245건의 GDPR 벌금으로 €71억을 부과했으며, 노출은 GDPR 하에서 글로벌 매출의 4%, AI Act 하에서 최대 7%에 달합니다, Kiteworks에 따르면), 하지만 EU 리전 관리형 및 소버린 호스팅 옵션이 이제 데이터 보호 담당자가 요청하는 대부분을 충족합니다. 계약이나 규제 기관이 서드파티 처리를 명시적으로 금지할 때 셀프 호스팅하세요, 일반적인 헤지로 사용하지 마세요.
2026년 메모리 부족 상황에서 GPU를 구매해야 합니까 아니면 임대해야 합니까?
카드를 계속 바쁘게 유지하는 다년간 워크로드가 없다면 임대하세요. NVIDIA의 RTX PRO 6000 Blackwell 96GB는 2025년 초 리테일러 가격 $8,565에서 2026년 6월 $13,250, 2026년 8월 $16,000으로 올라갔습니다. 변경되지 않은 제품에서 약 87% 인상입니다 (igor'sLAB). 원인은 메모리입니다: HBM은 현재 글로벌 DRAM 웨이퍼 용량의 약 23%를 차지하며, 2024년의 8% 대비 증가했고, 서버 DDR5 ECC RDIMM 가격은 2025년 1분기에서 2026년 1분기 사이에 약 100~116% 상승했습니다 (DataCenterDisk). Goldman Sachs는 2026년 4.9% DRAM 부족, 15년 만에 최대 규모를 예측했으며, 2027년 말 이전 완화를 기대하지 않습니다 (Wccftech). 따라서 높은 구매 가격을 계획하고 임대 시장의 차이를 활용하세요. DeepInfra에서 전용 H100 $2.20/hr부터 Lambda에서 $4.29/hr까지입니다.