본문으로 건너뛰기
ToolPotion
AI 어드바이저
제출 (무료)

three.dev

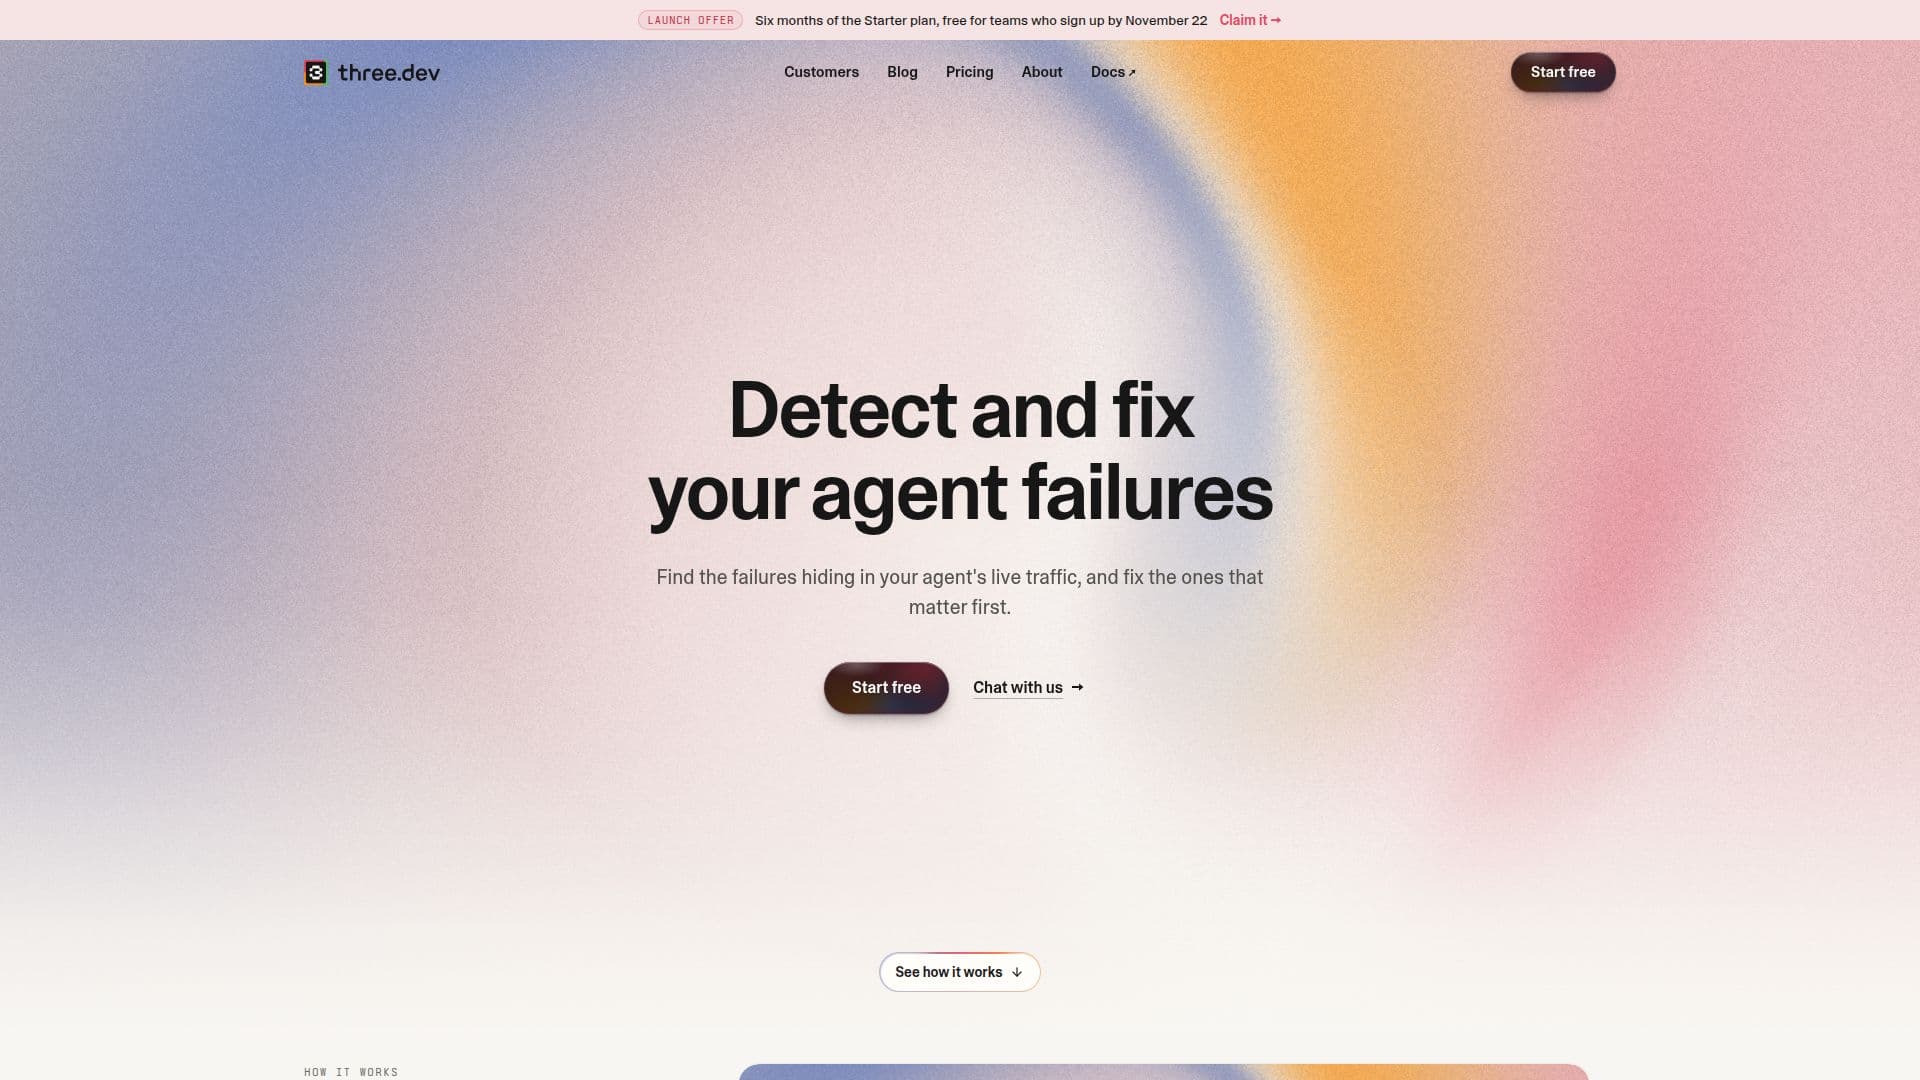
three.dev는 팀이 실시간 LLM 트래픽을 점수화하고 문제를 순위별 실패 모드로 그룹화하여 AI 에이전트의 실패를 감지하고 수정하는 데 도움을 줍니다. 이는 코딩 에이전트와 통합되어 수정을 자동화하며, 개발자가 가정이 아닌 증거를 기반으로 AI 변경 사항을 배포할 수 있도록 합니다. 이 플랫폼은 중요한 오류를 효율적으로 식별하고 해결하여 고품질 AI 기능을 보장합니다.

URL 방문
공유
three.dev 스크린샷
three.dev 스크린샷

three.dev는 개발 팀이 AI 에이전트의 실패를 감지하고 수정하는 데 도움을 주기 위해 설계된 전문 플랫폼입니다. 이 플랫폼은 AI 기능의 대규모 언어 모델(LLM) 트래픽을 기록하고, 개별 요청에 점수를 매기며, 식별된 실패를 명명된 실패 모드로 그룹화하여 작동합니다. 이러한 실패 모드는 심각도에 따라 순위가 매겨져 팀이 가장 영향력 있는 문제를 우선적으로 해결할 수 있도록 합니다.

더 읽기

이 플랫폼은 기존 개발 워크플로우에 원활하게 통합됩니다. 사용자는 단일 프롬프트로 three.dev를 설정할 수 있으며, 이를 통해 코딩 에이전트가 필요한 기술을 설치하고 LLM 호출을 three.dev 프록스를 통해 라우팅할 수 있습니다. 이 프록스는 요청을 AI 제공자에게 전달하면서 동시에 응답을 three.dev의 평가자에게 전송하여 점수가 애플리케이션 성능에 지연을 추가하지 않도록 보장합니다. 충분한 실패가 축적되면 three.dev는 이를 자동으로 그룹화하여 잘못된 환불 기간이나 무시된 언어 요청과 같은 일반적인 문제에 대한 명확한 통찰력을 제공합니다.

three.dev의 주요 기능 중 하나는 증거 기반 문제를 제공하는 능력입니다. 식별된 모든 문제는 시스템 프롬프트의 특정 줄이나 대화 내 메시지까지 정확히 어디에서 잘못되었는지를 인용합니다. 이러한 정밀성 덕분에 MCP(Managed Code Platform)를 통해 통합된 코딩 에이전트가 이러한 문제를 자동으로 수정할 수 있습니다. 예를 들어, 에이전트가 잘못된 환불 기간을 제공하는 경우, three.dev는 충돌하는 코드를 정확히 찾아내고 수정 사항을 제안할 수 있습니다. 예를 들어, 하드코딩된 14일 환불 기간이 30일 정책에 맞게 업데이트된 사례가 있습니다.

three.dev는 또한 강력한 실험을 지원합니다. 팀은 과거 트래픽을 재생하여 새로운 에이전트 버전(v4)을 기록된 요청에 대해 테스트할 수 있으며, 이는 실시간 사용자에게 영향을 미치지 않으면서 실패율의 변화를 관찰할 수 있습니다. 더 고급 테스트를 위해, 실제 세션을 나누어 일부 실시간 사용자가 새로운 버전과 상호작용하도록 하여 품질 및 비즈니스 메트릭을 비교할 수 있습니다. 이러한 접근 방식은 팀이 증거를 기반으로 변경 사항을 배포할 수 있도록 하여 전체 배포 전에 개선 사항을 보장합니다. 이 플랫폼은 특정 트래픽에 대해 훈련된 전문 언어 모델(SLM)의 개발도 지원하며, 이는 특정 사용 사례에 대해 품질, 지연 및 비용에서 최전선 모델을 초월할 수 있습니다.

three.dev의 가격은 무료 플랜, 월 $79의 스타터 플랜, 월 $249의 프로 플랜이 있으며, 맞춤형 요구를 위한 엔터프라이즈 옵션도 제공됩니다. 모든 플랜에는 점수 매기기와 무제한 좌석이 포함됩니다. 무료 플랜은 월 0.1GB의 처리된 데이터와 5,000개의 점수화된 요청을 제공합니다. 스타터 플랜은 이를 5GB의 데이터와 10,000개의 점수화된 요청으로 증가시키며, 프로 플랜은 20GB의 데이터와 25,000개의 점수화된 요청을 제공합니다. 추가 사용량은 데이터 GB당 및 1,000개의 점수화된 요청당 요금이 부과됩니다. 이 플랫폼은 플랜 한도를 초과하더라도 트래픽이 차단되지 않도록 보장하며, 단순히 다음 청구 주기까지 요청의 기록 또는 점수를 중단합니다. 데이터는 미국에 저장되며, 전송 중 암호화되고, 제공자 키는 휴지 상태에서 암호화됩니다. three.dev는 고객을 제외한 누구에게도 고객 트래픽을 훈련하지 않으며, 데이터 프라이버시와 보안을 보장합니다.

  • 카테고리AI 코드 리뷰 및 테스트
  • 요금제프리미엄
  • 배포클라우드
  • 플랫폼웹

  • LLM 트래픽 기록: AI 기능의 실시간 LLM 트래픽을 기록합니다.

  • 요청 점수 매기기: 성능 및 정확성을 위해 개별 LLM 요청에 점수를 매깁니다.

  • 실패 모드 그룹화: 식별된 실패를 심각도에 따라 순위가 매겨진 명명된 카테고리로 그룹화합니다.

  • 증거 기반 문제: 오류의 정확한 출처를 특정 프롬프트 줄까지 정확히 지적합니다.

  • 코딩 에이전트 통합: 코딩 에이전트를 위한 MCP 통합을 통해 자동 수정을 촉진합니다.

  • 실시간 대화 분석: 실시간 대화를 분석하여 에이전트의 실패를 식별합니다.

  • 수정 전후 비교: 수정 전후의 에이전트 성능을 비교합니다.

  • 트래픽 재생: 기록된 과거 트래픽에서 새로운 에이전트 버전을 테스트할 수 있습니다.

  • 실시간 세션 실험: 실시간 사용자 일부와의 A/B 테스트를 통해 에이전트 변경 사항을 실험합니다.

  • 전문 언어 모델(SLM) 훈련: 특정 트래픽에 대해 훈련된 맞춤형 모델 구축을 지원합니다.

  • 채팅 인터페이스: 트래픽 및 실패에 대해 자연어로 질문할 수 있습니다.

  • 무제한 좌석: 모든 플랜에는 팀 협업을 위한 무제한 사용자 좌석이 포함됩니다.

  • 데이터 암호화: TLS 1.2+로 전송 중 트래픽을 암호화하고, AES-256-GCM으로 휴지 상태에서 제공자 키를 암호화합니다.

  • 고객 데이터에 대한 훈련 없음: 고객 트래픽이 일반 모델 훈련에 사용되지 않도록 보장합니다.

  • 사용자 정의 가능한 실패 모드: 팀의 정신 모델에 맞게 실패 모드를 재구성할 수 있습니다.

  1. 설정: 에이전트(Claude Code, Codex 또는 Cursor)에 단일 프롬프트를 붙여넣어 three.dev 기술을 설치하고 코드에 통합합니다.

  2. 트래픽 라우팅: 앱의 LLM 요청이 three.dev 프록스를 통해 AI 제공자에게 전달되며, 응답은 동시에 평가자에게 전송됩니다.

  3. 실패 모니터링: three.dev는 요청을 기록하고 점수를 매기며, 수집되는 대로 실패를 순위가 매겨진 실패 모드로 그룹화합니다.

  4. 문제 분석: 증거와 함께 자세한 실패 모드를 읽어 에이전트가 잘못된 이유와 위치를 보여줍니다.

  5. 실패 수정: MCP 통합을 사용하여 상위 실패 모드를 코딩 에이전트에 전달하여 자동 수정을 수행합니다.

  6. 안전한 실험: 기록된 트래픽이나 실시간 세션의 일부에서 변경 사항을 테스트하여 전체 배포 전에 개선 사항을 검증합니다.

  7. 성능 최적화: 실패 분석 및 실험에서 얻은 통찰력을 활용하여 에이전트 품질 및 비즈니스 메트릭을 지속적으로 개선합니다.

  • AI 에이전트 품질 보증
  • 자동 버그 수정
  • LLM 성능 모니터링
  • 증거 기반 AI 개발
  • 맞춤형 LLM 훈련
  • 사전 실패 감지
  • 대화 분석
  • AI 에이전트 A/B 테스트
  • 개발자 워크플로우 통합

three.dev 리뷰

로딩 중...

three.dev와(과) 비슷한 인기 AI 도구

체크섬은 엔드 투 엔드 테스트의 생성, 실행 및 유지 관리를 자동화하여 팀이 자신 있게 코드를 배포할 수 있도록 합니다. 70%의 실패가 자율적으로 해결되어 엔지니어의 개입 필요성을 줄이고, 팀이 유지 관리보다는 구축에 집중할 수 있도록 합니다.

AI 코드 리뷰 및 테스트

AI 코드 리뷰 및 테스트 48위

도구 보기

엔드 투 엔드 테스트의 생성, 실행 및 유지 관리를 자동화하여 팀이 자신 있게 코드를 배포할 수 있도록 합니다. 70%의 실패가 자율적으로 해결되어 엔지니어의 개입 필요성을 줄이고, 팀이 유지 관리보다는 구축에 집중할 수 있도록 합니다.체크섬은 엔드 투 엔드 테스트의 생성, 실행 및 유지 관리를 자동화하여 팀이 자신 있게 코드를 배포할 수 있도록 합니다. 70%의 실패가 자율적으로 해결되어 엔지니어의 개입 필요성을 줄이고, 팀이 유지 관리보다는 구축에 집중할 수 있도록 합니다.

AI 코드 리뷰 및 테스트
AI 코드 리뷰 및 테스트 48위

LangWatch

AI 앱

LangWatch는 AI 에이전트 테스트, LLM 평가 및 관찰 가능성 플랫폼입니다. 개발자가 실제 시나리오를 시뮬레이션하고, 회귀를 방지하며, 프로덕션 추적을 평가로 전환하여 문제를 디버깅할 수 있도록 지원합니다. 배포 전에 프롬프트, 모델 및 에이전트를 테스트하여 모든 릴리스에서 AI 품질을 개선하세요.

MLOps 및 모델 배포

프롬프트 엔지니어링 도구 14위

도구 보기

AI 앱

AI 에이전트 테스트, LLM 평가 및 관찰 가능성 플랫폼입니다. 개발자가 실제 시나리오를 시뮬레이션하고, 회귀를 방지하며, 프로덕션 추적을 평가로 전환하여 문제를 디버깅할 수 있도록 지원합니다. 배포 전에 프롬프트, 모델 및 에이전트를 테스트하여 모든 릴리스에서 AI 품질을 개선하세요.LangWatch는 AI 에이전트 테스트, LLM 평가 및 관찰 가능성 플랫폼입니다. 개발자가 실제 시나리오를 시뮬레이션하고, 회귀를 방지하며, 프로덕션 추적을 평가로 전환하여 문제를 디버깅할 수 있도록 지원합니다. 배포 전에 프롬프트, 모델 및 에이전트를 테스트하여 모든 릴리스에서 AI 품질을 개선하세요.

추천MLOps 및 모델 배포
프롬프트 엔지니어링 도구 14위

evalship

AI 앱

evalship은 LLM 평가에 대한 품질 관리를 제공하며, 결함을 식별하고 프롬프트 및 모델을 최적화합니다. 기존 평가 프레임워크와 통합되며, 무엇이 잘못되었는지와 그 이유에 대한 상세한 분석을 포함한 댓글을 풀 리퀘스트에 달고, AI 호출이 철저히 테스트되도록 돕습니다. 이 플랫폼은 LLM 평가를 자동화하여 신뢰성과…

AI 코드 리뷰 및 테스트

AI 모델 미세 조정 140위

도구 보기

AI 앱

LLM 평가에 대한 품질 관리를 제공하며, 결함을 식별하고 프롬프트 및 모델을 최적화합니다. 기존 평가 프레임워크와 통합되며, 무엇이 잘못되었는지와 그 이유에 대한 상세한 분석을 포함한 댓글을 풀 리퀘스트에 달고, AI 호출이 철저히 테스트되도록 돕습니다. 이 플랫폼은 LLM 평가를 자동화하여 신뢰성과…evalship은 LLM 평가에 대한 품질 관리를 제공하며, 결함을 식별하고 프롬프트 및 모델을 최적화합니다. 기존 평가 프레임워크와 통합되며, 무엇이 잘못되었는지와 그 이유에 대한 상세한 분석을 포함한 댓글을 풀 리퀘스트에 달고, AI 호출이 철저히 테스트되도록 돕습니다. 이 플랫폼은 LLM 평가를 자동화하여 신뢰성과…

AI 코드 리뷰 및 테스트
AI 모델 미세 조정 140위

AI CodeOps는 AI 에이전트를 사용하여 코드를 계획, 구축, 검토, 테스트 및 배포하는 브라우저 기반 플랫폼입니다. 자동화된 검사와 인간의 승인을 통해 코드 품질을 보장하며, 모든 품질 기준이 통과될 때까지 병합을 방지합니다. 이 플랫폼은 다양한 Git 호스트를 지원하며 비용 관리를 제공하여 개인 개발자와…

AI 코드 리뷰 및 테스트

AI 코드 리뷰 및 테스트 237위

도구 보기

AI 에이전트를 사용하여 코드를 계획, 구축, 검토, 테스트 및 배포하는 브라우저 기반 플랫폼입니다. 자동화된 검사와 인간의 승인을 통해 코드 품질을 보장하며, 모든 품질 기준이 통과될 때까지 병합을 방지합니다. 이 플랫폼은 다양한 Git 호스트를 지원하며 비용 관리를 제공하여 개인 개발자와…AI CodeOps는 AI 에이전트를 사용하여 코드를 계획, 구축, 검토, 테스트 및 배포하는 브라우저 기반 플랫폼입니다. 자동화된 검사와 인간의 승인을 통해 코드 품질을 보장하며, 모든 품질 기준이 통과될 때까지 병합을 방지합니다. 이 플랫폼은 다양한 Git 호스트를 지원하며 비용 관리를 제공하여 개인 개발자와…

AI 코드 리뷰 및 테스트
AI 코드 리뷰 및 테스트 237위

Raindrop

AI 앱

Raindrop는 AI 에이전트를 위한 가시성 및 모니터링 플랫폼으로, 모든 프로덕션 실행을 캡처하고, 환각 및 루프와 같은 침묵의 실패를 자동으로 감지하며, 팀이 문제를 추적하고, 분류하고, 수정 사항을 입증할 수 있도록 합니다.

MLOps 및 모델 배포

MLOps 및 모델 배포 41위

도구 보기

AI 앱

AI 에이전트를 위한 가시성 및 모니터링 플랫폼으로, 모든 프로덕션 실행을 캡처하고, 환각 및 루프와 같은 침묵의 실패를 자동으로 감지하며, 팀이 문제를 추적하고, 분류하고, 수정 사항을 입증할 수 있도록 합니다.Raindrop는 AI 에이전트를 위한 가시성 및 모니터링 플랫폼으로, 모든 프로덕션 실행을 캡처하고, 환각 및 루프와 같은 침묵의 실패를 자동으로 감지하며, 팀이 문제를 추적하고, 분류하고, 수정 사항을 입증할 수 있도록 합니다.

MLOps 및 모델 배포
MLOps 및 모델 배포 41위

Latitude

AI 앱

생산 환경에서 에이전트를 추적하고, 실패를 드러내며, 이를 자동으로 수정하는 코딩 에이전트를 배치하는 오픈 소스 AI 에이전트 가시성 및 모니터링 플랫폼입니다.

MLOps 및 모델 배포

프롬프트 엔지니어링 도구 43위

도구 보기

AI 앱

생산 환경에서 에이전트를 추적하고, 실패를 드러내며, 이를 자동으로 수정하는 코딩 에이전트를 배치하는 오픈 소스 AI 에이전트 가시성 및 모니터링 플랫폼입니다.

추천MLOps 및 모델 배포
프롬프트 엔지니어링 도구 43위

Resolve.ai는 경고를 관리하고, 근본 원인 분석을 수행하며, 사건을 신속하게 해결하는 AI 기반 플랫폼으로, 엔지니어들이 소프트웨어 개발에 집중할 수 있도록 합니다. 이는 운영 효율성과 생산 환경에서의 사건 대응을 향상시킵니다.

AI DevOps 및 클라우드 도구

CTO들 19위

도구 보기

경고를 관리하고, 근본 원인 분석을 수행하며, 사건을 신속하게 해결하는 AI 기반 플랫폼으로, 엔지니어들이 소프트웨어 개발에 집중할 수 있도록 합니다. 이는 운영 효율성과 생산 환경에서의 사건 대응을 향상시킵니다.Resolve.ai는 경고를 관리하고, 근본 원인 분석을 수행하며, 사건을 신속하게 해결하는 AI 기반 플랫폼으로, 엔지니어들이 소프트웨어 개발에 집중할 수 있도록 합니다. 이는 운영 효율성과 생산 환경에서의 사건 대응을 향상시킵니다.

AI DevOps 및 클라우드 도구
CTO들 19위

HoneyHive

AI 앱

HoneyHive는 프로덕션 AI 에이전트를 위한 관찰 가능성 계층을 제공하여 모니터링 및 평가를 통합합니다. 이를 통해 지속적인 개선 루프를 활성화하여 팀이 품질 높은 에이전트를 자신 있게 출시할 수 있습니다. 이 플랫폼은 확장 가능한 에이전트 동작 모니터링을 위한 분산 추적, 온라인 평가, 세션 재생 및 알림을…

MLOps 및 모델 배포

프롬프트 엔지니어들 32위

도구 보기

AI 앱

프로덕션 AI 에이전트를 위한 관찰 가능성 계층을 제공하여 모니터링 및 평가를 통합합니다. 이를 통해 지속적인 개선 루프를 활성화하여 팀이 품질 높은 에이전트를 자신 있게 출시할 수 있습니다. 이 플랫폼은 확장 가능한 에이전트 동작 모니터링을 위한 분산 추적, 온라인 평가, 세션 재생 및 알림을…HoneyHive는 프로덕션 AI 에이전트를 위한 관찰 가능성 계층을 제공하여 모니터링 및 평가를 통합합니다. 이를 통해 지속적인 개선 루프를 활성화하여 팀이 품질 높은 에이전트를 자신 있게 출시할 수 있습니다. 이 플랫폼은 확장 가능한 에이전트 동작 모니터링을 위한 분산 추적, 온라인 평가, 세션 재생 및 알림을…

추천MLOps 및 모델 배포
프롬프트 엔지니어들 32위
1/8