설명
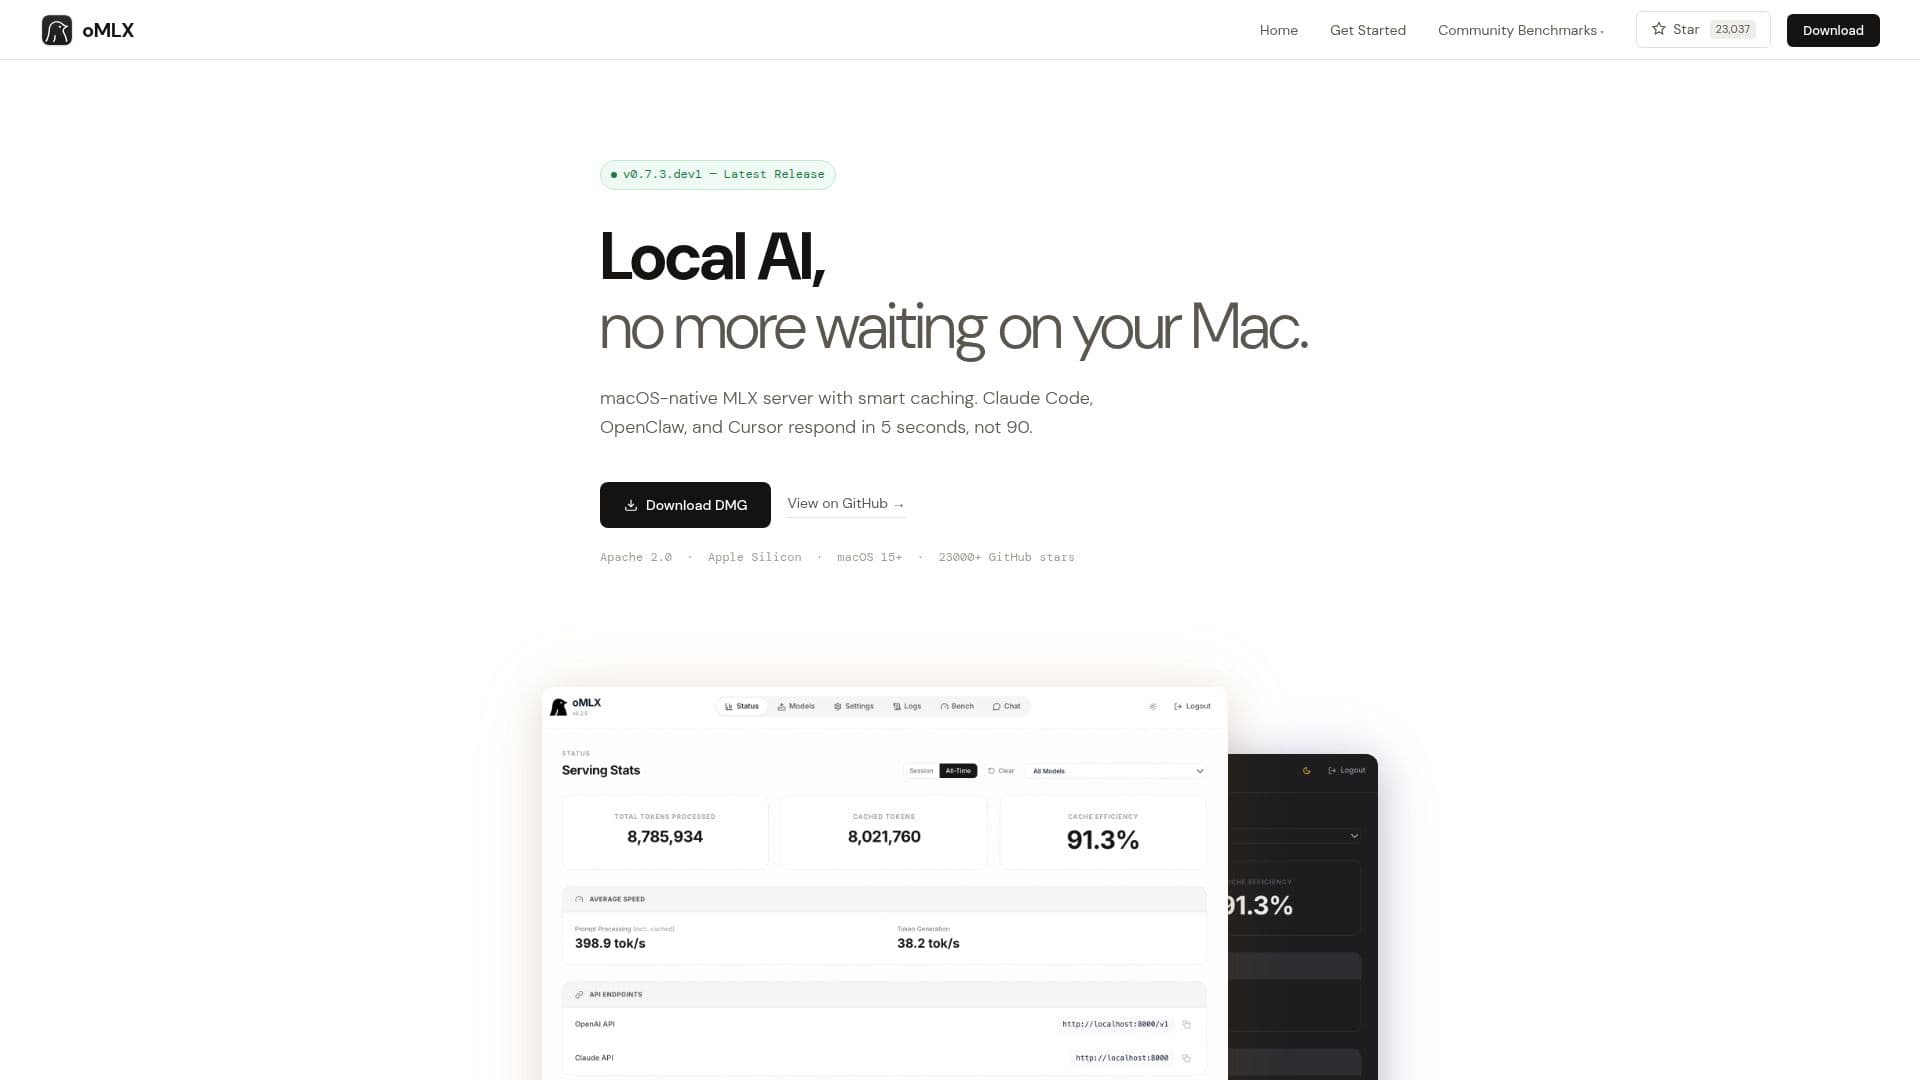
oMLX는 macOS를 위해 특별히 설계된 최첨단 추론 서버로, Apple Silicon의 성능을 활용합니다. MLX 프레임워크를 기반으로 구축되어 Mac 컴퓨터에서 대형 언어 모델(LLM)을 로컬로 실행하기 위한 네이티브 솔루션을 제공합니다. 이 서버의 두드러진 기능 중 하나는 페이지 SSD KV 캐싱으로, 일반적으로 30-90초 걸리는 첫 번째 토큰까지의 시간(TTFT)을 5초 이하로 대폭 줄입니다. 이 개선은 캐시를 자주 무효화하는 코딩 에이전트에 특히 유용하며, oMLX는 모든 캐시 블록을 SSD에 지속적으로 저장하여 디스크에서 빠르게 복원할 수 있도록 합니다.
더 읽기
서버는 OpenAI 및 Anthropic과 같은 인기 API와 호환되어 이러한 플랫폼에서 작업하는 개발자에게 다재다능한 도구가 됩니다. 연속 배치 처리를 지원하며 Claude Code, OpenClaw 및 Cursor와 같은 모델에 대한 드롭인 API를 제공하여 응답을 몇 초 만에 전달합니다. 512GB RAM을 장착한 M3 Ultra에서 수행된 성능 벤치마크는 다양한 맥락과 배치 크기에서 인상적인 처리량과 메모리 효율성을 보여줍니다.
oMLX는 Mac에서 신뢰할 수 있고 빠른 로컬 AI 솔루션이 필요한 개발자와 AI 애호가를 위해 설계되었습니다. 클라우드 기반 추론의 필요성을 없애고 지연 시간과 외부 서버에 대한 의존성을 줄입니다. 이 도구는 Apache 2.0 라이선스 하에 오픈 소스이며, 23,000개 이상의 GitHub 스타를 통해 강력한 커뮤니티 존재감을 보여줍니다. 사용자는 DMG를 다운로드하거나 소스에서 설치하여 쉽게 시작할 수 있으며, 표준 Hugging Face 캐시 및 LM Studio 폴더와의 호환성을 제공합니다.
전반적으로 oMLX는 macOS에서 AI 모델을 로컬로 실행하기 위한 강력하고 효율적인 솔루션을 제공하며, 속도 개선과 기존 AI 워크플로와의 원활한 통합을 제공합니다.
- 카테고리MLOps 및 모델 배포
- 요금제오픈소스
- 배포로컬
- 플랫폼macOS 15+
oMLX의 핵심 기능
네이티브 macOS 추론 서버
페이지 SSD KV 캐싱
OpenAI 및 Anthropic API 호환성
연속 배치 처리 지원
Claude Code, OpenClaw 및 Cursor를 위한 드롭인 API
SSD에서 빠른 캐시 복원
Apache 2.0 라이선스 하에 오픈 소스
23,000개 이상의 GitHub 스타
oMLX 사용 방법은?
다운로드: DMG 또는 소스 가져오기
설치: 설치 지침 따르기
구성: Hugging Face 캐시로 설정하기
사용: TTFT를 줄여 모델 실행하기
최적화: 연속 배치 활용하기
oMLX의 사용 사례
- 로컬 AI 개발
- API 통합
- 코딩 에이전트
- 배치 처리
- 오픈 소스 기여