본문으로 건너뛰기
ToolPotion
AI 어드바이저
제출 (무료)

Linum P-JiT

AI 앱AI 모델 및 LLM오픈소스 · 웹

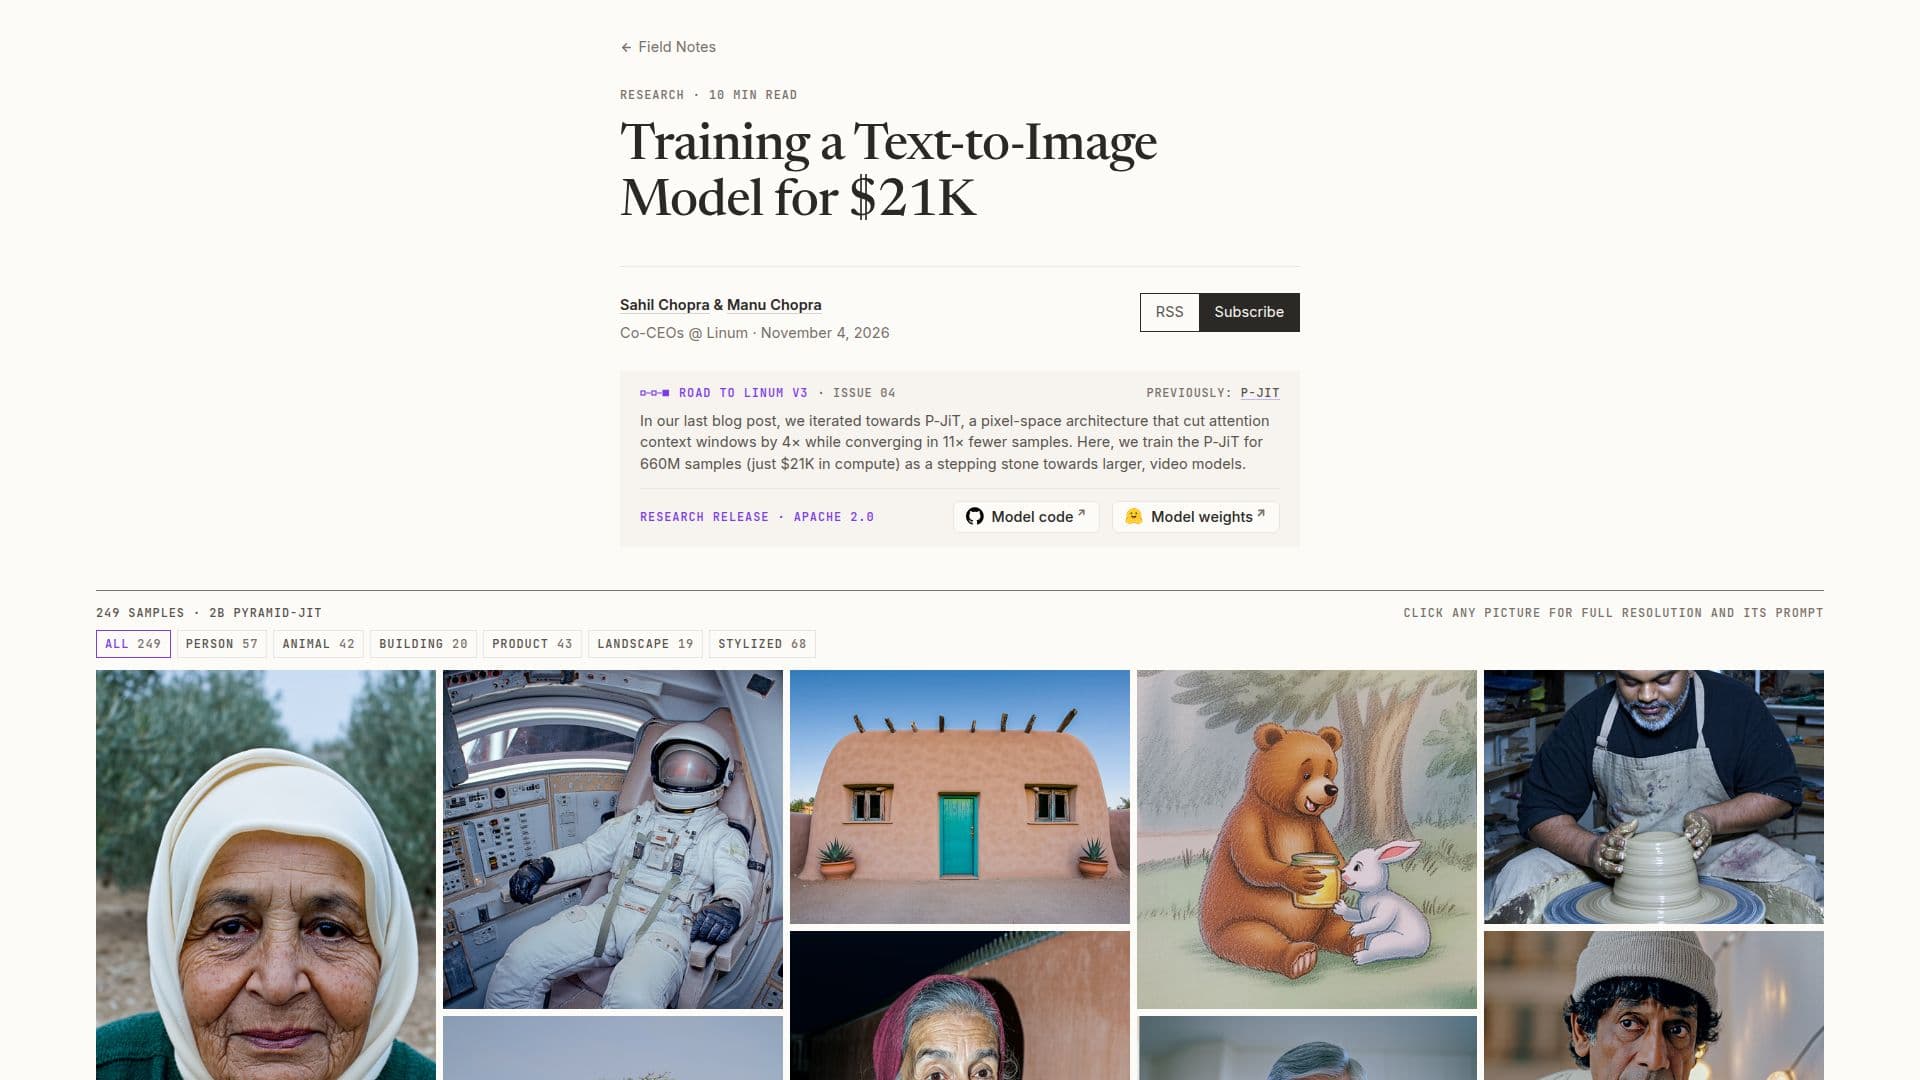
Linum P-JiT는 생성 비디오 모델에 집중하는 두 사람 연구실 Linum이 개발한 실험적인 2B-파라미터 텍스트-이미지 모델입니다. 이 개념 증명 모델은 새로운 Pyramid-JiT 아키텍처를 보여주며, 약 $21K의 상당히 낮은 훈련 비용으로 고품질 이미지 생성을 달성합니다. 이는 애니메이션을 위한 보다 효율적이고 접근 가능한 창작 도구로 나아가는 한 걸음을 나타냅니다.

URL 방문
공유
Linum P-JiT 스크린샷
Linum P-JiT 스크린샷

Linum P-JiT는 생성 비디오 모델을 처음부터 훈련하는 데 전념하는 두 사람 연구실 Linum이 개발한 실험적인 텍스트-이미지 모델입니다. 이 특정 모델인 2B-파라미터 Pyramid-JiT (P-JiT)는 비용 효율적이고 제어 가능한 생성 도구를 통해 애니메이션 접근을 민주화하려는 지속적인 연구의 개념 증명 역할을 합니다. 이 모델의 훈련 비용은 약 $21,038로, 상대적으로 낮은 계산 비용으로 고품질 결과를 얻을 수 있는 가능성을 보여줍니다.

더 읽기

P-JiT의 핵심 혁신은 전통적인 변분 오토인코더(VAE)를 확산 모델 아키텍처에서 제거하여 더 공격적인 압축과 빠른 학습을 달성하는 능력입니다. 대신, 확산 모델은 사용 사례에 맞게 특별히 설계된 잠재 공간을 학습하여 더 큰 압축과 개선된 생성을 가능하게 합니다. 이 픽셀 공간 모델은 Linum v2보다 11배 적은 샘플로 수렴하며, 256x256 이미지에 사용된 것과 동일한 수의 토큰으로 512x512 이미지를 나타내는 4배 더 공격적인 토큰 감소를 제공합니다. 이는 주의 컨텍스트 창을 4배 줄여 훈련 및 추론 비용을 크게 절감합니다.

P-JiT 아키텍처는 텍스트 및 이미지 처리 파이프라인을 통합하여 각 모달리티가 단일 모달리티 "정제기" DiT 블록을 통과한 후 22개의 동일한 DiT 블록 스트림으로 병합됩니다. 텍스트 표현은 고정된 Qwen3.5-4B 모델에서 파생되며, 이미지는 32x32 패치로 분할되어 1024차원 공간으로 압축됩니다. 이 모델은 또한 DINOv3-L에 정렬된 PixelREPA 출력과 수렴을 가속화하기 위해 최종 이미지의 저해상도 버전을 예측하는 추가 선형 출력 헤드를 특징으로 합니다.

훈련은 여러 단계로 진행되었으며, 610백만 샘플에 대해 512x512 해상도에서 시작한 후 50백만 샘플에 대해 1024x1024 해상도로 전환되었습니다. 기본 구조를 학습하기 위해 처음에는 높은 노이즈에 집중하고, 세부 사항을 위해 분포를 넓히는 커리큘럼 노이즈 스케줄이 사용되었습니다. 훈련 후에는 JEV-Image와 인간이 포함된 평가자를 사용한 유한 차분 흐름 최적화(FDFO)의 변형이 포함되었습니다. 모델은 유망한 결과를 보여주지만, 전체 신체 생성, 여러 개체, 다인 상호작용 및 세계 지식과 관련하여 한계가 있으며, 이는 이 크기의 모델에서 일반적입니다. 렌더링된 텍스트 이미지로 훈련되지 않았기 때문에 텍스트나 포스터를 생성할 수 없습니다.

  • 카테고리AI 모델 및 LLM
  • 요금제오픈소스
  • 배포클라우드
  • 플랫폼웹

  • Pyramid-JiT (P-JiT) 아키텍처: 효율적인 생성을 위한 새로운 픽셀 공간 모델

  • 2B-파라미터 DiT: 핵심 확산 변환기 모델 크기

  • 4B 텍스트 인코더: 텍스트 표현을 위해 고정된 Qwen3.5-4B 모델을 활용

  • VAE 없는 설계: 더 공격적인 압축과 빠른 학습을 위해 VAE 제거

  • 4배 토큰 감소: Linum v2보다 4배 적은 토큰으로 512x512 이미지 표현

  • 11배 빠른 수렴: 훨씬 적은 훈련 샘플로 결과 달성

  • 다단계 훈련: 512x512에서 1024x1024 해상도로 진행

  • 커리큘럼 노이즈 스케줄: 구조 및 세부 사항 학습을 위한 노이즈 분포 조정

  • PixelREPA 출력: 개선된 세부 사항 학습을 위해 DINOv3-L에 잠재 공간 정렬

  • 선형 출력 헤드: 수렴 가속화를 위해 1/4 및 1/2 해상도에서 깨끗한 이미지 예측

  • 유한 차분 흐름 최적화(FDFO): 훈련 후 정제를 위해 사용

  • Apache 2.0 라이센스: 가중치는 오픈 소스 라이센스 하에 공개됨

  • 비용 효율적인 훈련: 약 $21K로 고품질 결과 달성

  • 생성 비디오 연구에 집중: 미래 비디오 모델을 향한 한 걸음

  1. 아키텍처 이해: 텍스트 및 이미지 처리 흐름을 포함한 P-JiT 아키텍처 세부 사항 검토.

  2. 훈련 체계 검토: 다단계 훈련 과정, 노이즈 스케줄 및 해상도 전환에 대해 알아보기.

  3. 모델 한계 탐색: 전체 신체 생성, 여러 개체 및 텍스트 생성과 관련된 현재 한계 이해.

  4. 훈련 설정 접근: 부록 A에서 상세한 훈련 매개변수 및 구성 참조.

  5. 비용 분석: 훈련 전후의 계산 비용 내역 보기.

  6. 예제 실패 분석: 제공된 모델 실패 예제를 연구하여 현재 능력 및 개선 영역 파악.

  • 텍스트-이미지 생성 연구
  • 비용 효율적인 모델 훈련
  • 생성 비디오 모델 개발
  • 아키텍처 혁신 테스트
  • 오픈 소스 AI 실험

Linum P-JiT 리뷰

로딩 중...

Linum P-JiT와(과) 비슷한 인기 AI 도구

Wan 2.2

AI 앱

알리바바의 Tongyi Lab에서 개발한 오픈 소스 Mixture-of-Experts 비디오 생성 모델로, 텍스트-비디오 및 이미지-비디오 생성이 가능하며 최대 720p 해상도, 영화 같은 제어 및 다운로드 가능한 모델 가중치를 제공합니다.

AI 동영상 생성기미디어 및 엔터테인먼트

AI 동영상 생성기 188위

도구 보기

AI 앱

알리바바의 Tongyi Lab에서 개발한 오픈 소스 Mixture-of-Experts 비디오 생성 모델로, 텍스트-비디오 및 이미지-비디오 생성이 가능하며 최대 720p 해상도, 영화 같은 제어 및 다운로드 가능한 모델 가중치를 제공합니다.

AI 동영상 생성기미디어 및 엔터테인먼트
AI 동영상 생성기 188위

생성적 AI 클라우드는 이미지, 비디오 및 오디오 생성에 대한 500개 이상의 모델에 대한 접근을 제공합니다. 통합 API, 낮은 비용 및 즉시 모델 접근을 통해 더 빠르고 원활한 창작 워크플로우를 지원합니다.

머신러닝 플랫폼미디어 및 엔터테인먼트
도구 보기

이미지, 비디오 및 오디오 생성에 대한 500개 이상의 모델에 대한 접근을 제공합니다. 통합 API, 낮은 비용 및 즉시 모델 접근을 통해 더 빠르고 원활한 창작 워크플로우를 지원합니다.생성적 AI 클라우드는 이미지, 비디오 및 오디오 생성에 대한 500개 이상의 모델에 대한 접근을 제공합니다. 통합 API, 낮은 비용 및 즉시 모델 접근을 통해 더 빠르고 원활한 창작 워크플로우를 지원합니다.

머신러닝 플랫폼미디어 및 엔터테인먼트
AI 앱 TOP 250 보기

HunyuanImage 3.0은 이미지 생성을 위해 설계된 강력한 네이티브 멀티모달 모델입니다. 텍스트-투-이미지 및 이미지-투-이미지 작업 모두에서 뛰어난 성능을 발휘하며, 창의적인 편집 및 지능형 프롬프트 향상을 위한 고급 기능을 제공합니다.

AI 모델 및 LLM
도구 보기

이미지 생성을 위해 설계된 강력한 네이티브 멀티모달 모델입니다. 텍스트-투-이미지 및 이미지-투-이미지 작업 모두에서 뛰어난 성능을 발휘하며, 창의적인 편집 및 지능형 프롬프트 향상을 위한 고급 기능을 제공합니다.HunyuanImage 3.0은 이미지 생성을 위해 설계된 강력한 네이티브 멀티모달 모델입니다. 텍스트-투-이미지 및 이미지-투-이미지 작업 모두에서 뛰어난 성능을 발휘하며, 창의적인 편집 및 지능형 프롬프트 향상을 위한 고급 기능을 제공합니다.

추천AI 모델 및 LLM
AI 모델 TOP 5 보기

FluxPicture는 FLUX AI를 통해 다양한 이미지 스타일과 사실적인 결과물을 제공하는 무료 AI 이미지 및 비디오 생성기를 제공합니다. 또한 고품질 이미지 생성을 위한 Krea와 비디오 생성을 위한 Wan 2.2를 포함하여 사용자가 텍스트 프롬프트로 멋진 비주얼을 만들 수 있도록 지원합니다.

AI 이미지 생성기
도구 보기

FLUX AI를 통해 다양한 이미지 스타일과 사실적인 결과물을 제공하는 무료 AI 이미지 및 비디오 생성기를 제공합니다. 또한 고품질 이미지 생성을 위한 Krea와 비디오 생성을 위한 Wan 2.2를 포함하여 사용자가 텍스트 프롬프트로 멋진 비주얼을 만들 수 있도록 지원합니다.FluxPicture는 FLUX AI를 통해 다양한 이미지 스타일과 사실적인 결과물을 제공하는 무료 AI 이미지 및 비디오 생성기를 제공합니다. 또한 고품질 이미지 생성을 위한 Krea와 비디오 생성을 위한 Wan 2.2를 포함하여 사용자가 텍스트 프롬프트로 멋진 비주얼을 만들 수 있도록 지원합니다.

AI 이미지 생성기
AI 앱 TOP 250 보기

Imgex.ai

AI 앱

Imgex.ai는 텍스트-이미지 및 참조 편집에서 이미지-비디오까지 다양한 모델을 통해 시각 자료를 생성, 편집 및 애니메이션할 수 있는 AI 이미지 및 비디오 스튜디오입니다. 모든 작업이 크레딧 기반의 단일 작업 공간에서 이루어집니다.

AI 이미지 생성기미디어 및 엔터테인먼트
도구 보기

AI 앱

텍스트-이미지 및 참조 편집에서 이미지-비디오까지 다양한 모델을 통해 시각 자료를 생성, 편집 및 애니메이션할 수 있는 AI 이미지 및 비디오 스튜디오입니다. 모든 작업이 크레딧 기반의 단일 작업 공간에서 이루어집니다.Imgex.ai는 텍스트-이미지 및 참조 편집에서 이미지-비디오까지 다양한 모델을 통해 시각 자료를 생성, 편집 및 애니메이션할 수 있는 AI 이미지 및 비디오 스튜디오입니다. 모든 작업이 크레딧 기반의 단일 작업 공간에서 이루어집니다.

AI 이미지 생성기미디어 및 엔터테인먼트
AI 앱 TOP 250 보기

Yolly AI

AI 앱

Yolly AI는 텍스트, 이미지 또는 기존 비디오에서 시네마급 4K 비디오와 고해상도 이미지를 생성하는 선도적인 모델을 결합한 올인원 AI 비디오 및 이미지 생성기입니다.

AI 동영상 생성기미디어 및 엔터테인먼트

AI 동영상 생성기 189위

도구 보기

AI 앱

텍스트, 이미지 또는 기존 비디오에서 시네마급 4K 비디오와 고해상도 이미지를 생성하는 선도적인 모델을 결합한 올인원 AI 비디오 및 이미지 생성기입니다.Yolly AI는 텍스트, 이미지 또는 기존 비디오에서 시네마급 4K 비디오와 고해상도 이미지를 생성하는 선도적인 모델을 결합한 올인원 AI 비디오 및 이미지 생성기입니다.

AI 동영상 생성기미디어 및 엔터테인먼트
AI 동영상 생성기 189위

Vidofy

AI 앱

500개 이상의 AI 모델인 Veo, Runway, Kling, Seedance 등을 사용하여 프롬프트로 비디오, 이미지 및 음성을 생성하는 올인원 AI 스튜디오로, 하나의 계정에서 공유 크레딧으로 이용할 수 있습니다.

AI 동영상 생성기미디어 및 엔터테인먼트

애니메이션 제작 129위

도구 보기

AI 앱

500개 이상의 AI 모델인 Veo, Runway, Kling, Seedance 등을 사용하여 프롬프트로 비디오, 이미지 및 음성을 생성하는 올인원 AI 스튜디오로, 하나의 계정에서 공유 크레딧으로 이용할 수 있습니다.

AI 동영상 생성기미디어 및 엔터테인먼트
애니메이션 제작 129위

플럭스 로라는 이미지 생성, 모델 비교 및 관리되는 LoRA 교육에 중점을 둔 독립 플랫폼입니다. 이미지 및 비디오 모델을 위한 범용 AI 스튜디오를 제공하며, 전용 워크플로우와 선별된 모델 라이브러리를 계획하고 있습니다.

AI 이미지 생성기
도구 보기

이미지 생성, 모델 비교 및 관리되는 LoRA 교육에 중점을 둔 독립 플랫폼입니다. 이미지 및 비디오 모델을 위한 범용 AI 스튜디오를 제공하며, 전용 워크플로우와 선별된 모델 라이브러리를 계획하고 있습니다.플럭스 로라는 이미지 생성, 모델 비교 및 관리되는 LoRA 교육에 중점을 둔 독립 플랫폼입니다. 이미지 및 비디오 모델을 위한 범용 AI 스튜디오를 제공하며, 전용 워크플로우와 선별된 모델 라이브러리를 계획하고 있습니다.

AI 이미지 생성기
AI 앱 TOP 250 보기
1/8