설명
Flide는 Jev 스타일 의사결정 모델을 가속화하기 위해 특별히 설계된 고급 추론 인프라입니다. 그 핵심 혁신은 정확한 상태 포킹을 수행할 수 있는 능력에 있으며, 이를 통해 단일 입력 상태를 하나의 전방 패스에서 여러 질문에 대해 처리할 수 있습니다. 이는 상태를 한 번만 읽고 효율적으로 포크하여 모든 질문이 독립적으로 요청되었을 때 얻을 수 있는 정확한 답변을 보장합니다.
더 읽기
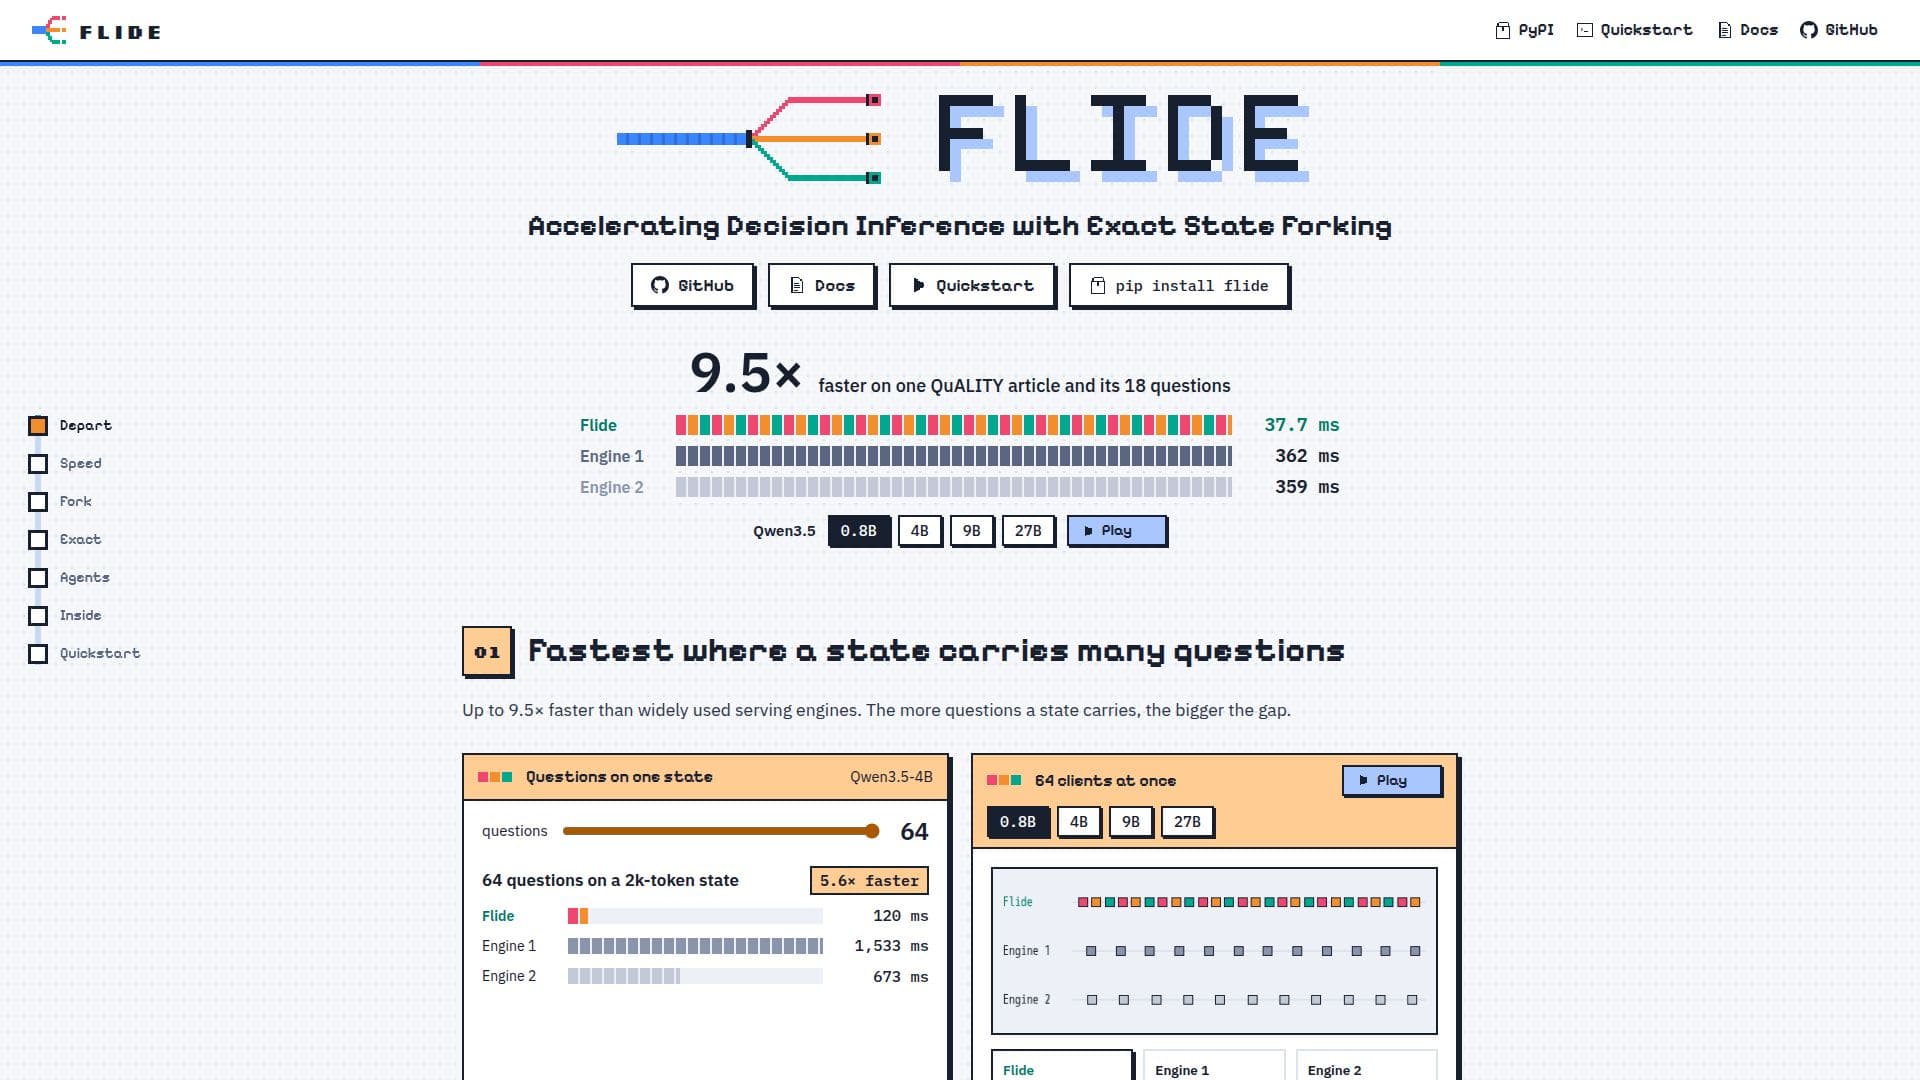
이 독특한 아키텍처는 상당한 성능 향상을 제공하며, Flide는 vLLM 및 SGLang과 같은 널리 사용되는 서빙 엔진에 비해 최대 9.5배 빠른 추론을 보여줍니다. 성능 이점은 주어진 상태와 관련된 질문의 수가 증가함에 따라 더욱 두드러집니다. 예를 들어, 2k 토큰 상태에서 64개의 질문이 있을 경우, Flide는 9.5배의 속도 향상과 64 클라이언트에서 2.2배 높은 처리량을 달성합니다.
속도 외에도 Flide는 정확성을 우선시하며, float32 기준에서 1.1 포인트 이내에 머물러 있어 가장 근접한 엔진 중 하나입니다. Flide는 Qwen3.5 및 Gemma 4 기반의 채팅 모델과 OneJev 모델을 포함한 다양한 모델을 지원합니다. Flide는 또한 Gated DeltaNet 레이어를 통해 하이브리드 모델을 처리하여 각 질문이 공유 컨텍스트의 정확한 상태에서 시작하도록 보장합니다. 이 시스템은 요청이 배치 방식에 관계없이 동일한 비트를 생성하도록 보장하는 `--batch-invariant` 옵션을 제공합니다.
설치는 pip를 통해 간단하게 진행할 수 있으며, A40, A10, RTX 30, H100 및 H200을 포함한 다양한 NVIDIA GPU에 대해 미리 빌드된 커널을 지원합니다. Flide는 vLLM 및 SGLang과 동일한 `/v1/systemone` API를 노출하여 답변의 모든 옵션에 대한 확률을 제공합니다. 또한, 특정 백본 모델에 따라 텍스트, 이미지 및 비디오를 포함한 다중 모드 입력을 지원합니다. Qwen3.5에 대한 FP8 양자화 기능과 에이전트 상태를 재개하기 위한 세션 캐시와 같은 기능은 Flide의 능력을 더욱 향상시킵니다.
- 카테고리MLOps 및 모델 배포
- 배포자체 호스팅
- 플랫폼웹
Flide의 핵심 기능
정확한 상태 포킹: 단일 전방 패스에서 모든 질문에 대해 하나의 상태를 처리합니다.
가속화된 추론: 다른 서빙 엔진보다 최대 9.5배 빠릅니다.
높은 처리량: 특정 벤치마크에서 64 클라이언트로 2.2배의 처리량을 달성합니다.
float32 기준 근접성: 정확성을 위해 float32 기준에서 1.1 포인트 이내에 머뭅니다.
배치 불변성: `--batch-invariant`로 배치 방식에 관계없이 일관된 결과를 보장합니다.
ForkAttention 메커니즘: 각 질문이 독립적으로 요청된 것처럼 자신의 상태를 읽습니다.
하이브리드 모델에 대한 정확성: 정확한 컨텍스트 처리를 위해 Gated DeltaNet 레이어를 지원합니다.
단일 플랫 스트림 처리: 요청을 CUDA 그래프에 의해 재생되는 단일 토큰 스트림으로 실행합니다.
vLLM/SGLang 호환 API: `/v1/systemone` API 표준을 사용합니다.
미리 빌드된 커널: NVIDIA A40, A10, RTX 30, H100 및 H200 GPU에 최적화되어 있습니다.
모델 백본: Qwen3.5 (0.8B, 2B, 4B, 9B, 27B) 및 Gemma 4 (E2B, E4B, 12B, 26B-A4B, 31B)를 지원합니다.
다중 모드 입력: 텍스트, 이미지 및 비디오 입력을 처리합니다.
FP8 양자화: Ada, Hopper 및 Blackwell GPU에서 FP8로 Qwen3.5를 실행합니다.
세션 캐시: 에이전트가 이전 상태에서 재개할 수 있도록 이전 상태를 유지합니다 (예: `--session-cache-gb 40`).
프론트엔드 프로세스: 많은 클라이언트를 위해 HTTP, 렌더링 및 토큰화를 별도의 프로세스에서 실행할 수 있습니다.
Flide 사용 방법은?
Flide 설치: pip를 사용하여 Flide 패키지를 설치합니다.
서버 시작: `flide serve`를 실행하여 추론 서버를 시작하며, 선택적으로 `--host`를 지정합니다.
모델 구성: Qwen3.5 또는 Gemma 4와 같은 채팅 모델을 직접 제공하거나 Open-Jev 어댑터를 병합합니다.
요청 전송: `/v1/systemone` API를 사용하여 상태와 질문을 서버와 상호작용합니다.
다중 모드 입력 처리: 상태에 이미지 경로를 포함하고 이미지 지원 모델에 미디어를 전송합니다.
Flide의 사용 사례
- 가속화된 의사결정 모델
- 다중 모드 추론
- 일관된 배치 처리
- 에이전트 상태 관리
- 고성능 LLM 서빙
- 연구 및 개발