설명
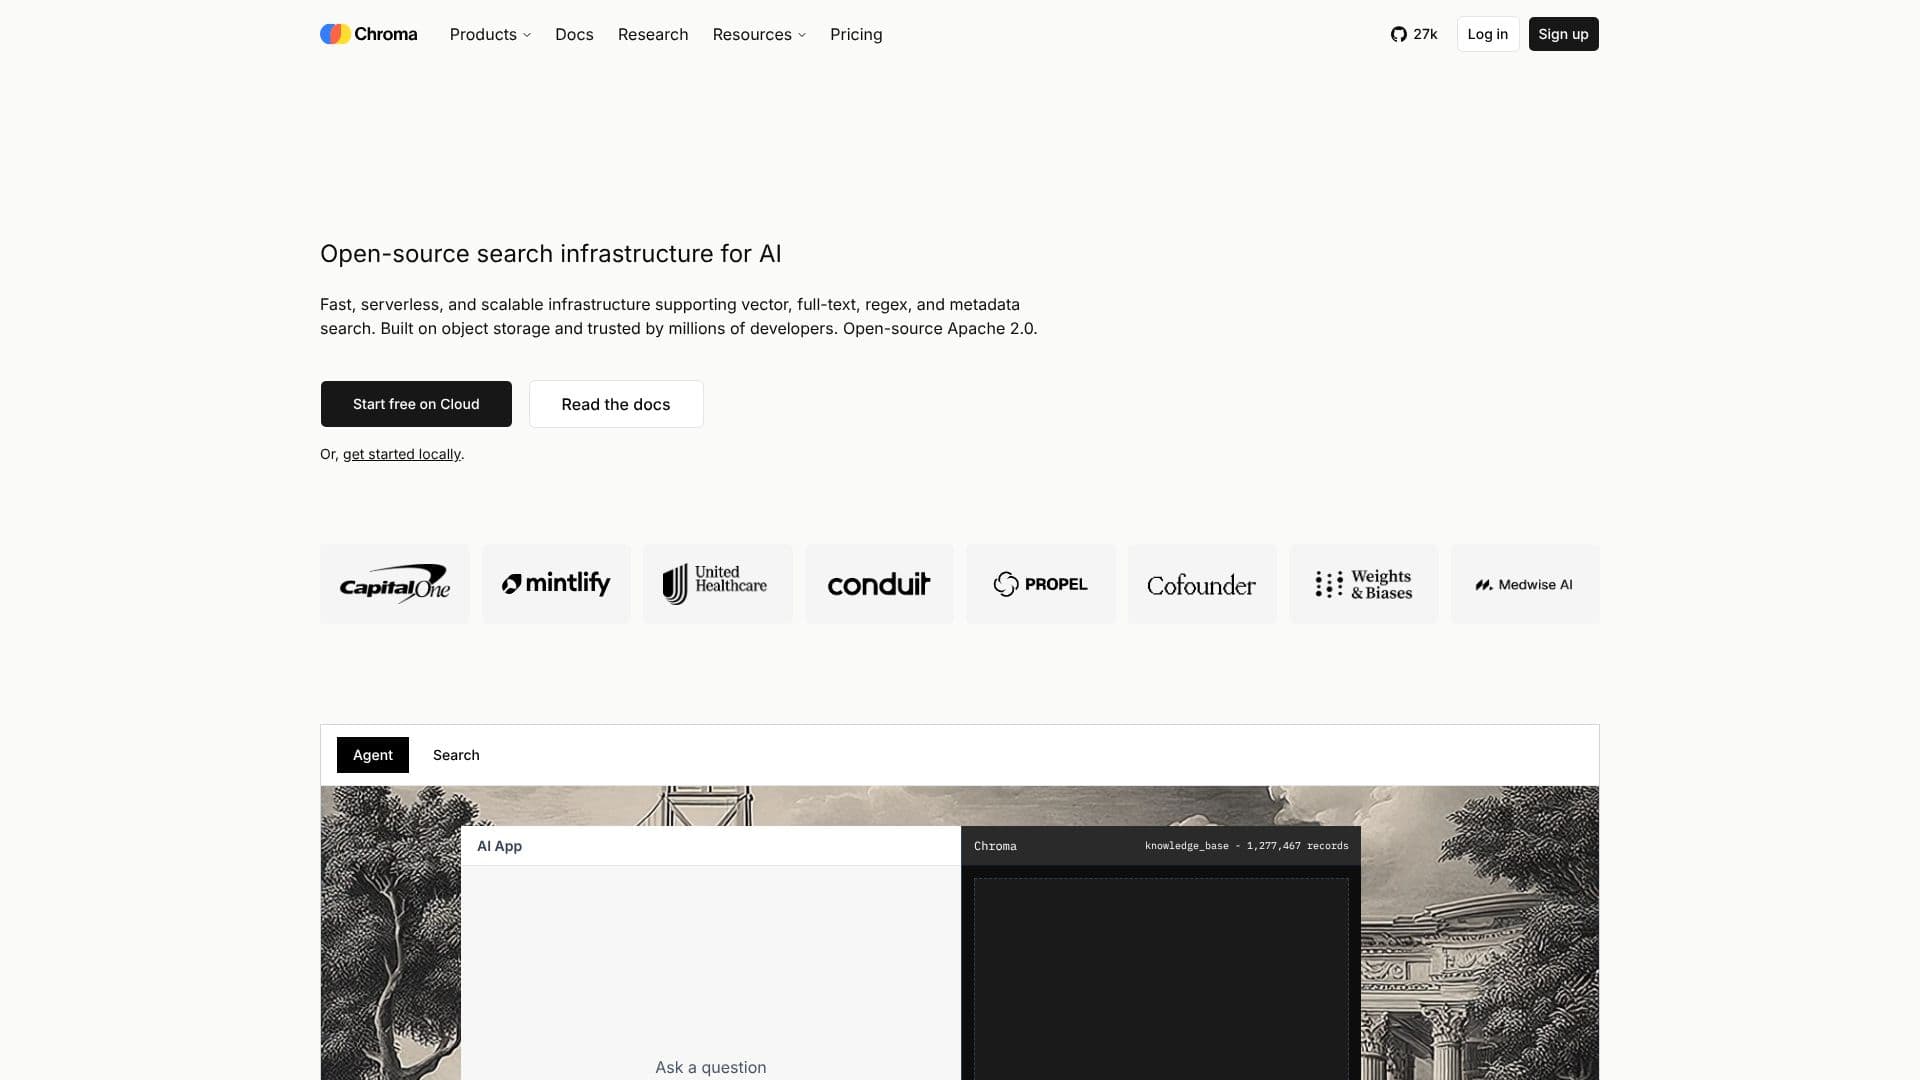
Chroma는 AI 애플리케이션을 위해 특별히 설계된 오픈 소스 검색 인프라입니다. 효율적이고 확장 가능한 검색 기능을 구현하려는 개발자에게 강력한 솔루션을 제공합니다. Chroma는 다양한 데이터 검색 요구 사항을 충족하기 위해 벡터, 전체 텍스트, 정규식 및 메타데이터 검색을 포함한 다양한 검색 유형을 지원합니다.
객체 스토리지를 기반으로 구축된 Chroma는 빠르고 확장 가능한 성능을 제공합니다. 수십억 개의 멀티 테넌트 인덱스를 처리하도록 설계되어 낮은 지연 시간의 쿼리를 보장합니다. 이 시스템은 자동 데이터 계층화 및 캐싱을 통해 성능과 비용 효율성을 최적화하도록 설계되었습니다. Chroma의 아키텍처는 객체 스토리지를 활용하여 기존 검색 시스템보다 최대 10배 저렴합니다. 또한 제로 옵스 인프라, 자동 확장 기능 및 수동 조정 요구 사항이 없습니다.
Chroma의 주요 기능에는 희소 벡터 검색, 어휘 검색(BM25, SPLADE), 의미적 유사성 검색, 전체 텍스트 검색, 메타데이터 검색 및 데이터 세트 버전 관리가 포함됩니다. 개발을 위한 명령줄 도구를 제공하며 TypeScript, Python 및 Rust와 같은 다양한 프로그래밍 언어를 지원합니다. Chroma는 또한 BYOC(Bring Your Own Cloud) in your VPC, 멀티 클라우드/멀티 리전 복제 및 시점 복구와 같은 엔터프라이즈 수준의 기능을 제공하여 탄력적이고 확장 가능한 검색 시스템을 보장합니다.
Chroma는 효율적이고 확장 가능한 검색 기능이 필요한 프로젝트를 수행하는 개발자, 데이터 과학자 및 AI 엔지니어에게 이상적입니다. 특히 벡터 임베딩, 의미적 검색 및 지식 기반 쿼리와 관련된 애플리케이션에 적합합니다. Chroma의 오픈 소스 특성은 커뮤니티 기여 및 사용자 지정을 허용하여 사용자에게 검색 인프라 구축에 대한 제어 및 유연성을 제공합니다.
Chroma의 핵심 기능
희소 벡터 검색
어휘 검색 (BM25, SPLADE)
의미적 유사성 검색
전체 텍스트 검색
메타데이터 검색
데이터 세트 버전 관리
명령줄 도구
자동 데이터 계층화
제로 옵스 인프라
멀티 테넌트 인덱싱
BYOC (Bring Your Own Cloud)
멀티 리전 복제
시점 복구
Chroma 사용 방법은?
시작하기: Cloud에서 무료로 시작하거나 로컬에서 시작하세요.
구성: 희소 임베딩을 위해 클라이언트와 컬렉션을 구성합니다.
문서 추가: 희소 임베딩으로 문서를 추가합니다.
쿼리: 희소 벡터로 쿼리합니다.
결과 분석: 점수별로 순위가 매겨진 검색 결과를 검토합니다.
Chroma의 사용 사례
- 의미적 검색
- 지식 기반
- 벡터 검색
- 전체 텍스트 검색
- 메타데이터 필터링
- AI 에이전트
- 컨텍스트 엔지니어링