본문으로 건너뛰기
ToolPotion
AI 어드바이저
제출 (무료)

AGI-Eval

AGI-Eval은 포괄적인 평가 체계를 기반으로 대형 언어 모델의 순위와 평가를 제공하는 커뮤니티 플랫폼입니다. 사용자가 각 모델의 강점과 약점을 이해할 수 있도록 투명하고 권위 있는 데이터를 제공하여 정보에 기반한 의사 결정을 지원합니다.

URL 방문
공유
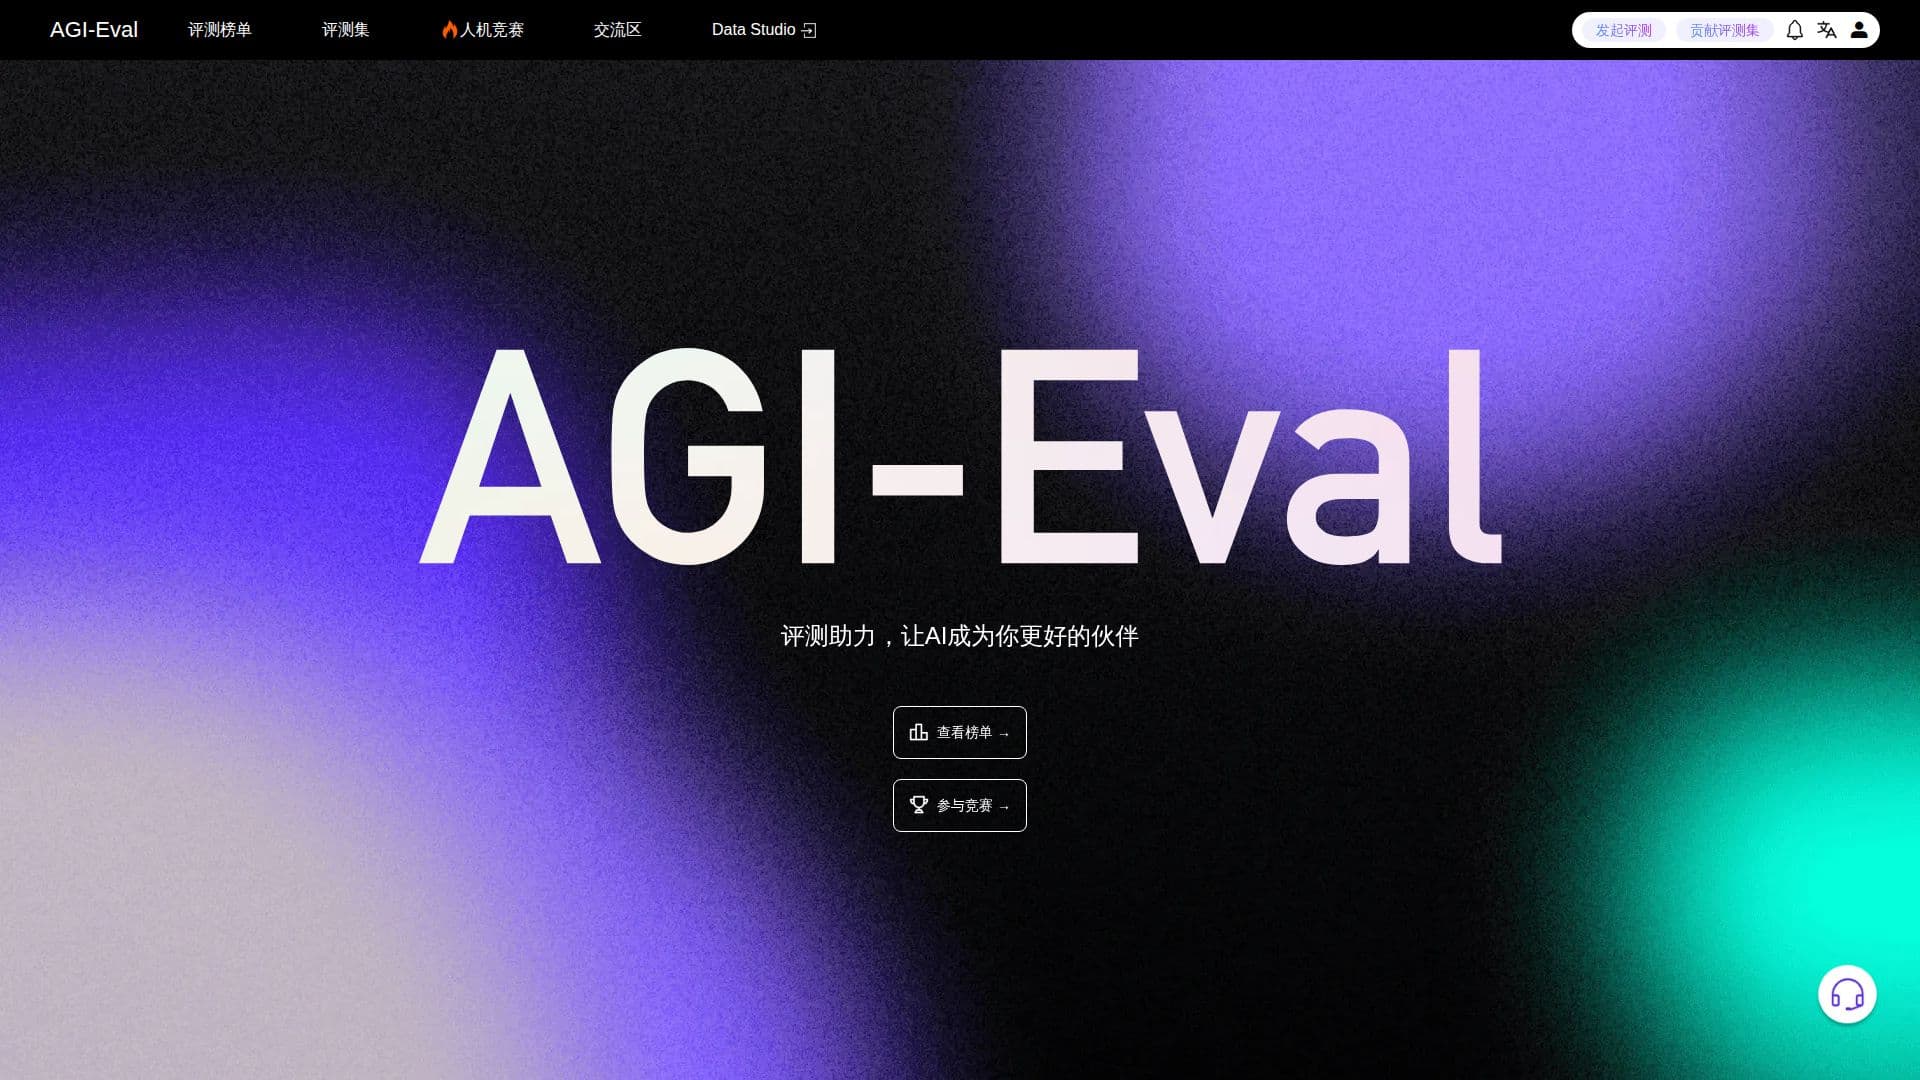
AGI-Eval 스크린샷
AGI-Eval 스크린샷

AGI-Eval은 대형 언어 모델을 평가하는 데 전념하는 커뮤니티 주도 플랫폼입니다. 일반적인 평가 체계를 기반으로 한 포괄적인 순위 시스템을 제공하여 사용자가 다양한 모델의 능력을 통찰력 있게 살펴볼 수 있도록 합니다. 이 플랫폼은 전체 평가와 특정 능력 평가를 모두 포함하여 사용자가 투명하고 권위 있는 데이터에 접근할 수 있도록 보장합니다.

더 읽기

순위는 정기적으로 업데이트되어 사용자가 최신 개발 사항을 파악하고 자신의 필요에 가장 적합한 모델 솔루션을 찾을 수 있도록 합니다. AGI-Eval의 데이터 투명성과 권위 있는 특성은 다양한 언어 모델의 강점과 약점을 이해하고자 하는 모든 이에게 귀중한 자원이 됩니다.

이 플랫폼은 OpenAI, Anthropic, Google과 같은 잘 알려진 기업의 모델을 포함하여 다양한 모델을 특징으로 합니다. 사용자는 순위를 탐색하여 각 모델의 성능을 깊이 이해하고 특정 요구 사항에 따라 정보에 기반한 선택을 할 수 있습니다.

AGI-Eval은 또한 다양한 분야의 전문가들이 개인적으로 기여할 수 있도록 장려하여 플랫폼에서 제공되는 데이터를 더욱 풍부하게 합니다. 이러한 협력적 접근 방식은 평가가 포괄적이고 실제 응용 프로그램을 반영하도록 보장합니다.

  • 카테고리머신러닝 및 데이터 사이언스
  • 요금제무료
  • 배포클라우드
  • 플랫폼웹

  • 포괄적인 모델 평가

  • 정기적으로 업데이트되는 순위

  • 투명한 데이터

  • 권위 있는 평가

  • 다양한 능력의 포함

  • 잘 알려진 모델의 포함

  • 개인 전문가 기여

  • 통찰력 있는 의사 결정 지원

  1. 탐색: 모델 순위를 탐색하세요

  2. 비교: 다양한 모델을 분석하세요

  3. 선택: 필요에 맞는 최적의 모델을 선택하세요

  4. 기여: 전문가 데이터를 추가하세요

  • 모델 비교
  • 정보에 기반한 의사 결정
  • 전문가 기여
  • 능력 평가
  • 최신 정보 유지

AGI-Eval 리뷰

로딩 중...

AGI-Eval와(과) 비슷한 인기 AI 도구

OpenAI Evals 프레임워크

AI GitHub 저장소

OpenAI Evals는 대형 언어 모델(LLMs) 및 LLM 시스템을 평가하기 위해 설계된 프레임워크입니다. AI 모델의 성능과 기능을 평가하는 데 필요한 벤치마크의 오픈 소스 레지스트리 역할을 합니다.

머신러닝 및 데이터 사이언스
도구 보기

AI GitHub 저장소

대형 언어 모델(LLMs) 및 LLM 시스템을 평가하기 위해 설계된 프레임워크입니다. AI 모델의 성능과 기능을 평가하는 데 필요한 벤치마크의 오픈 소스 레지스트리 역할을 합니다.OpenAI Evals는 대형 언어 모델(LLMs) 및 LLM 시스템을 평가하기 위해 설계된 프레임워크입니다. AI 모델의 성능과 기능을 평가하는 데 필요한 벤치마크의 오픈 소스 레지스트리 역할을 합니다.

머신러닝 및 데이터 사이언스
AI GitHub 저장소 TOP 250 보기

HELM은 투명성과 재현성을 중점으로 하는 언어 모델 평가를 위한 포괄적인 벤치마크입니다. 다양한 메트릭 측정과 폭넓은 범위를 제공하며, 모든 데이터는 연구와 탐색을 위해 자유롭게 접근 가능합니다.

머신러닝 및 데이터 사이언스
도구 보기

HELM은 투명성과 재현성을 중점으로 하는 언어 모델 평가를 위한 포괄적인 벤치마크입니다. 다양한 메트릭 측정과 폭넓은 범위를 제공하며, 모든 데이터는 연구와 탐색을 위해 자유롭게 접근 가능합니다.

머신러닝 및 데이터 사이언스
AI 프레임워크 TOP 50 보기

H2O Eval Studio는 Retrieval-Augmented Generation 및 대형 언어 모델 애플리케이션의 성능, 신뢰성 및 보안을 평가하기 위해 설계된 모듈형 플랫폼입니다. 이 플랫폼은 AI의 신뢰성과 정확성을 향상시키기 위한 실행 대시보드, 사용자 정의 가능한 평가자 및 고급 통찰력을 제공합니다.

MLOps 및 모델 배포

MLOps 및 모델 배포 77위

도구 보기

Retrieval-Augmented Generation 및 대형 언어 모델 애플리케이션의 성능, 신뢰성 및 보안을 평가하기 위해 설계된 모듈형 플랫폼입니다. 이 플랫폼은 AI의 신뢰성과 정확성을 향상시키기 위한 실행 대시보드, 사용자 정의 가능한 평가자 및 고급 통찰력을 제공합니다.H2O Eval Studio는 Retrieval-Augmented Generation 및 대형 언어 모델 애플리케이션의 성능, 신뢰성 및 보안을 평가하기 위해 설계된 모듈형 플랫폼입니다. 이 플랫폼은 AI의 신뢰성과 정확성을 향상시키기 위한 실행 대시보드, 사용자 정의 가능한 평가자 및 고급 통찰력을 제공합니다.

MLOps 및 모델 배포
MLOps 및 모델 배포 77위

Arena AI

AI 앱

Arena AI는 사용자가 세계 최고의 AI 모델에 대해 채팅하고, 비교하며, 투표할 수 있는 플랫폼입니다. 이 플랫폼은 실제 시나리오를 통해 평가된 LLM, 이미지 및 코드 모델에 대한 공개 리더보드를 제공합니다.

머신러닝 플랫폼

연구원들 5위

도구 보기

AI 앱

사용자가 세계 최고의 AI 모델에 대해 채팅하고, 비교하며, 투표할 수 있는 플랫폼입니다. 이 플랫폼은 실제 시나리오를 통해 평가된 LLM, 이미지 및 코드 모델에 대한 공개 리더보드를 제공합니다.Arena AI는 사용자가 세계 최고의 AI 모델에 대해 채팅하고, 비교하며, 투표할 수 있는 플랫폼입니다. 이 플랫폼은 실제 시나리오를 통해 평가된 LLM, 이미지 및 코드 모델에 대한 공개 리더보드를 제공합니다.

머신러닝 플랫폼
연구원들 5위

Evidently AI는 AI 애플리케이션을 평가하고 모니터링하기 위한 오픈 소스 도구를 제공합니다. LLM을 테스트하고 다양한 워크플로우에서 성능을 모니터링하여 AI 시스템이 생산 준비가 되었는지 확인하는 데 도움을 줍니다. 전 세계 AI 팀이 신뢰합니다.

MLOps 및 모델 배포

MLOps 및 모델 배포 24위

도구 보기

AI 애플리케이션을 평가하고 모니터링하기 위한 오픈 소스 도구를 제공합니다. LLM을 테스트하고 다양한 워크플로우에서 성능을 모니터링하여 AI 시스템이 생산 준비가 되었는지 확인하는 데 도움을 줍니다. 전 세계 AI 팀이 신뢰합니다.Evidently AI는 AI 애플리케이션을 평가하고 모니터링하기 위한 오픈 소스 도구를 제공합니다. LLM을 테스트하고 다양한 워크플로우에서 성능을 모니터링하여 AI 시스템이 생산 준비가 되었는지 확인하는 데 도움을 줍니다. 전 세계 AI 팀이 신뢰합니다.

MLOps 및 모델 배포
MLOps 및 모델 배포 24위

인공지능 분석은 AI 모델 및 API 호스팅 제공자의 독립적인 벤치마킹을 제공합니다. 품질, 가격, 출력 속도 및 지연 시간과 같은 주요 성능 지표를 평가하여 개발자가 AI 스택을 최적화할 수 있도록 돕습니다.

머신러닝 및 데이터 사이언스

AI 앱 108위

도구 보기

AI 모델 및 API 호스팅 제공자의 독립적인 벤치마킹을 제공합니다. 품질, 가격, 출력 속도 및 지연 시간과 같은 주요 성능 지표를 평가하여 개발자가 AI 스택을 최적화할 수 있도록 돕습니다.인공지능 분석은 AI 모델 및 API 호스팅 제공자의 독립적인 벤치마킹을 제공합니다. 품질, 가격, 출력 속도 및 지연 시간과 같은 주요 성능 지표를 평가하여 개발자가 AI 스택을 최적화할 수 있도록 돕습니다.

머신러닝 및 데이터 사이언스
AI 앱 108위

SuperCLUE

AI 앱

SuperCLUE는 중국의 범용 대형 모델을 평가하기 위한 종합 벤치마크입니다. 이 모델은 다양한 차원에서 모델의 효과성을 평가하여 국제 기준 및 인간 성과와 비교합니다.

머신러닝 플랫폼
도구 보기

AI 앱

중국의 범용 대형 모델을 평가하기 위한 종합 벤치마크입니다. 이 모델은 다양한 차원에서 모델의 효과성을 평가하여 국제 기준 및 인간 성과와 비교합니다.SuperCLUE는 중국의 범용 대형 모델을 평가하기 위한 종합 벤치마크입니다. 이 모델은 다양한 차원에서 모델의 효과성을 평가하여 국제 기준 및 인간 성과와 비교합니다.

머신러닝 플랫폼
AI 앱 TOP 250 보기

Langtrace

AI 앱

Langtrace는 AI 프로토타입을 엔터프라이즈급 제품으로 전환하는 데 도움을 주는 오픈 소스 관찰 가능성 및 평가 플랫폼입니다. AI 에이전트의 성능, 보안 및 비용에 대한 통찰력을 제공하며, 원활한 통합 및 반복을 위해 인기 있는 프레임워크와 LLM 제공업체를 지원합니다.

MLOps 및 모델 배포

MLOps 및 모델 배포 102위

도구 보기

AI 앱

AI 프로토타입을 엔터프라이즈급 제품으로 전환하는 데 도움을 주는 오픈 소스 관찰 가능성 및 평가 플랫폼입니다. AI 에이전트의 성능, 보안 및 비용에 대한 통찰력을 제공하며, 원활한 통합 및 반복을 위해 인기 있는 프레임워크와 LLM 제공업체를 지원합니다.Langtrace는 AI 프로토타입을 엔터프라이즈급 제품으로 전환하는 데 도움을 주는 오픈 소스 관찰 가능성 및 평가 플랫폼입니다. AI 에이전트의 성능, 보안 및 비용에 대한 통찰력을 제공하며, 원활한 통합 및 반복을 위해 인기 있는 프레임워크와 LLM 제공업체를 지원합니다.

MLOps 및 모델 배포
MLOps 및 모델 배포 102위
1/8