メインコンテンツへスキップ
ToolPotion
AI アドバイザー
送信(無料)

Nanbeige4.3-33B

LLMAIモデルとLLMオープンソース · Web

Nanbeige4.3-33Bは、複雑なコーディングおよびプロフェッショナルな共同作業タスク向けに設計された高容量の教師モデルです。エージェント性能に優れ、実世界での展開に対してコスト効果の高いオプションを提供し、より小さなモデルのための蒸留パイプラインをサポートします。

URLを訪問
共有
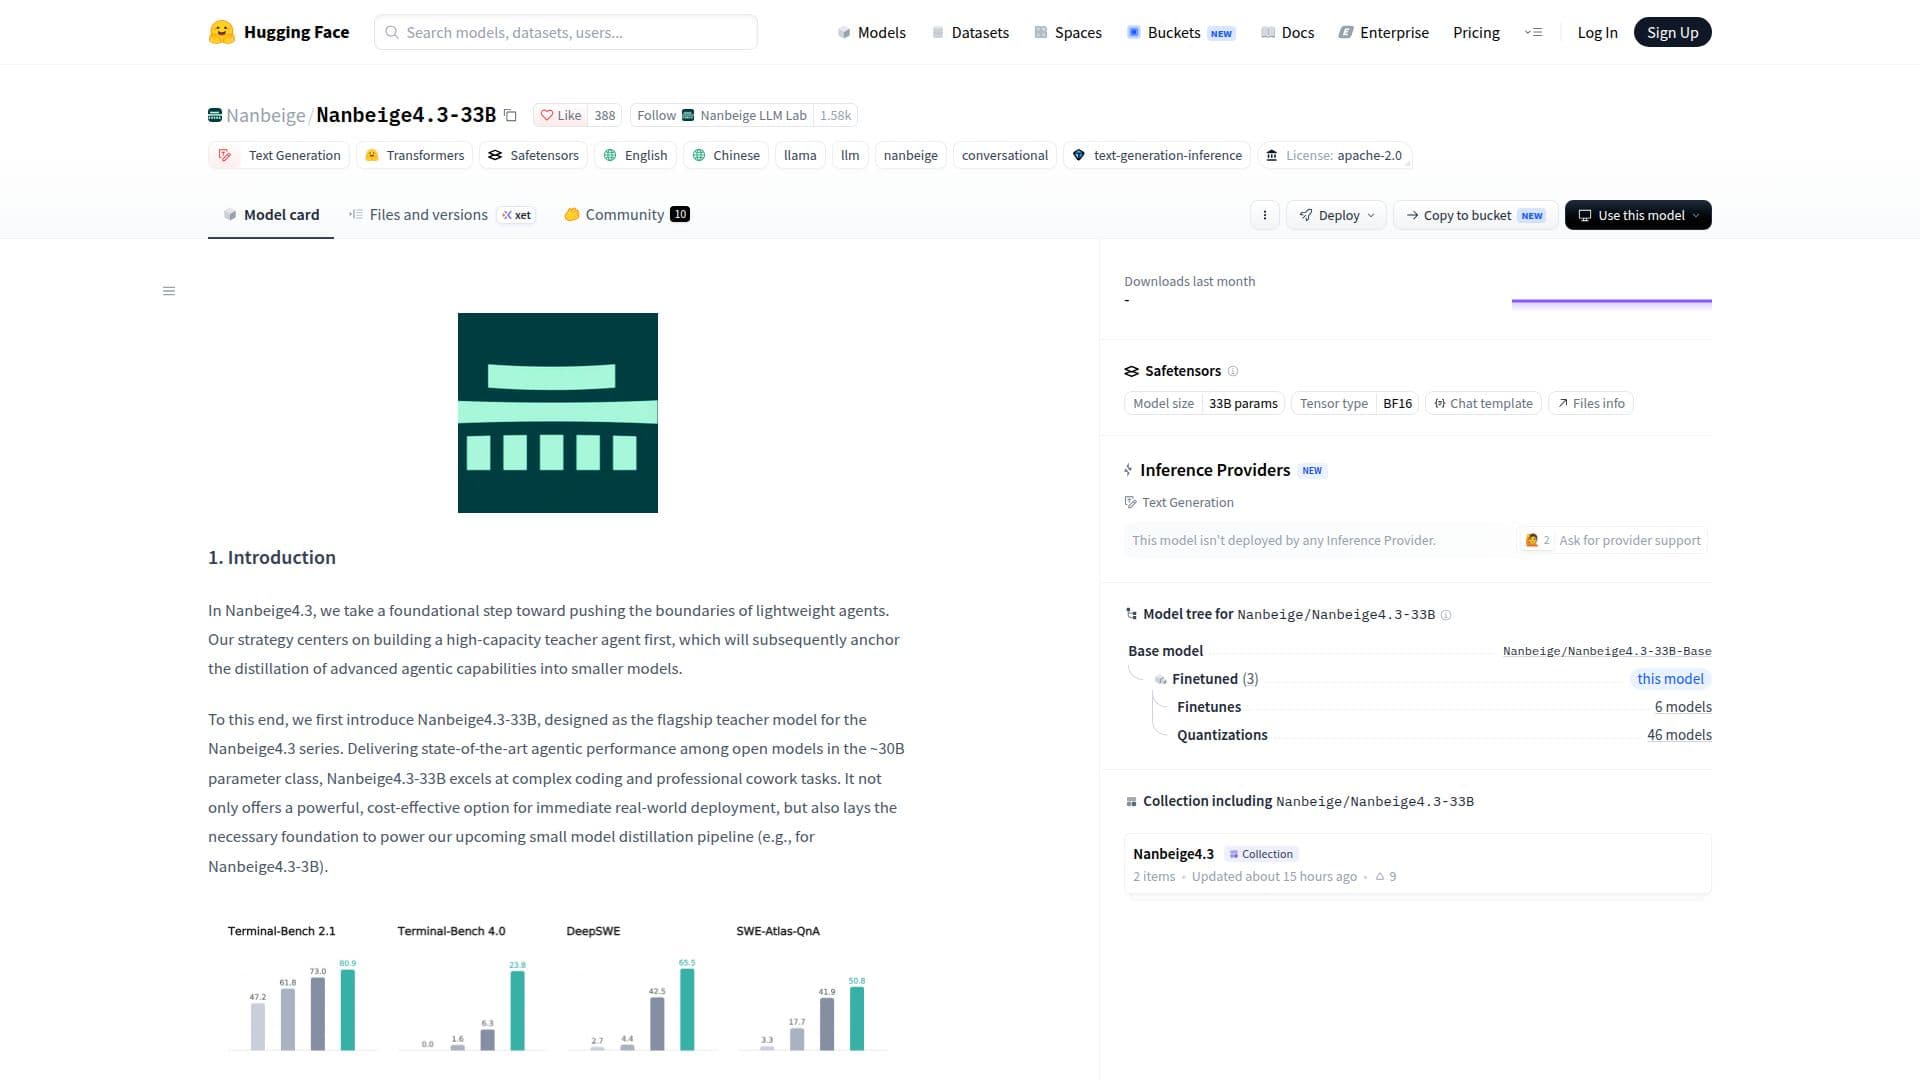
Nanbeige4.3-33B のスクリーンショット

Nanbeige4.3-33Bは、Nanbeige4.3シリーズのフラッグシップ教師モデルであり、軽量エージェントの限界を押し広げることを目的としています。これは高容量モデルであり、複雑なコーディングおよびプロフェッショナルな共同作業タスクにおいて優れた性能を発揮し、約30Bパラメータクラスのオープンモデルの中で最先端のエージェント性能を提供します。このモデルは、即時の実世界での展開に対して強力でコスト効果の高いオプションを提供するだけでなく、Nanbeige4.3-3Bのような小型モデルを対象とした蒸留パイプラインの基盤を築きます。

続きを読む

このモデルの性能は、Qwen3.8-27B、Muse-Glimmer-30B、Gemma4-31Bなどの他の最前線モデルと比較され、エージェントコーディングや共同作業タスクを含むさまざまなカテゴリで優れた結果を示しています。ほとんどのベンチマークでリードしており、さまざまな職業や業界にわたって強力な性能を示しています。たとえば、JobBenchでは、評価された35の職業のほとんどでベースラインを上回っています。

Nanbeige4.3-33Bは、最大524,288トークンのコンテキスト長をサポートし、推論やツール使用シナリオのための構成可能なチャットテンプレートを提供します。Transformers、SGLang、vLLMと互換性があり、展開の柔軟性を提供します。モデルのトークナイザーは、推論やツール使用シナリオにおけるカスタマイズを可能にし、思考を有効にしたり保持したりするオプションや、XMLやJSONのような形式でツールを渡すオプションを提供します。

お問い合わせやコラボレーションについては、リポジトリで問題を開くか、チームにメールで連絡することをお勧めします。このモデルは、データやトレーニングに関する共同作業を含む、ドメイン特化型および業界特化型エージェントを構築するためのコラボレーションを受け入れています。

  • カテゴリーAIモデルとLLM
  • 料金モデルオープンソース
  • デプロイクラウド
  • プラットフォームWeb

  • 高容量の教師モデル

  • 複雑なコーディングタスク

  • プロフェッショナルな共同作業タスク

  • 最先端のエージェント性能

  • コスト効果の高い展開

  • 蒸留パイプラインをサポート

  • 最大524,288トークンのコンテキスト長

  • Transformers、SGLang、vLLMと互換性

  1. モデルページにアクセス: Hugging Faceリポジトリを訪問

  2. 認証: アクセス権があることを確認

  3. 設定: 希望のパラメータでモデルを設定

  4. プロンプトを送信: タスクにモデルを使用

  5. ファインチューニング: 特定のニーズに合わせて設定を調整

  • 複雑なコーディング
  • プロフェッショナルな共同作業
  • 実世界での展開
  • エージェント性能
  • 小型モデルの蒸留

Nanbeige の製品

Nanbeige4.2-3B のモデルです。

Nanbeige4.3-33B のレビュー

読み込み中...

Nanbeige4.3-33B に似た人気のAIツール

Nanbeige4.2-3Bは、強力な推論能力と整合性を備えたコンパクトなエージェントモデルです。一般的なエージェントおよびコードエージェントタスクにおいて優れた性能を発揮し、パラメータサイズを小さく保ちながらも大規模モデルを上回ります。

AIモデルとLLM

LLMで第30位

ツールを見る

強力な推論能力と整合性を備えたコンパクトなエージェントモデルです。一般的なエージェントおよびコードエージェントタスクにおいて優れた性能を発揮し、パラメータサイズを小さく保ちながらも大規模モデルを上回ります。Nanbeige4.2-3Bは、強力な推論能力と整合性を備えたコンパクトなエージェントモデルです。一般的なエージェントおよびコードエージェントタスクにおいて優れた性能を発揮し、パラメータサイズを小さく保ちながらも大規模モデルを上回ります。

AIモデルとLLM
LLMで第30位

K2-Horizon-MoVA-36B-A4Bは、36億のパラメータを持つMixture-of-Expertsモデルで、Mixture-of-Valuesアテンションを採用しています。4億のアクティブパラメータを使用して、エージェント的および推論ベンチマークでより大きなモデルを上回る最先端の結果を提供します。

AIモデルとLLM
ツールを見る

36億のパラメータを持つMixture-of-Expertsモデルで、Mixture-of-Valuesアテンションを採用しています。4億のアクティブパラメータを使用して、エージェント的および推論ベンチマークでより大きなモデルを上回る最先端の結果を提供します。K2-Horizon-MoVA-36B-A4Bは、36億のパラメータを持つMixture-of-Expertsモデルで、Mixture-of-Valuesアテンションを採用しています。4億のアクティブパラメータを使用して、エージェント的および推論ベンチマークでより大きなモデルを上回る最先端の結果を提供します。

AIモデルとLLM
LLM トップ50を見る

Ornith-1.5-35B-A3Bは、高度なコーディングおよび推論タスクのために設計された中規模の専門家混合モデルです。ベンチマークで同様のモデルを上回り、効率的なパラメータ活性化と自己改善機能を提供します。

AIモデルとLLM
ツールを見る

高度なコーディングおよび推論タスクのために設計された中規模の専門家混合モデルです。ベンチマークで同様のモデルを上回り、効率的なパラメータ活性化と自己改善機能を提供します。Ornith-1.5-35B-A3Bは、高度なコーディングおよび推論タスクのために設計された中規模の専門家混合モデルです。ベンチマークで同様のモデルを上回り、効率的なパラメータ活性化と自己改善機能を提供します。

AIモデルとLLM
LLM トップ50を見る

Agents-A1は、複数のドメインにわたるエージェント能力を拡張するために設計された35B Mixture-of-Expertsモデルです。長期的な探索、エンジニアリング、科学研究、指示の遵守に優れ、最前線のシステムに対して堅牢なパフォーマンスを提供します。

AIモデルとLLM

LLMで第31位

ツールを見る

複数のドメインにわたるエージェント能力を拡張するために設計された35B Mixture-of-Expertsモデルです。長期的な探索、エンジニアリング、科学研究、指示の遵守に優れ、最前線のシステムに対して堅牢なパフォーマンスを提供します。Agents-A1は、複数のドメインにわたるエージェント能力を拡張するために設計された35B Mixture-of-Expertsモデルです。長期的な探索、エンジニアリング、科学研究、指示の遵守に優れ、最前線のシステムに対して堅牢なパフォーマンスを提供します。

AIモデルとLLM
LLMで第31位

DeepSeek-V4.1-Flash-1017は、推論、コーディング、視覚ベンチマークを強化したDeepSeekモデルの更新版です。タスクの実行時間と出力の長さを短縮し、ユーザーにとって迅速かつコスト効率の良いソリューションを提供します。

AIモデルとLLM

LLMで第9位

ツールを見る

推論、コーディング、視覚ベンチマークを強化したDeepSeekモデルの更新版です。タスクの実行時間と出力の長さを短縮し、ユーザーにとって迅速かつコスト効率の良いソリューションを提供します。DeepSeek-V4.1-Flash-1017は、推論、コーディング、視覚ベンチマークを強化したDeepSeekモデルの更新版です。タスクの実行時間と出力の長さを短縮し、ユーザーにとって迅速かつコスト効率の良いソリューションを提供します。

AIモデルとLLM
LLMで第9位

Hy3

LLM

Hy3は、Tencent Hyチームによって開発された295BパラメータのMixture-of-Expertsモデルです。推論、エージェント的、長文コンテキストタスクに優れ、さまざまな生産性シナリオで信頼性の高いパフォーマンスを提供します。

AIモデルとLLM

LLMで第20位

ツールを見る

LLM

Tencent Hyチームによって開発された295BパラメータのMixture-of-Expertsモデルです。推論、エージェント的、長文コンテキストタスクに優れ、さまざまな生産性シナリオで信頼性の高いパフォーマンスを提供します。Hy3は、Tencent Hyチームによって開発された295BパラメータのMixture-of-Expertsモデルです。推論、エージェント的、長文コンテキストタスクに優れ、さまざまな生産性シナリオで信頼性の高いパフォーマンスを提供します。

AIモデルとLLM
LLMで第20位

DeepSeek-V4-Pro-0813は、エージェント能力と生産環境でのパフォーマンスを向上させるために設計された高度な言語モデルです。これは、デコーディングと推論機能が改善されたDeepSeek-V4-Pro(プレビュー)モデルを基にしており、主要な商用モデルと競争力があります。

AIモデルとLLM

LLMで第8位

ツールを見る

エージェント能力と生産環境でのパフォーマンスを向上させるために設計された高度な言語モデルです。これは、デコーディングと推論機能が改善されたDeepSeek-V4-Pro(プレビュー)モデルを基にしており、主要な商用モデルと競争力があります。DeepSeek-V4-Pro-0813は、エージェント能力と生産環境でのパフォーマンスを向上させるために設計された高度な言語モデルです。これは、デコーディングと推論機能が改善されたDeepSeek-V4-Pro(プレビュー)モデルを基にしており、主要な商用モデルと競争力があります。

AIモデルとLLM
LLMで第8位

LiquidAI LFM2.5-24B-A2Bは、迅速でプライベートなオンデバイスエージェント向けに最適化された24Bパラメータの推論モデルです。効率的な推論を特徴とし、複数の言語をサポートしているため、エージェントワークフローやツール使用に最適です。

AIモデルとLLM

LLMで第39位

ツールを見る

迅速でプライベートなオンデバイスエージェント向けに最適化された24Bパラメータの推論モデルです。効率的な推論を特徴とし、複数の言語をサポートしているため、エージェントワークフローやツール使用に最適です。LiquidAI LFM2.5-24B-A2Bは、迅速でプライベートなオンデバイスエージェント向けに最適化された24Bパラメータの推論モデルです。効率的な推論を特徴とし、複数の言語をサポートしているため、エージェントワークフローやツール使用に最適です。

AIモデルとLLM
LLMで第39位
1 / 8