メインコンテンツへスキップ
ToolPotion
AI アドバイザー
送信(無料)

LLMEval

AI アプリAIモデルとLLMオープンソース · Web

LLMEvalは、Fudan NLP Labによる研究イニシアチブであり、さまざまな分野における大規模言語モデルの包括的な評価フレームワークの開発に焦点を当てています。論理的推論、公平性、医療AI評価のためのオープンソースツールとデータセットを提供します。

URLを訪問
共有
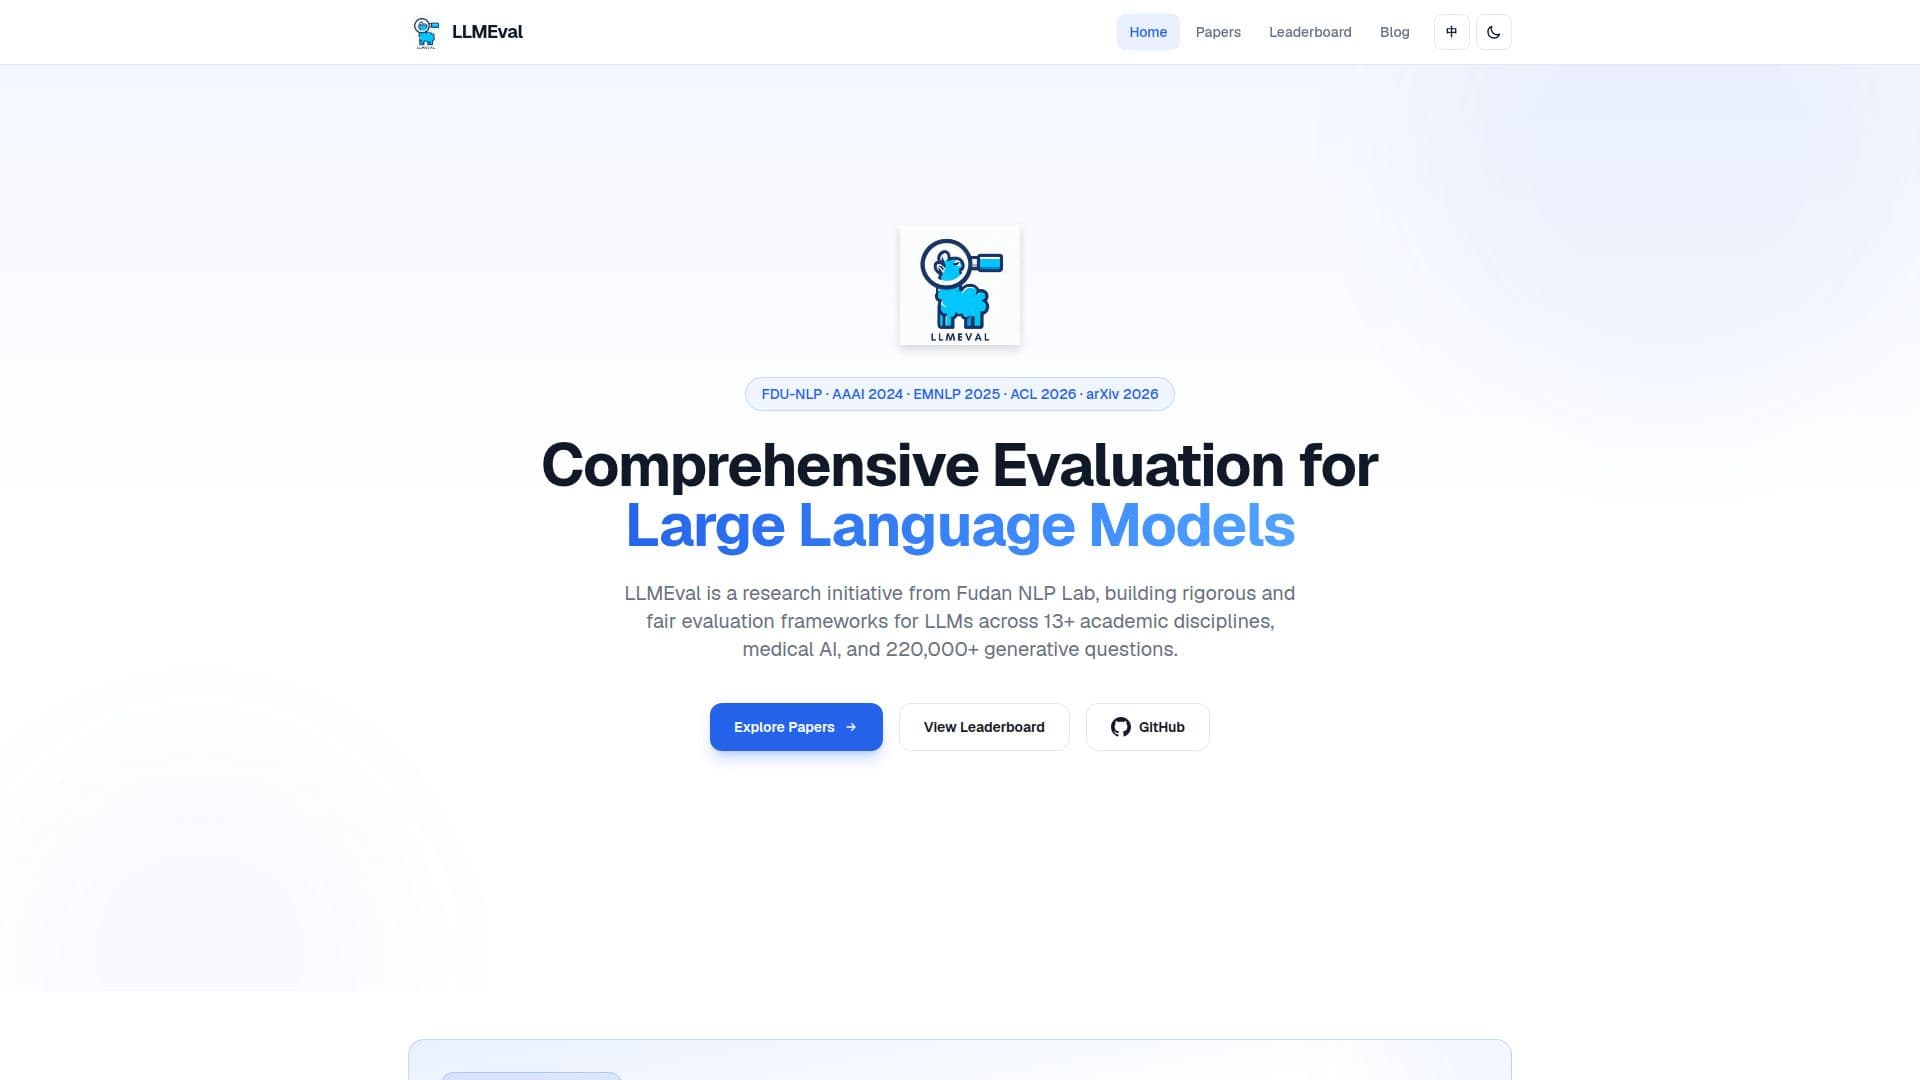
LLMEval のスクリーンショット
LLMEval のスクリーンショット

LLMEvalは、Fudan NLP Labによる研究シリーズであり、大規模言語モデル(LLM)のための包括的で公平かつ堅牢な評価フレームワークの作成に専念しています。これは、13の学術分野、医療AIを網羅し、22万以上の生成質問を含んでいます。このイニシアチブは、LLMのパフォーマンスがさまざまな領域で正確に評価されることを保証するために、厳密で公平な評価フレームワークを提供することを目指しています。

続きを読む

LLMEvalの主要なコンポーネントの1つは、LLMEval-Logicであり、LLMにおける論理的推論のためのオープンソースベンチマークです。このベンチマークには、196の公開ベースアイテムと154の敵対的に強化されたアイテムが含まれており、Z3によって検証された回答と専門家のルーブリックがあります。評価パイプラインは再現可能であり、研究者がLLMの論理的推論能力をテストし、改善することを可能にします。

LLMEval-Fairは、このイニシアチブのもう1つの重要な部分であり、LLM評価における堅牢性と公平性に焦点を当てています。これは、22万の大学院レベルの質問を使用した30か月の縦断研究を含みます。自動化されたパイプラインは、汚染に強いキュレーションと新しい不正防止アーキテクチャを通じてデータの完全性を保証します。この研究は、ほぼ60の主要モデルにおけるパフォーマンスの限界とデータ汚染の脆弱性を明らかにしました。

さらに、LLMEval-Medは、医療LLMを評価するための実世界の臨床ベンチマークを提供します。これは、5つの主要な医療分野をカバーし、電子健康記録や専門家が設計したシナリオからの2,996の質問を含んでいます。評価パイプラインは、人間と機械の合意分析を通じて検証されており、医療AI評価における高い精度を保証します。

LLMEvalは一般に公開されており、コードとデータはGitHubで入手可能です。研究者や開発者は、LLM評価フレームワークの改善に向けて探求し、協力することが奨励されています。

  • カテゴリーAIモデルとLLM
  • 料金モデルオープンソース
  • デプロイクラウド
  • プラットフォームWeb

  • 包括的な評価フレームワーク

  • オープンソースの論理的推論ベンチマーク

  • 公平性と堅牢性の評価

  • 医療AIベンチマーク

  • 22万以上の生成質問

  • Z3によって検証された回答

  • 汚染に強いデータキュレーション

  • 人間と機械の合意分析

  1. 探求: LLMEvalのウェブサイトを訪問する

  2. アクセス: GitHubからデータセットをダウンロードする

  3. 評価: LLMテストのためにベンチマークを使用する

  4. 協力: 研究パートナーシップのために連絡する

  • 学術研究
  • 医療AI評価
  • 論理的推論テスト
  • 公平性評価
  • 共同研究

LLMEval のレビュー

読み込み中...

LLMEval に似た人気のAIツール

Evidently AIは、AIアプリケーションの評価と監視のためのオープンソースツールを提供します。LLMをテストし、さまざまなワークフローにおけるパフォーマンスを監視することで、AIシステムが本番環境に適していることを確保します。世界中のAIチームに信頼されています。

MLOps・モデルデプロイ

MLOps・モデルデプロイで第24位

ツールを見る

AIアプリケーションの評価と監視のためのオープンソースツールを提供します。LLMをテストし、さまざまなワークフローにおけるパフォーマンスを監視することで、AIシステムが本番環境に適していることを確保します。世界中のAIチームに信頼されています。Evidently AIは、AIアプリケーションの評価と監視のためのオープンソースツールを提供します。LLMをテストし、さまざまなワークフローにおけるパフォーマンスを監視することで、AIシステムが本番環境に適していることを確保します。世界中のAIチームに信頼されています。

MLOps・モデルデプロイ
MLOps・モデルデプロイで第24位

AGI-Eval

AI アプリ

AGI-Evalは、大規模言語モデルのランキングと評価を包括的な評価スキームに基づいて提供するコミュニティプラットフォームです。各モデルの強みと弱みを理解するための透明で権威あるデータを提供し、情報に基づいた意思決定を可能にします。

機械学習とデータサイエンス

AIモデルの監視で第132位

ツールを見る

AI アプリ

大規模言語モデルのランキングと評価を包括的な評価スキームに基づいて提供するコミュニティプラットフォームです。各モデルの強みと弱みを理解するための透明で権威あるデータを提供し、情報に基づいた意思決定を可能にします。AGI-Evalは、大規模言語モデルのランキングと評価を包括的な評価スキームに基づいて提供するコミュニティプラットフォームです。各モデルの強みと弱みを理解するための透明で権威あるデータを提供し、情報に基づいた意思決定を可能にします。

機械学習とデータサイエンス
AIモデルの監視で第132位

DeepSeek-v3は、高度なMoEアーキテクチャと最先端の言語モデルにより、即時のAIソリューションを提供します。この安定した無料かつ無制限のモデルで、効率的な推論と多様なハードウェア展開における多言語サポートを備えた最先端のAI機能を体験してください。

AIモデルとLLM
ツールを見る

高度なMoEアーキテクチャと最先端の言語モデルにより、即時のAIソリューションを提供します。この安定した無料かつ無制限のモデルで、効率的な推論と多様なハードウェア展開における多言語サポートを備えた最先端のAI機能を体験してください。DeepSeek-v3は、高度なMoEアーキテクチャと最先端の言語モデルにより、即時のAIソリューションを提供します。この安定した無料かつ無制限のモデルで、効率的な推論と多様なハードウェア展開における多言語サポートを備えた最先端のAI機能を体験してください。

AIモデルとLLM
AI アプリ トップ250を見る

LLM Price Check

AI アプリ

LLM Price Checkは、主要な大規模言語モデル(LLM)のAPI価格を即座に比較・計算できるツールです。OpenAI、Anthropic、Googleなどのプロバイダーから、コスト効率の高いソリューションを簡単に見つけることができます。AI予算を効率的に最適化し、LLMのニーズに最適な取引を見つけましょう。

AIモデルとLLM

AIモデルとLLMで第23位

ツールを見る

AI アプリ

主要な大規模言語モデル(LLM)のAPI価格を即座に比較・計算できるツールです。OpenAI、Anthropic、Googleなどのプロバイダーから、コスト効率の高いソリューションを簡単に見つけることができます。AI予算を効率的に最適化し、LLMのニーズに最適な取引を見つけましょう。LLM Price Checkは、主要な大規模言語モデル(LLM)のAPI価格を即座に比較・計算できるツールです。OpenAI、Anthropic、Googleなどのプロバイダーから、コスト効率の高いソリューションを簡単に見つけることができます。AI予算を効率的に最適化し、LLMのニーズに最適な取引を見つけましょう。

AIモデルとLLM
AIモデルとLLMで第23位

Deepchecks LLM 評価は、AI テスト、可観測性、監視のためのエンタープライズグレードのプラットフォームです。生産環境における AI システムの可視性、制御、信頼を提供し、AI デプロイメントの正確性と一貫性を確保します。

MLOps・モデルデプロイヘルスケア・ライフサイエンス

MLOps・モデルデプロイで第90位

ツールを見る

AI テスト、可観測性、監視のためのエンタープライズグレードのプラットフォームです。生産環境における AI システムの可視性、制御、信頼を提供し、AI デプロイメントの正確性と一貫性を確保します。Deepchecks LLM 評価は、AI テスト、可観測性、監視のためのエンタープライズグレードのプラットフォームです。生産環境における AI システムの可視性、制御、信頼を提供し、AI デプロイメントの正確性と一貫性を確保します。

MLOps・モデルデプロイヘルスケア・ライフサイエンス
MLOps・モデルデプロイで第90位

Gopher

AI モデル

Gopherは、Google DeepMindによる2800億パラメータのトランスフォーマー言語モデルで、4400万から2800億パラメータまでのモデルファミリーの一部です。2021年の研究発表で紹介され、読解力、ファクトチェック、毒性言語の識別において評価され、一部のタスクではスケールの恩恵を受けましたが、論理的推論などのタスクではそうではありませんでした…

AIモデルとLLM
ツールを見る

AI モデル

Google DeepMindによる2800億パラメータのトランスフォーマー言語モデルで、4400万から2800億パラメータまでのモデルファミリーの一部です。2021年の研究発表で紹介され、読解力、ファクトチェック、毒性言語の識別において評価され、一部のタスクではスケールの恩恵を受けましたが、論理的推論などのタスクではそうではありませんでした…Gopherは、Google DeepMindによる2800億パラメータのトランスフォーマー言語モデルで、4400万から2800億パラメータまでのモデルファミリーの一部です。2021年の研究発表で紹介され、読解力、ファクトチェック、毒性言語の識別において評価され、一部のタスクではスケールの恩恵を受けましたが、論理的推論などのタスクではそうではありませんでした…

AIモデルとLLM
AI モデル トップ5を見る

AI Fairness 360は、機械学習モデルにおけるバイアスを調査、報告、軽減するために設計されたオープンソースのツールキットです。PythonとRをサポートし、さまざまな分野における差別に対処するためのアルゴリズムとメトリクスを提供します。

機械学習プラットフォーム

機械学習プラットフォームで第129位

ツールを見る

機械学習モデルにおけるバイアスを調査、報告、軽減するために設計されたオープンソースのツールキットです。PythonとRをサポートし、さまざまな分野における差別に対処するためのアルゴリズムとメトリクスを提供します。AI Fairness 360は、機械学習モデルにおけるバイアスを調査、報告、軽減するために設計されたオープンソースのツールキットです。PythonとRをサポートし、さまざまな分野における差別に対処するためのアルゴリズムとメトリクスを提供します。

機械学習プラットフォーム
機械学習プラットフォームで第129位

DeepSeek-V3-0324

AI モデル

DeepSeek-V3-0324は、推論能力、ウェブ開発、そして中国語の執筆能力において大幅な改善を提供する高度なAIモデルです。これは、マルチターンのインタラクティブなリライトと翻訳の質を向上させ、開発者や研究者にとって多用途なツールとなります。

AIモデルとLLM
ツールを見る

AI モデル

推論能力、ウェブ開発、そして中国語の執筆能力において大幅な改善を提供する高度なAIモデルです。これは、マルチターンのインタラクティブなリライトと翻訳の質を向上させ、開発者や研究者にとって多用途なツールとなります。DeepSeek-V3-0324は、推論能力、ウェブ開発、そして中国語の執筆能力において大幅な改善を提供する高度なAIモデルです。これは、マルチターンのインタラクティブなリライトと翻訳の質を向上させ、開発者や研究者にとって多用途なツールとなります。

AIモデルとLLM
AI モデル トップ5を見る
1 / 8