説明
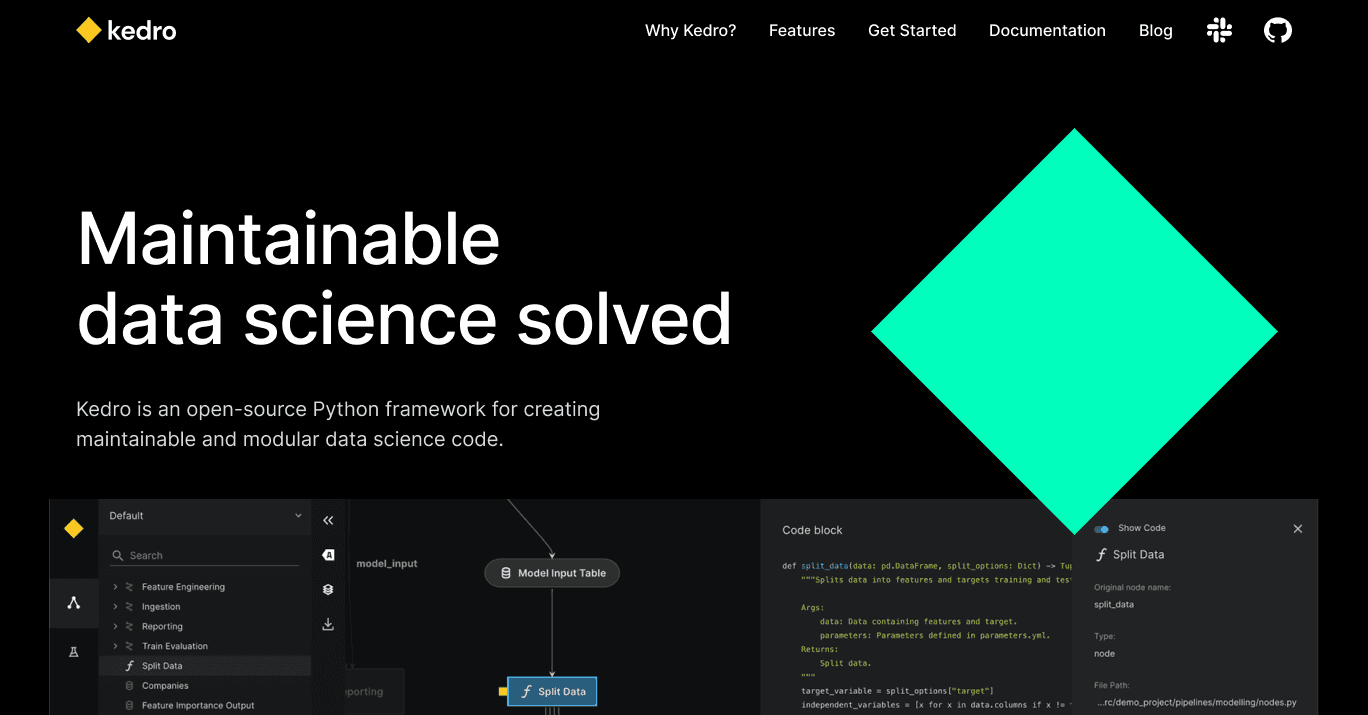
Kedroは、再現可能で保守可能、かつモジュール化されたデータエンジニアリングおよびデータサイエンスコードを作成するためのオープンソースのPythonフレームワークです。データ専門家がソフトウェアエンジニアリングのベストプラクティスを用いて、より良いデータパイプラインを構築できるように設計されています。Kedroは、堅牢でスケーラブルなデータパイプラインの開発をサポートし、複雑なデータワークフローを管理する必要があるデータエンジニアやデータサイエンティストにとって理想的な選択肢です。
このフレームワークは、Kedro-Vizを通じてデータや機械学習パイプラインを視覚化する機能を含むさまざまな機能を提供します。Kedro-Vizは、ユーザーが実験を追跡し、プロジェクト内のデータの流れを理解するのを助けるツールです。また、Kedroは、ユーザーが標準化された構造で新しいプロジェクトを迅速にセットアップできるようにする事前定義されたテンプレートであるスターターセットを提供します。
Kedroは、macOS、Linux、Windowsと互換性があり、Python 3.10以上が必要です。バージョン管理のためのGitや環境管理のためのCondaなど、さまざまなツールやプラットフォームと統合されています。このフレームワークは、PoetryやPDMなどの複数のPythonパッケージングツールをサポートし、ユーザーが依存関係を効果的に管理できるようにします。
Kedroコミュニティは、SlackやGitHubなどのプラットフォームで活発に活動しており、ユーザーはアイデアを共有したり、質問をしたり、プロジェクトの開発に貢献したりできます。Kedroのドキュメントには、ユーザーが始めるための包括的なガイドやチュートリアルが含まれており、プロジェクトの最適化を支援します。
全体として、Kedroはデータパイプラインの品質と保守性を向上させたいデータ専門家にとって強力なツールです。ベストプラクティスとモジュール設計に重点を置いているため、あらゆる規模のデータプロジェクトを管理するための貴重な資産となります。
Kedroフレームワークの主要機能
オープンソースのPythonフレームワーク
再現可能で保守可能なコード
モジュール化されたデータエンジニアリング
データサイエンスパイプラインの開発
視覚化のためのKedro-Viz
事前定義されたプロジェクトスターター
クロスプラットフォームの互換性
活発なコミュニティサポート
Kedroフレームワークの使い方は?
インストール: Python 3.10+でKedroをセットアップする
作成: スターターを使用してプロジェクトを開始する
開発: ベストプラクティスを用いてデータパイプラインを構築する
視覚化: Kedro-Vizを使用して実験を追跡する
Kedroフレームワークの使用例
- データパイプラインの開発
- 機械学習ワークフロー
- プロジェクトテンプレート化
- データ視覚化
- クロスプラットフォーム開発