メインコンテンツへスキップ
ToolPotion
AI アドバイザー
送信(無料)

Flide

Flideは、Jevスタイルの意思決定モデル向けに設計された高性能推論インフラストラクチャです。単一の状態をフォークして、1回のフォワードパス内で全ての質問に対して意思決定推論を加速させ、各質問が単独で尋ねられた場合と同じ答えを受け取ることを保証します。このアプローチはスループットを大幅に向上させ、複雑な意思決定プロセスにおいて高い精度を維持します。

URLを訪問
共有
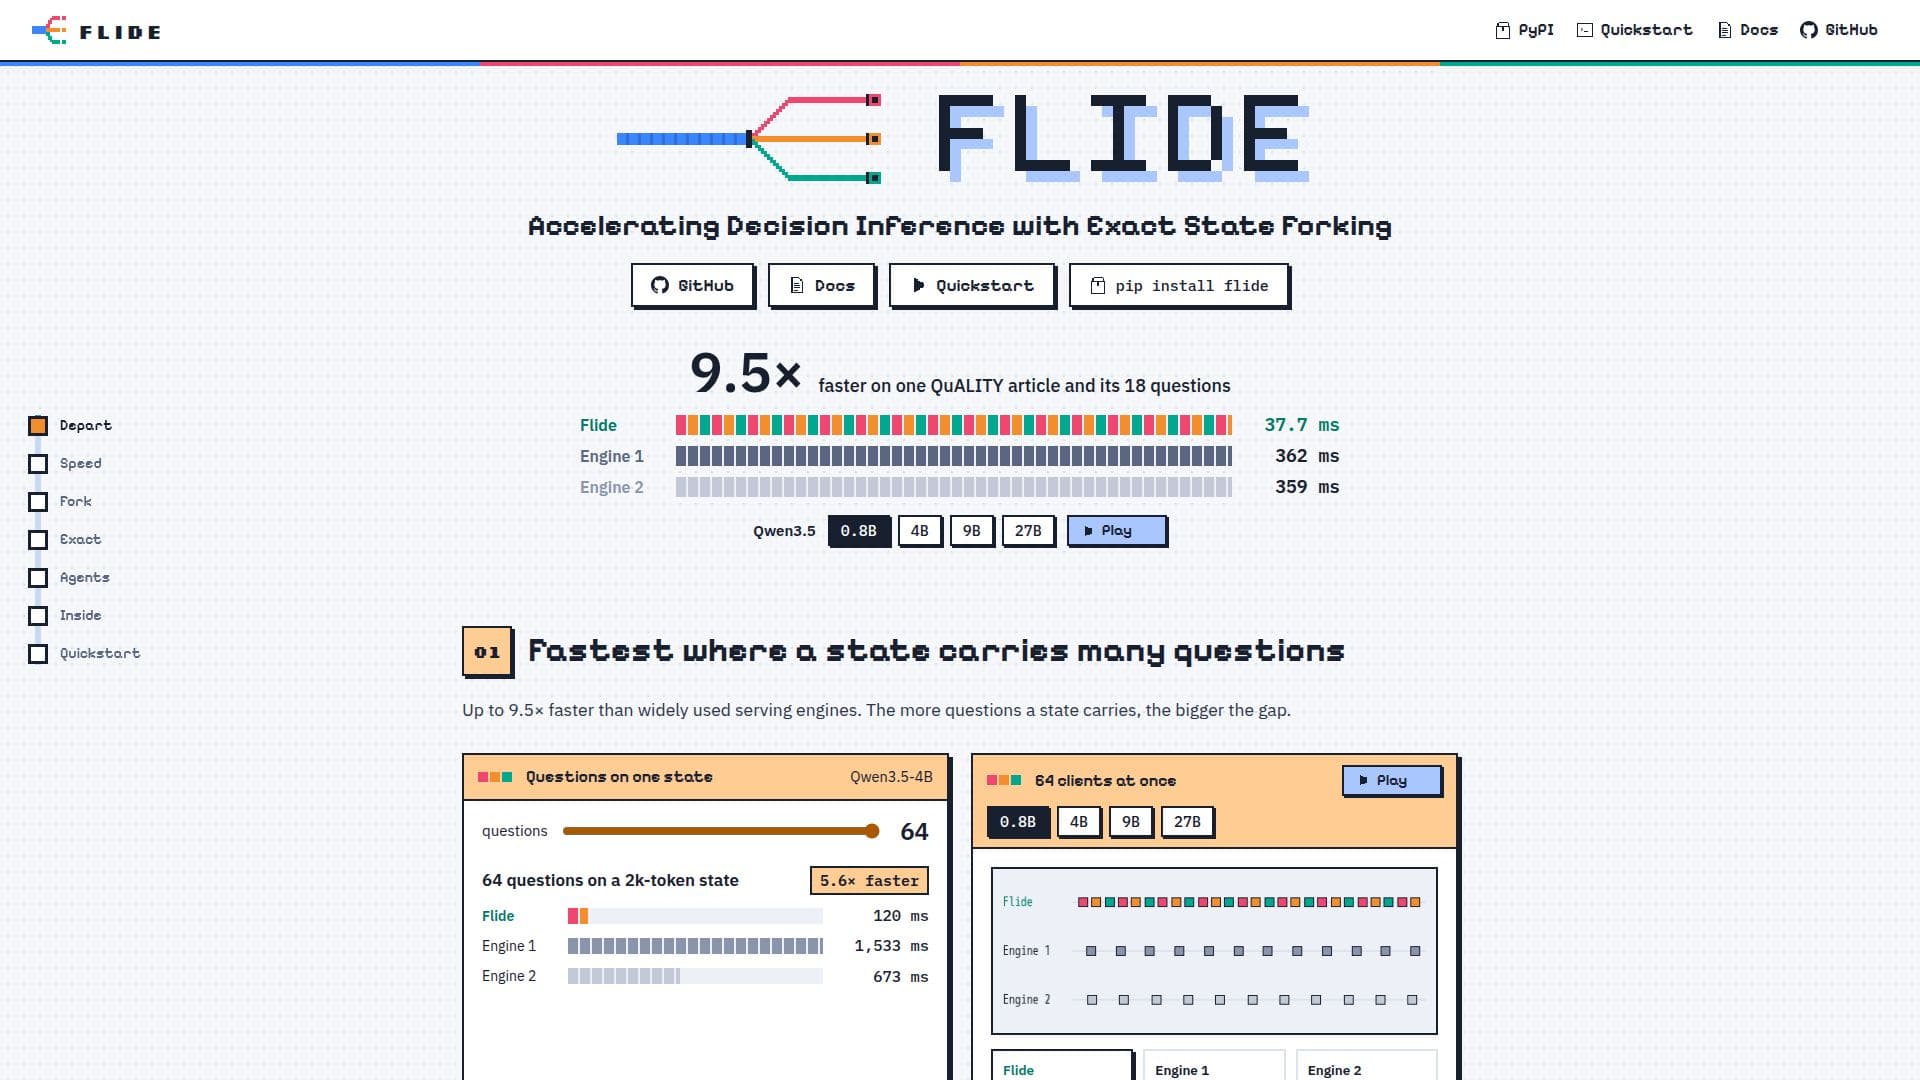
Flide のスクリーンショット
Flide のスクリーンショット

Flideは、Jevスタイルの意思決定モデルを加速するために特別に設計された高度な推論インフラストラクチャです。そのコアイノベーションは、正確な状態フォークを実行する能力にあり、単一の入力状態を1回のフォワードパスで複数の質問に対して処理できるようにします。これは、状態が1回だけ読み取られ、その後効率的にフォークされることを意味し、すべての質問が孤立して尋ねられた場合に得られる正確な答えを受け取ることを保証します。

続きを読む

このユニークなアーキテクチャは、FlideがvLLMやSGLangなどの広く使用されているサービングエンジンと比較して最大9.5倍の高速推論を実現するなど、実質的なパフォーマンス向上を提供します。特定の状態に関連する質問の数が増えるにつれて、パフォーマンスの利点はさらに顕著になります。たとえば、2kトークンの状態に64の質問がある場合、Flideは9.5倍のスピードアップと64クライアントでの2.2倍のスループットを達成します。

速度だけでなく、Flideは精度を優先し、float32リファレンスから1.1ポイント以内に留まり、真実のリファレンスに最も近いエンジンの1つとなっています。Flideは、Qwen3.5やGemma 4に基づくチャットモデル、OneJevモデルを含むさまざまなモデルをサポートしています。また、Gated DeltaNetレイヤーを使用して、各質問が共有コンテキストの正確な状態から始まることを保証するハイブリッドモデルも処理します。このシステムは、リクエストがバッチに関係なく同じビットを生成することを保証する`--batch-invariant`オプションを提供します。

インストールはpipを介して簡単に行え、NVIDIA A40、A10、RTX 30、H100、H200などのさまざまなGPU向けに事前構築されたカーネルをサポートしています。Flideは、vLLMやSGLangと同じ`/v1/systemone` APIを公開し、回答の各オプションに対する確率を提供します。テキスト、画像、ビデオなどのマルチモーダル入力をサポートし、バックボーンモデルに応じて処理します。Qwen3.5用のFP8量子化や、エージェントの状態を再開するためのセッションキャッシュなどの機能が、その能力をさらに向上させます。

  • カテゴリーMLOps・モデルデプロイ
  • デプロイセルフホスト
  • プラットフォームWeb

  • 正確な状態フォーク: 単一のフォワードパスで全ての質問に対して1つの状態を処理します。

  • 加速された推論: 他のサービングエンジンに比べて最大9.5倍の高速化を実現。

  • 高スループット: 特定のベンチマークで64クライアントで2.2倍のスループットを達成。

  • Float32リファレンスの近接性: 精度のためにfloat32リファレンスから1.1ポイント以内に留まります。

  • バッチ不変性: `--batch-invariant`を使用してバッチに関係なく一貫した結果を保証します。

  • フォークアテンションメカニズム: 各質問がまるで単独で尋ねられたかのようにその状態を読み取ります。

  • ハイブリッドモデルに対する正確性: Gated DeltaNetレイヤーをサポートし、正確なコンテキスト処理を実現します。

  • 1つのフラットストリーム処理: リクエストをCUDAグラフによって再生される単一のトークンストリームとして実行します。

  • vLLM/SGLang互換API: `/v1/systemone` API標準を使用します。

  • 事前構築されたカーネル: NVIDIA A40、A10、RTX 30、H100、H200 GPU向けに最適化されています。

  • モデルバックボーン: Qwen3.5(0.8B、2B、4B、9B、27B)およびGemma 4(E2B、E4B、12B、26B-A4B、31B)をサポートします。

  • マルチモーダル入力: テキスト、画像、ビデオ入力を処理します。

  • FP8量子化: Ada、Hopper、Blackwell GPU上でQwen3.5をFP8で実行します。

  • セッションキャッシュ: エージェントが再開できるように以前の状態を保持します(例: `--session-cache-gb 40`)。

  • フロントエンドプロセス: 多くのクライアントのためにHTTP、レンダリング、トークン化を別々のプロセスで実行することをサポートします。

  1. Flideをインストール: pipを使用してFlideパッケージをインストールします。

  2. サーバーを起動: `flide serve`を実行して推論サーバーを起動し、オプションで`--host`を指定します。

  3. モデルを構成: Qwen3.5やGemma 4のチャットモデルを直接提供するか、Open-Jevアダプターを統合します。

  4. リクエストを送信: `/v1/systemone` APIを使用して状態と質問を送信し、サーバーと対話します。

  5. マルチモーダル入力を処理: 状態に画像パスを含め、画像をサポートするモデルのためにメディアを送信します。

  • 加速された意思決定モデル
  • マルチモーダル推論
  • 一貫したバッチ処理
  • エージェント状態管理
  • 高性能LLMサービング
  • 研究開発

Flide のレビュー

読み込み中...

Flide に似た人気のAIツール

vLLM

AI アプリ

vLLMは、大規模言語モデル(LLM)のための高スループットかつメモリ効率の良い推論および提供エンジンです。これにより、最先端のパフォーマンスを持つAIモデルの迅速な展開が可能になり、さまざまな業界のユーザーにとってLLMの提供が簡単で迅速、かつコスト効率の良いものとなります。

MLOps・モデルデプロイ
ツールを見る

AI アプリ

大規模言語モデル(LLM)のための高スループットかつメモリ効率の良い推論および提供エンジンです。これにより、最先端のパフォーマンスを持つAIモデルの迅速な展開が可能になり、さまざまな業界のユーザーにとってLLMの提供が簡単で迅速、かつコスト効率の良いものとなります。vLLMは、大規模言語モデル(LLM)のための高スループットかつメモリ効率の良い推論および提供エンジンです。これにより、最先端のパフォーマンスを持つAIモデルの迅速な展開が可能になり、さまざまな業界のユーザーにとってLLMの提供が簡単で迅速、かつコスト効率の良いものとなります。

MLOps・モデルデプロイ
AI アプリ トップ250を見る

一般計算

AI アプリ

特別に設計されたASICインフラストラクチャ上でモデルを提供する高速AI推論プロバイダーで、OpenAI互換のAPIを通じて、コーディングエージェントやリアルタイム音声などのレイテンシに敏感なワークロードに対して低いファーストトークン時間と高いスループットを提供します。

MLOps・モデルデプロイ
ツールを見る

AI アプリ

特別に設計されたASICインフラストラクチャ上でモデルを提供する高速AI推論プロバイダーで、OpenAI互換のAPIを通じて、コーディングエージェントやリアルタイム音声などのレイテンシに敏感なワークロードに対して低いファーストトークン時間と高いスループットを提供します。

MLOps・モデルデプロイ
AI アプリ トップ250を見る

Inference.net

AI アプリ

Inference.netは、AIネイティブチームがAIワークロードを実行、監視、最適化するためのインフラストラクチャを提供します。オープンソース、カスタム、ファインチューニングされたモデルに対して、低コストで高速な推論を実現し、大規模なスケールでの処理を可能にします。

MLOps・モデルデプロイ

AIモデルの微調整で第78位

ツールを見る

AI アプリ

AIネイティブチームがAIワークロードを実行、監視、最適化するためのインフラストラクチャを提供します。オープンソース、カスタム、ファインチューニングされたモデルに対して、低コストで高速な推論を実現し、大規模なスケールでの処理を可能にします。Inference.netは、AIネイティブチームがAIワークロードを実行、監視、最適化するためのインフラストラクチャを提供します。オープンソース、カスタム、ファインチューニングされたモデルに対して、低コストで高速な推論を実現し、大規模なスケールでの処理を可能にします。

MLOps・モデルデプロイ
AIモデルの微調整で第78位

Jev AI

AI アプリ

Jev AIは、ソフトウェアチーム向けの意思決定インテリジェンスツールで、待機リストなしで迅速なAIモデルを提供します。実世界の状態を構造化された確率に基づく意思決定に変換し、効率的な分類、ルーティング、スコアリング、安全チェックを可能にします。

AI DevOps・クラウドツール
ツールを見る

AI アプリ

ソフトウェアチーム向けの意思決定インテリジェンスツールで、待機リストなしで迅速なAIモデルを提供します。実世界の状態を構造化された確率に基づく意思決定に変換し、効率的な分類、ルーティング、スコアリング、安全チェックを可能にします。Jev AIは、ソフトウェアチーム向けの意思決定インテリジェンスツールで、待機リストなしで迅速なAIモデルを提供します。実世界の状態を構造化された確率に基づく意思決定に変換し、効率的な分類、ルーティング、スコアリング、安全チェックを可能にします。

AI DevOps・クラウドツール
AI アプリ トップ250を見る

JevModel

AI アプリ

JevModelは、選択、スコア、Noul出力を提供する構造化AI意思決定のためのJevモデルを使用するプラットフォームです。ユーザーはテキストやJSONをテストし、意思決定フローを構築し、バッチ処理を行い、シームレスな統合のためにAPIにアクセスできます。

機械学習プラットフォーム
ツールを見る

AI アプリ

選択、スコア、Noul出力を提供する構造化AI意思決定のためのJevモデルを使用するプラットフォームです。ユーザーはテキストやJSONをテストし、意思決定フローを構築し、バッチ処理を行い、シームレスな統合のためにAPIにアクセスできます。JevModelは、選択、スコア、Noul出力を提供する構造化AI意思決定のためのJevモデルを使用するプラットフォームです。ユーザーはテキストやJSONをテストし、意思決定フローを構築し、バッチ処理を行い、シームレスな統合のためにAPIにアクセスできます。

機械学習プラットフォーム
AI アプリ トップ250を見る

Morph

AI アプリ

コーディングエージェント向けに構築された推論プラットフォームで、高速フロンティアモデルとコード検索、編集の適用、コンテキスト圧縮、監視のための専門モデルを提供し、1つのOpenAI互換APIを通じて利用できます。

MLOps・モデルデプロイ
ツールを見る

AI アプリ

コーディングエージェント向けに構築された推論プラットフォームで、高速フロンティアモデルとコード検索、編集の適用、コンテキスト圧縮、監視のための専門モデルを提供し、1つのOpenAI互換APIを通じて利用できます。

MLOps・モデルデプロイ
AI アプリ トップ250を見る

vLLM

AI GitHub リポジトリ

vllm-project/vllmは、大規模言語モデル(LLM)向けに設計された高スループットかつメモリ効率の良い推論および提供エンジンです。リソース使用を最小限に抑えつつパフォーマンスを最適化し、AIや機械学習のさまざまなアプリケーションに適しています。

MLOps・モデルデプロイ

AI GitHub リポジトリで第23位

ツールを見る

AI GitHub リポジトリ

大規模言語モデル(LLM)向けに設計された高スループットかつメモリ効率の良い推論および提供エンジンです。リソース使用を最小限に抑えつつパフォーマンスを最適化し、AIや機械学習のさまざまなアプリケーションに適しています。vllm-project/vllmは、大規模言語モデル(LLM)向けに設計された高スループットかつメモリ効率の良い推論および提供エンジンです。リソース使用を最小限に抑えつつパフォーマンスを最適化し、AIや機械学習のさまざまなアプリケーションに適しています。

注目MLOps・モデルデプロイ
AI GitHub リポジトリで第23位

trnrt

AI GitHub リポジトリ

trnrtは、AWS Trainium向けに設計されたオープンソースのLLM推論エンジンで、NKIメガカーネルを提供し、1Mトークンのコンテキストをサポートします。RunAnywhereによって開発され、OpenAI互換のAPIを提供し、特化したAWSハードウェア上で効率的かつスケーラブルな大規模言語モデルの展開を可能にします。このプロジェクトは、開発者や組…

MLOps・モデルデプロイ

MLOps・モデルデプロイで第160位

ツールを見る

AI GitHub リポジトリ

AWS Trainium向けに設計されたオープンソースのLLM推論エンジンで、NKIメガカーネルを提供し、1Mトークンのコンテキストをサポートします。RunAnywhereによって開発され、OpenAI互換のAPIを提供し、特化したAWSハードウェア上で効率的かつスケーラブルな大規模言語モデルの展開を可能にします。このプロジェクトは、開発者や組…trnrtは、AWS Trainium向けに設計されたオープンソースのLLM推論エンジンで、NKIメガカーネルを提供し、1Mトークンのコンテキストをサポートします。RunAnywhereによって開発され、OpenAI互換のAPIを提供し、特化したAWSハードウェア上で効率的かつスケーラブルな大規模言語モデルの展開を可能にします。このプロジェクトは、開発者や組…

MLOps・モデルデプロイ
MLOps・モデルデプロイで第160位
1 / 8