説明
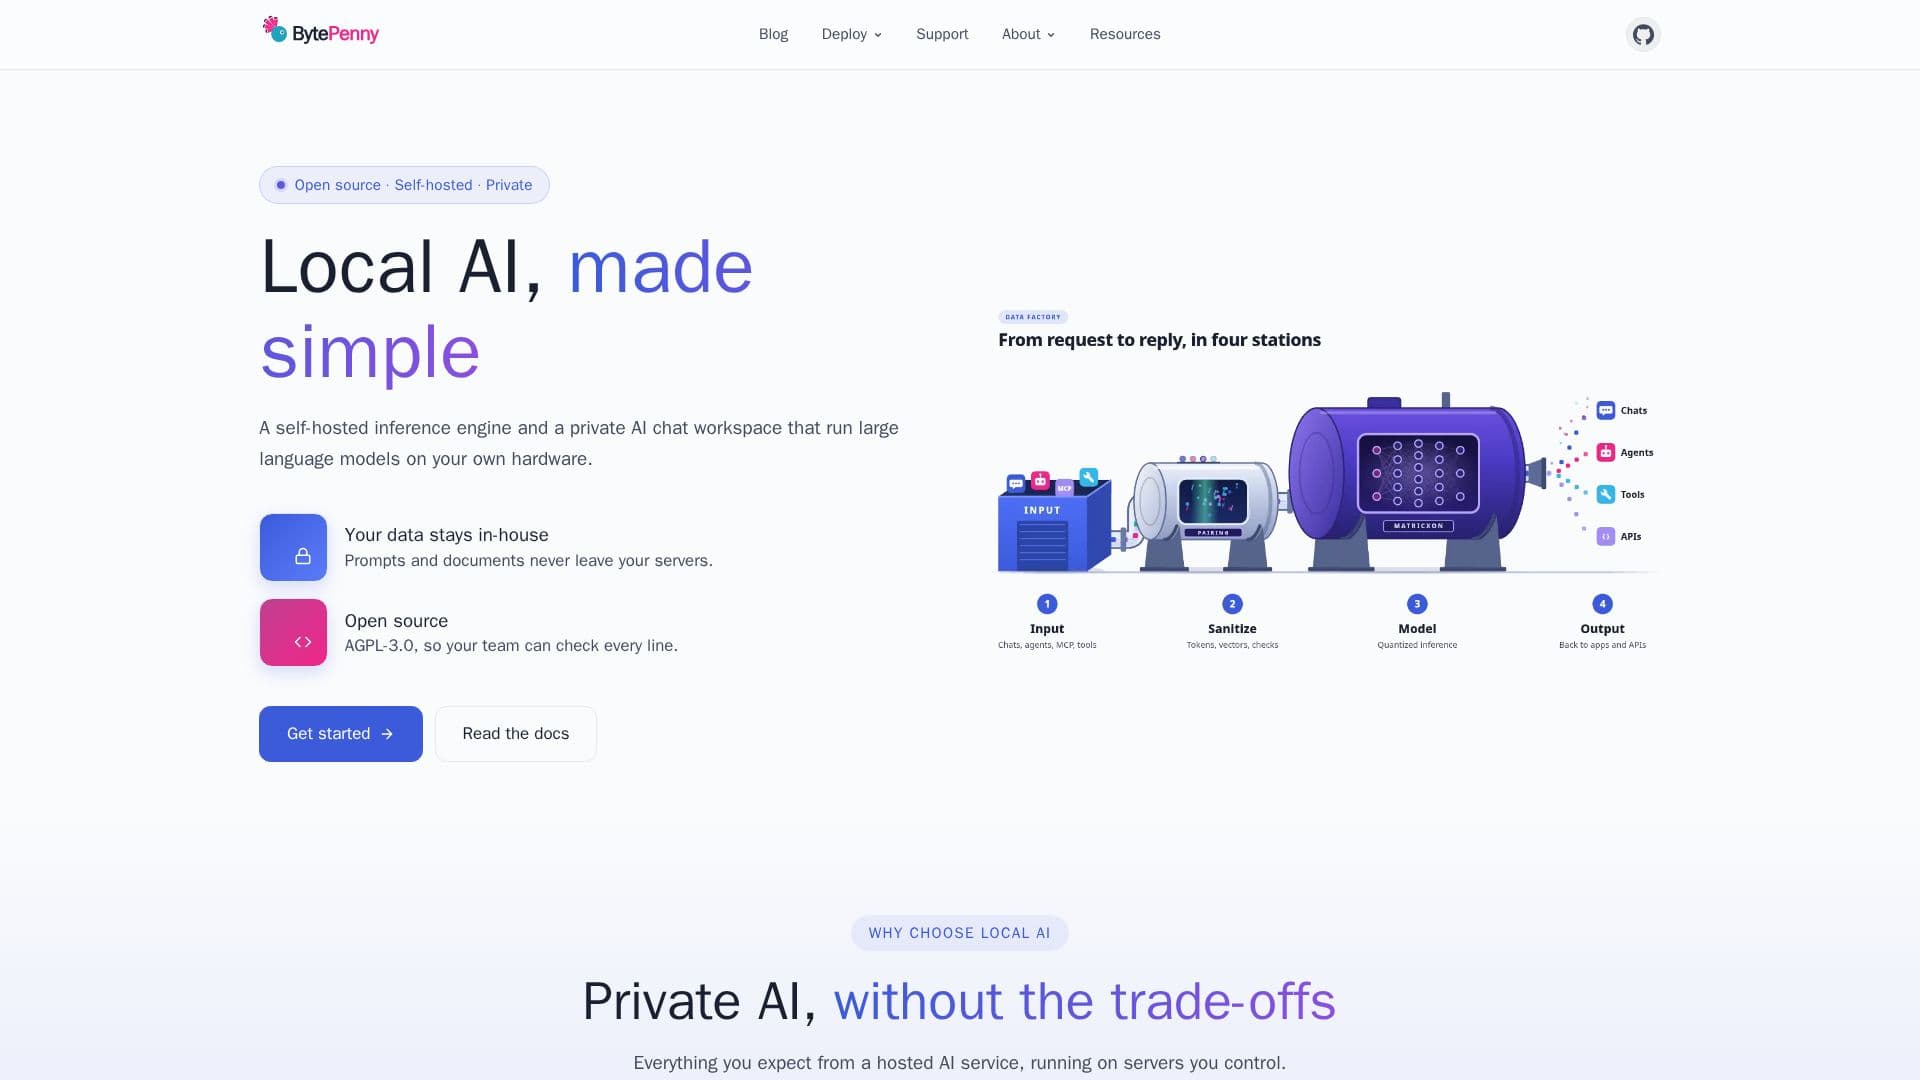
BytePennyは、プライバシーとコントロールを重視したオープンソースの自己ホスト型AIツールの包括的なスイートを提供します。コアの提供物には、オープンソースのGGUF推論エンジンであるMatricxonと、チーム向けに特化したプライベートAIチャットワークスペースであるpAIringが含まれています。これらの製品により、組織は自社のハードウェア上で大規模言語モデルを直接実行でき、プロンプト、ドキュメント、チャットデータがサーバーを離れることはありません。
続きを読む
このプラットフォームはデータプライバシーを強調し、すべての機密情報を社内に保持するために完全オフラインで動作します。Hugging Face、llama.cpp、またはMatricxonエンジンなどのさまざまなGGUFモデルをサポートし、MCPツールサーバーと統合できます。BytePennyはオープンソースの哲学に基づいて構築されており、AGPL-3.0ライセンスを使用しているため、チームはすべてのコード行を検査および変更でき、透明性と信頼を促進します。
推論エンジンであるMatricxonは、PythonとPyTorchで書かれた軽量で可読性の高いLLMランタイムであり、パフォーマンスを向上させるためのネイティブCカーネルを備えています。チャット、テキスト生成、埋め込み、再ランキング、視覚と言語のモデル、時系列予測などのタスクに対してGGUFモデルをサポートし、HTTP APIを介して提供します。CPU上で効率的に動作し、NVIDIA GPUのBETAサポートを提供し、AMDおよびApple Silicon GPUへの拡張計画があります。Matricxonは、pAIring UIから管理される複数のノード間で共有モデルとチャットキャッシュのためのクラスターモードもサポートしています。
プライベートAIチャットワークスペースであるpAIringは、チームのコラボレーションのために設計されており、役割ベースのアクセス、共有チャンネル、統合されたナレッジベースなどの機能を提供します。暗号化されたチャットキャッシュを提供し、プロンプトがモデルのトレーニングに使用されることはありません。このシステムはスケーラブルであり、ユーザーは単一のサーバーから始め、ノードを追加して負荷分散とフェイルオーバー機能を持つ拡張が可能です。より多くのパワーが必要なシナリオでは、pAIringはBedrock、Vertex AI、Azure OpenAI、Gemini、Groqなどのさまざまなクラウドプロバイダーに接続でき、ローカルとクラウドエンジンを組み合わせる柔軟性を提供します。
BytePennyはトークンごとの請求を排除し、組織が既存のハードウェアを活用し、使用量が増加してもコストを一定に保つことができます。全体のスタックはオープンであるように設計されており、AGPL-3.0コードからオープンウェイトモデルまで、プライベートおよびクローズドネットワークに最適です。セキュリティは最も重要な懸念事項であり、bcryptハッシュ化されたパスワード、暗号化された保存された秘密、AES-256-GCMで暗号化されたチャットキャッシュ、管理者アクションのためのサーバーサイドの役割チェックなどの機能があります。MatricxonとpAIringの両方は、OpenSSFベストプラクティスの「合格」バッジを取得しており、安全な開発プラクティスへのコミットメントを示しています。
- カテゴリーMLOps・モデルデプロイ
- 料金モデルOpen Source (AGPL-3.0), No Per-Token Bills
- デプロイSelf-Hosted, On-Premise, Cloud (Hybrid)
- プラットフォームWindows, Linux
BytePennyの主要機能
自己ホスト型AI推論エンジン(Matricxon)
チーム向けのプライベートAIチャットワークスペース(pAIring)
自社のハードウェア上で大規模言語モデルを実行
データは社内に留まり、プロンプトやドキュメントはサーバーを離れない
AGPL-3.0ライセンスのオープンソース
完全オフラインで動作
AES-256-GCMによる暗号化されたチャットキャッシュ
チーム向けの役割ベースのアクセス
プロンプトはモデルのトレーニングに使用されない
Hugging Face、llama.cpp、MatricxonからのGGUFモデルをサポート
CPUおよびNVIDIA GPUサポートのための量子化カーネル
トークンごとの請求なし;使用量の増加に伴う一定のコスト
スケーラブルなデプロイメント:単一ノード、共有クラスター、または別々のサーバー
12以上のクラウドプロバイダー(Bedrock、Vertex AI、Azure OpenAI、Gemini、Groqなど)に接続
可読性とカスタマイズ性のためにPythonでゼロから書かれた
BytePennyの使い方は?
BytePennyをデプロイ:自社のサーバーまたはクラウドインフラストラクチャにMatricxonとpAIringをインストールします。
推論エンジンを設定:Matricxonをローカル推論エンジンとして設定するか、pAIringを希望するクラウドプロバイダーに接続します。
モデルを追加:Hugging Faceや他のソースからGGUFモデルを統合するか、コネクタを介してクラウドホストされたモデルを利用します。
ユーザーとチームを管理:役割ベースのアクセスを設定し、共有チャンネルを作成し、pAIring内にナレッジベースを確立します。
チャットを開始:プライベートAI会話を始め、チームコラボレーションのためにナレッジベースを活用します。
監視とスケール:システムの状態を観察し、クラスターのノードを管理し、使用量が増加してもトークンごとのコストをかけずにハードウェアを拡張します。
BytePennyの使用例
- プライベートチームチャット
- ローカルLLM推論
- セキュアなドキュメント分析
- コスト管理されたAI操作
- オフラインAIワークフロー
- カスタムモデルのデプロイ
- スケーラブルなAIインフラストラクチャ
- オープンソースAI開発