説明
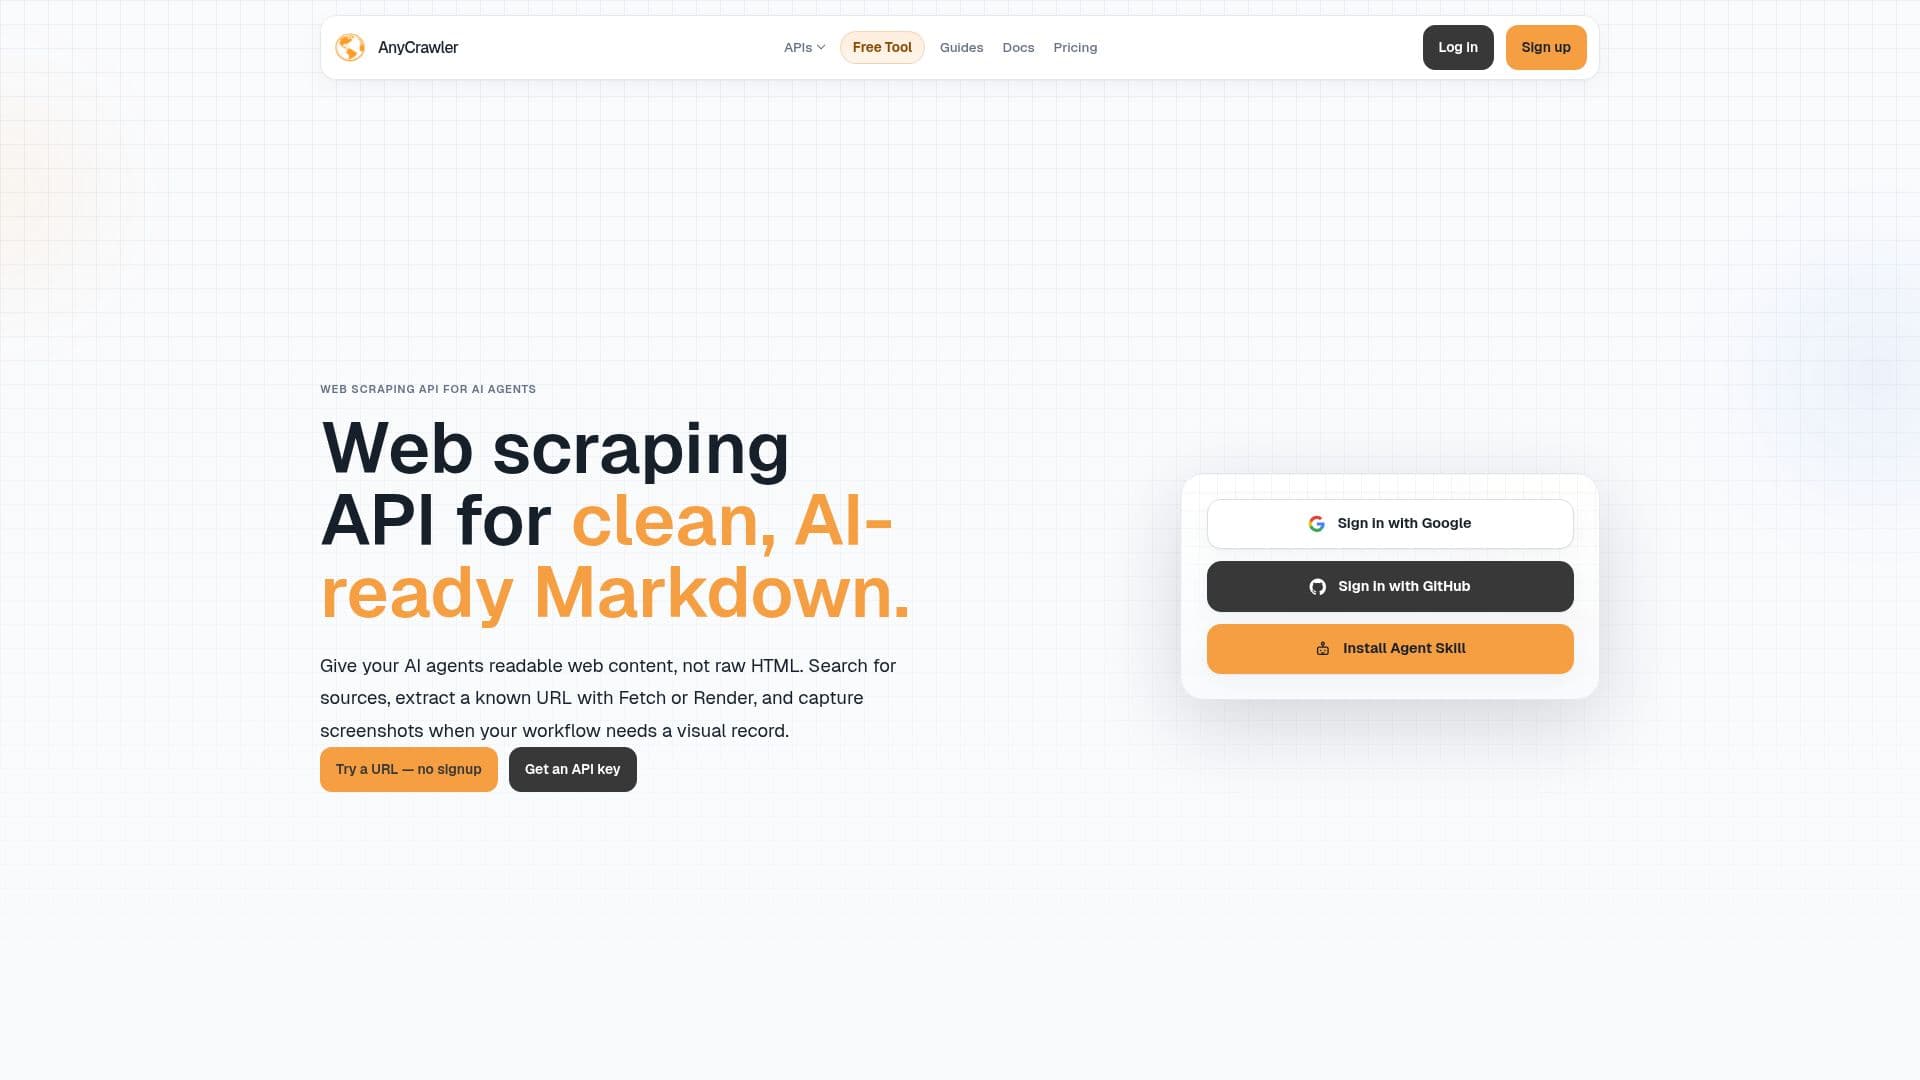
AnyCrawlerは、AIエージェント、RAGシステム、研究ツール、監視製品、自動化ワークフロー向けに特別に設計された包括的なウェブスクレイピングAPIを提供します。これは、ユーザーが検索、クロール、ブラウザレンダリング、パース、使用制御のために別々のシステムを管理する必要を排除し、最新のウェブデータにアクセスするための統一されたソリューションを提供します。このAPIは、ソースURLの検索、HTMLファーストページの取得、ブラウザでのJavaScript重視のページのレンダリング、クリーンなMarkdownの抽出、ページのスクリーンショットキャプチャなど、さまざまな操作をサポートしています。
続きを読む
このプラットフォームは、AIエージェントに生のHTMLではなく、読みやすいウェブコンテンツを提供するように設計されています。ユーザーは、コンテンツが初期HTMLで利用可能か、JavaScriptの実行が必要かに基づいて、FetchモードとRenderモードのいずれかを選択できます。両方のモードは構造化されたMarkdown出力を返し、次のAI処理ステップの一貫性を確保します。さらに、AnyCrawlerには、候補ページ、ニュース、画像、動画、学術的なソースを発見するためのウェブ検索APIが含まれており、ユーザーはさらに抽出またはスクリーンショットワークフローのために最も関連性の高い結果をフィルタリングして選択できます。
AnyCrawlerは、異なるウェブアクセスタスクに明示的なクレジットコストがかかる柔軟なクレジットベースの請求システムで運営されています。このモデルにより、チームはフラットな価格構造に制約されることなく、効率的に機能を組み合わせることができます。たとえば、検索、取得、レンダリング、スクリーンショット操作にはそれぞれ異なるクレジット値があり、ユーザーは実行された作業に対してのみ支払うことが保証されます。このサービスは、5,000の一回限りのクレジットを含む無料プランも提供しており、ユーザーはすぐにクロールを開始し、ワークフローを検証できます。
開発者とチーム向けに構築されたAnyCrawlerは、安定したAPIエンドポイント、明確なレスポンス形式、APIキー、使用ログを提供し、プロトタイプから本番環境へのスムーズな移行を促進します。これは、検索、クロール、レンダリング、スクリーンショット、構造化出力のための管理されたレイヤーを提供し、AIエージェントへのライブウェブアクセスの統合を簡素化することを目指しています。これにより、カスタムブラウザインフラの開発の必要性が減少します。
- カテゴリーWebスクレイピングとデータ抽出
- 料金モデルフリーミアム
- デプロイクラウド
- プラットフォームWeb
AnyCrawlerの主要機能
AIエージェント向けのウェブスクレイピングAPI
ソースURLの検索
HTMLファーストページの取得
JavaScriptページのレンダリング
クリーンなMarkdown出力の抽出
ページのスクリーンショットキャプチャ
柔軟なクレジットベースの請求
APIキーとリクエストログ
使用制御
AIワークフロー向けの構造化出力
RAGシステムをサポート
開発者向けのAPIドキュメント
5,000クレジットの無料プラン
複数の価格プランが利用可能
ブラウザ同時実行スロット
AnyCrawlerの使い方は?
サインアップ: アカウントを作成して5,000の無料クレジットを取得し、APIにアクセスします。
操作の選択: ウェブデータのニーズに基づいて、検索、取得、レンダリング、またはスクリーンショットのいずれかを選択します。
APIの統合: 提供されたAPIキーとドキュメントを使用して、AnyCrawlerをアプリケーションまたはAIエージェントに統合します。
リクエストの送信: URLを検索したり、コンテンツを抽出したり、スクリーンショットをキャプチャするためにAPIコールを行います。
出力の処理: AIワークフローやデータ製品のために準備されたクリーンなMarkdownまたはPNG画像を受け取ります。
使用状況の監視: アカウントダッシュボードを通じてクレジット消費を追跡し、APIキーを管理します。
ワークフローのスケーリング: ニーズが増えるにつれて、より高い月間クレジットとスループットを得るために有料プランにアップグレードします。
AnyCrawlerの使用例
- AIエージェントのウェブアクセス
- RAGシステムのデータソーシング
- 研究ツールの開発
- 監視製品
- 自動化ワークフロー
- コンテンツ抽出
- 視覚的証拠のキャプチャ
- ウェブ発見