説明
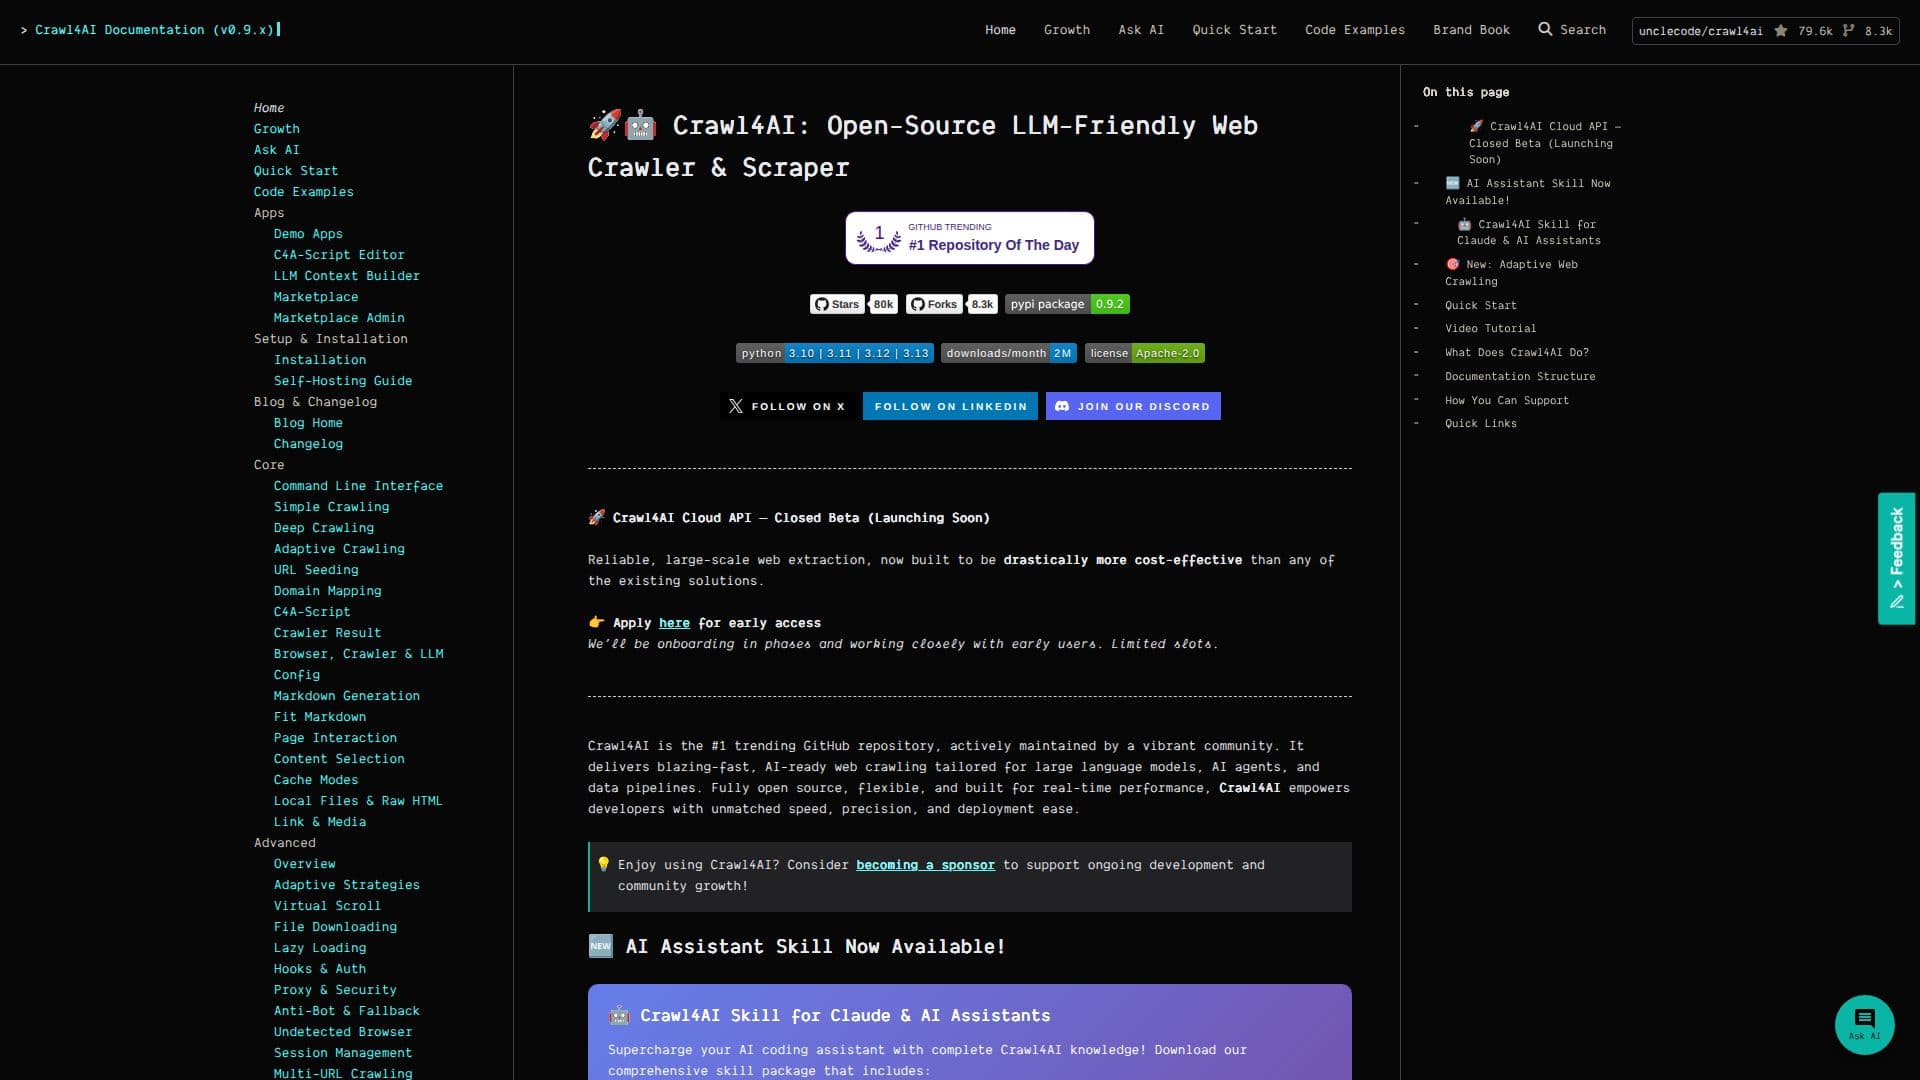
Crawl4AIは、開発者がウェブからデータを効率的に抽出できるようにするオープンソースのLLMフレンドリーなウェブクローラーおよびスクレイパーです。大規模言語モデルやAIエージェント向けに構築されており、コスト効率が高く、展開が容易なウェブ抽出の信頼できるソリューションを提供します。
続きを読む
このプラットフォームは活気あるコミュニティによって積極的にメンテナンスされており、#1トレンドのGitHubリポジトリとして認識されています。Crawl4AIは驚異的なパフォーマンスを誇り、リアルタイムアプリケーションに最適化されているため、データパイプラインにウェブスクレイピングを統合したい開発者にとって理想的な選択肢です。
Crawl4AIの際立った機能の一つは、クリーンなMarkdownを生成する能力です。これは、情報強化生成(RAG)パイプラインやLLMへの直接的な取り込みに最適です。CSS、XPath、またはLLMベースの抽出方法を使用して、繰り返しパターンを解析するための構造化された抽出をサポートしています。さらに、Crawl4AIはフック、プロキシ、ステルスモード、セッション再利用などの機能を備えた高度なブラウザ制御を提供し、クローリングプロセスに対する細かな制御を可能にします。
Crawl4AIはまた、十分な情報が収集されたかどうかを判断するために高度な情報採集アルゴリズムを利用するインテリジェントな適応クローリングを導入しています。この機能は、不必要なリクエストを最小限に抑えることでデータ収集の効率を向上させます。
ドキュメントはよく構成されており、セットアップ、インストール、および高度な機能に関する明確なセクションを提供しています。ユーザーは、迅速に始めるためのハンズオンガイド、コードサンプル、およびリファレンスを見つけることができます。このプラットフォームはコミュニティの参加を奨励しており、ユーザーはプルリクエストを通じて貢献したり、問題を報告したり、Discordでの議論に参加したりできます。
Crawl4AIの使命は、データアクセスを民主化し、無料で使用できるようにし、高度に構成可能にすることです。学生、研究者、起業家、データサイエンティストが、スピードと創造的自由を持って世界のデータにアクセスし、解析し、形作ることを可能にすることを目指しています。
- カテゴリーWebスクレイピングとデータ抽出
- 料金モデル無料
- デプロイクラウド
- プラットフォームクロスプラットフォーム
Crawl4AIの主要機能
オープンソース
LLMフレンドリー
適応クローリング
構造化抽出
高度なブラウザ制御
高パフォーマンス
リアルタイムユースケース
強制APIキーなし
Crawl4AIの使い方は?
設定: pipまたはDockerを使用してCrawl4AIをセットアップします。
使用: 提供された例を使用して最初のクローリングを開始します。
抽出: データ解析のために構造化抽出方法を利用します。
最適化: 適応クローリングやセッション持続性などの高度な機能を実装します。
Crawl4AIの使用例
- データ抽出
- ウェブスクレイピング
- 研究
- AIトレーニング
- コンテンツ集約